

AIエージェントの台頭に伴って、私は気づいたのですが、本当の競争は「より賢い知能を作ること」ではないのかもしれません。より大きな課題は、その知能を人間がいかに効果的に連携し、やり取りするかを見極めることのように思えます。
だからこそ、OpenLedgerとSpectralの比較が、モデルや性能、あるいはトークン経済をめぐる通常の議論よりもずっと興味深く感じられます。どちらのプロジェクトもAIインフラに取り組んでいるようですが、着目点はまったく異なっています。
これまでの技術サイクルを振り返ると、人々はしばしば最も目に見える層に注目します。インターネットはかつてウェブサイトの集合として見られ、ブロックチェーンはトークンのネットワークとして捉えられ、AIは今日ではしばしばチャットボットにまで単純化されます。けれども、最も変革的な変化は通常、表面の下――ユーザーがほとんど気づかないインフラの中で起こります。
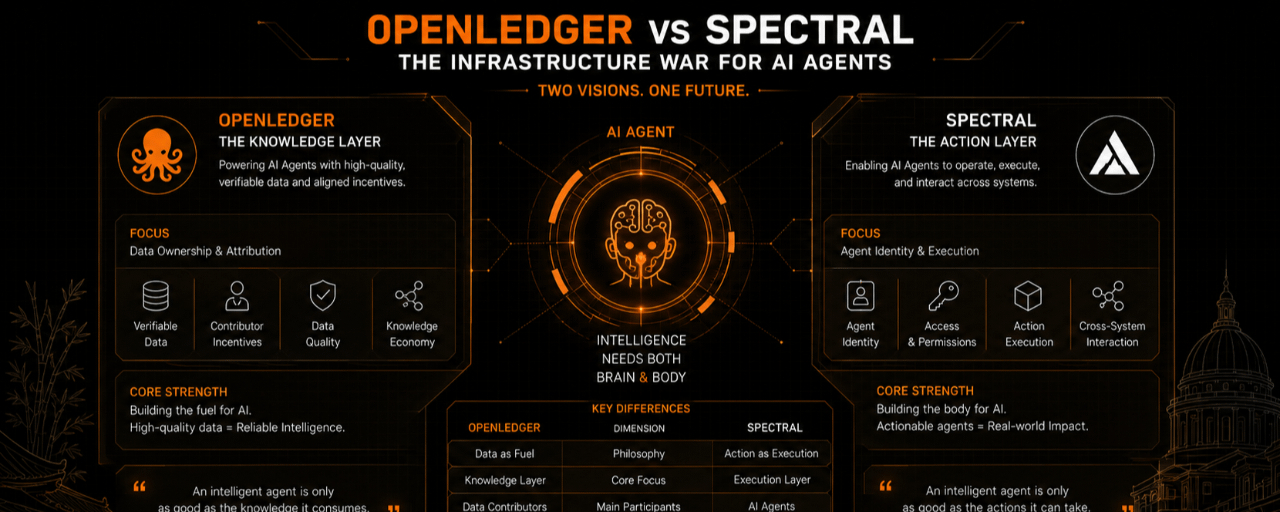
OpenLedgerは、AIの最大の制約はモデルの不足ではなく、高品質で専門的なデータの不足だという考えから始まっているように見えます。その観点では、AIエージェントの課題は推論よりも、知識の質と出どころにあります。
最も高度なエージェントであっても、ノイズが多く信頼できず、あるいは十分にインセンティブが設計されていないデータに依存していれば、結果は悪くなりえます。知性だけでは弱い入力を補えません。
OpenLedgerで際立っているのは、データの貢献と所有に関する経済的インセンティブを作り出そうとしている点です。多くの点で、それはAIの「燃料」の層に取り組んでいるように見えます。
一方でSpectralは、まったく別の問題に焦点を当てているようにも見えます。つまり「実行」です。
AIエージェントが進化するにつれ、ユーザーに代わって行動することが期待されます。そうするために必要なのは、アイデンティティ、権限、行動に関する文脈、そして異なるシステムや環境をまたいでやり取りする能力です。
OpenLedgerがAIを、知識を必要とする「脳」と見なしているのに対し、SpectralはAIを、動作するためのツールと自律性を必要とするデジタルな存在として見ているように思えます。
一見するとこれらのアプローチは似ているように見えるかもしれませんが、本質的には未来についての2つのまったく異なるビジョンを反映しています。ひとつは認知の質を優先し、もうひとつは実行能力を優先します。
これは、技術における見慣れた逆説を浮き彫りにします。私たちはしばしば、良い判断が自然に良い結果につながると考えますが、実際には「何をすべきかを知っている」ことと「実際にそれを実行する」ことのギャップのせいで、多くのシステムが失敗します。
AIエージェントは正しい行動方針を理解できても、それを実行するのが難しいかもしれません。逆に、エージェントが豊富な運用能力を持っていても、正しい判断を下すために必要な十分な理解が欠けている可能性があります。
おそらく、これはAIエージェントの領域で生まれつつある中核的な緊張関係です。
レースの本質は、最も賢いエージェントを作ることではないのかもしれません。むしろ、それが現実世界の環境で、知性を本当に役に立つものにするためのインフラを作ること――それが争点なのかもしれません。
私を惹きつけるのは、OpenLedgerもSpectralも、ほとんどのユーザーが気づかない層に取り組んでいる点です。歴史的に、そうした隠れた層こそが、最も重要な技術的な転換が始まる場所であることが多いのです。
インターフェースではありません。
機能ではありません。
しかし、人々の考え方、判断、行動を静かに形作る基盤システムの奥深くでは。
将来は、データの所有権と知識の帰属を解決するプラットフォームが有利になるのでしょうか。それとも、エージェントが行動をより効果的に実行できるようにする側が有利になるのでしょうか?
現時点では、答えはまだ不確かなままです。
AIエージェントは、単なる「脳」以上のものを必要とするかもしれません。
彼らは体も必要かもしれません。
そして市場はいまも、それらのどちらがより大きなボトルネックなのかを見極めようとしています。