

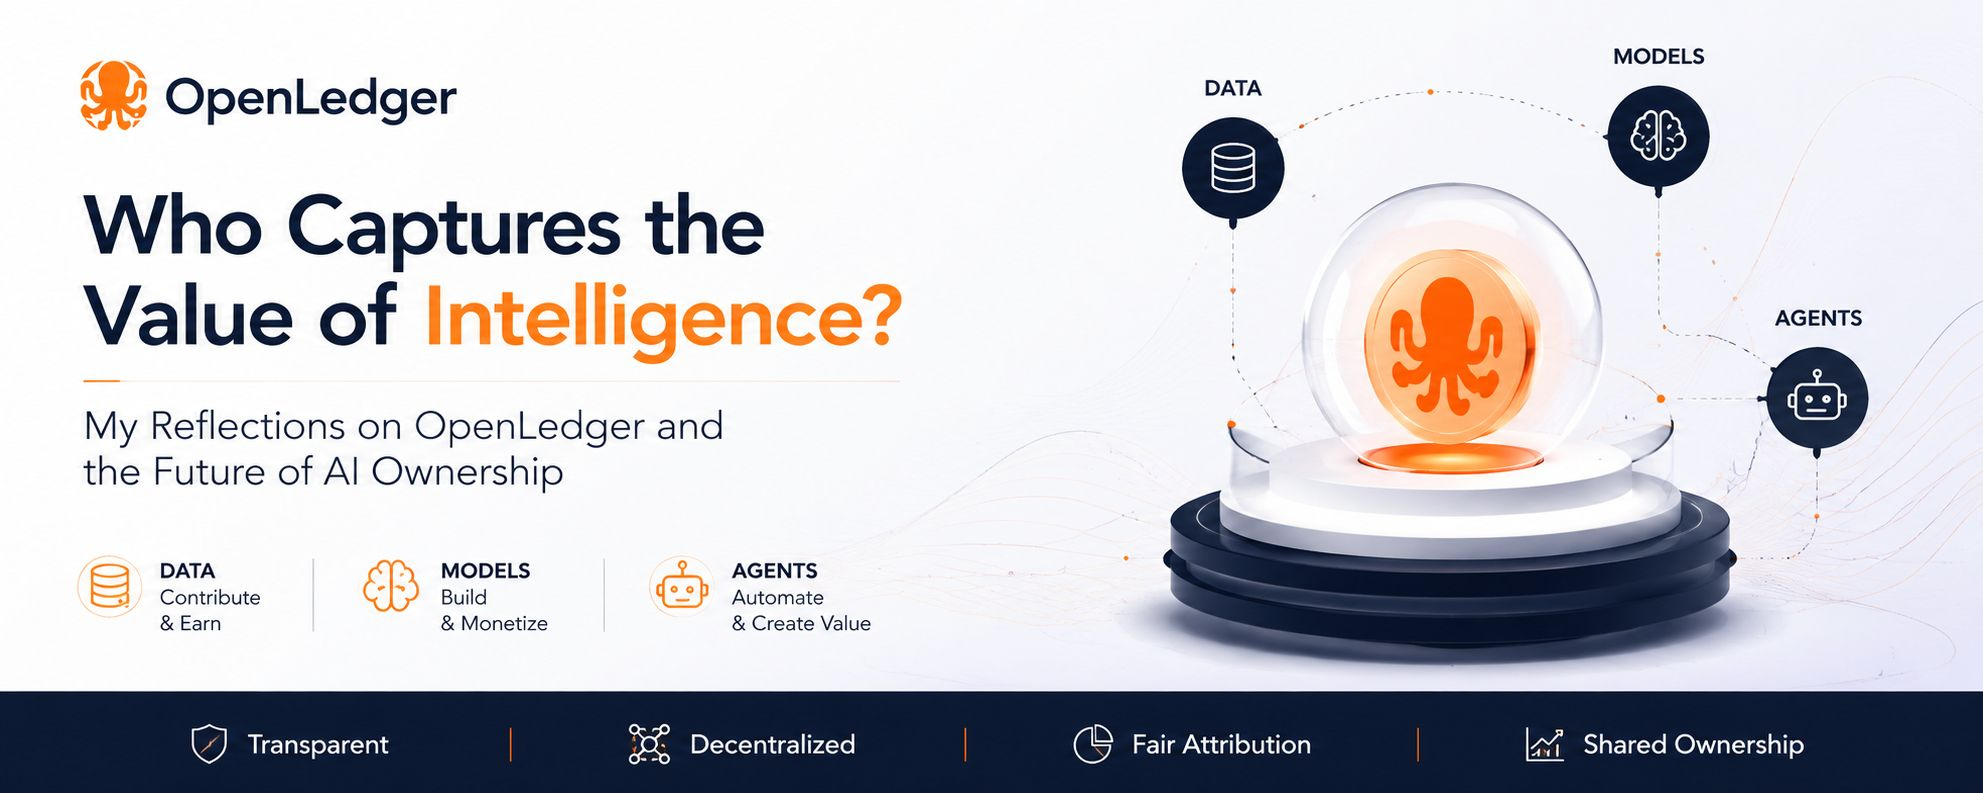

OpenLedgerを見ていると、ブロックチェーンのことを考えるよりも、デジタル経済の裏で静かに成長している問題について考えてしまいます。
データが世界で最も価値のあるリソースの一つになったポイントに達したと思いますが、それを作り出す人々とそれから利益を得る人々との関係は驚くほど断絶しています。毎日、人々は会話、アプリケーション、取引、検索、オンライン活動を通じて膨大な情報を生成しています。そのデータはAIシステムを駆動し、モデルを改善し、企業がますます強力な製品を構築するのを助けています。しかし、ほとんどの貢献者は自分の貢献から生まれる価値に参加することはほとんどありません。
私が興味を持つのは、この不均衡は誰かが意図的にそのように設計した結果ではなかったということだ。多くの点で、それはインターネットが進化した結果に過ぎない。中央集権的なプラットフォームは、情報を収集し、整理し、マネタイズする効率的な場所になった。時間が経つにつれて、データの所有権、インフラの所有権、価値の獲得が同じ場所に集中するようになった。
人工知能がますます重要になるにつれて、この問題は無視できないほど難しくなると思う。
AIモデルは膨大なデータセットに依存している。それらのデータセットは数え切れないほどの個人、ビジネス、アプリケーション、システムから来ている。モデル開発者は専門知識と革新を提供する。ユーザーはパフォーマンスを改善するフィードバックを提供する。しかし、参加者の数にもかかわらず、経済的な構造は驚くほど狭く感じることが多い。
このスペースを勉強すればするほど、挑戦は技術的なだけではないと感じる。それは経済的でもある。
もはや、単により良いAIを構築する方法ではない。人々、データ、モデル、エージェントを公正に調整するシステムを構築する方法が問われているのだ。
ここでOpenLedgerが私の注意を引いた。
モデルのパフォーマンスや計算能力にのみ焦点を当てるのではなく、OpenLedgerがより深い構造的問題に取り組もうとしているのが見える。このプロジェクトは比較的シンプルなアイデアから始まるようだ:データ、AIモデル、そして自律エージェントが生産的なデジタル資産になっているなら、貢献を追跡し、価値をより透明に分配できるインフラが必要かもしれない。
この視点は面白いと思う。なぜなら、純粋な技術からインセンティブ設計へと会話がシフトするからだ。
ほとんどのAIの議論では、データは原材料として扱われる。それはシステムに入って、トレーニングに貢献し、その後ほとんど視界から消えてしまう。元の貢献者と、そのデータによって生み出される未来の価値との間の関係は、しばしば測定不可能になる。
OpenLedgerは代替的アプローチを探っているようだ。
プロジェクトについて読むと、データを受動的な入力として位置付けようとしているのではなく、むしろデータを広範なネットワーク内で価値を生み出し続けることができる経済的資産として扱おうとしている。このアイデアは、貢献が特定され、帰属されることができれば、報酬がより効果的に分配される可能性があるということだ。
一見すると、これは簡単に聞こえる。
しかし、考えれば考えるほど、ますます複雑になっていく。
AIシステム内での貢献を測定するのは簡単ではない。データは孤立して価値を生み出すことはほとんどない。モデルは千のデータセットに依存するかもしれない。複数の貢献者が同時に結果に影響を与えるかもしれない。情報の有用性は時間とともに変化することが多い。
このため、OpenLedgerが直面している本当の課題は、ブロックチェーンが取引を記録できるかどうかではないと思う。本当の課題は、貢献そのものが意味のある方法で測定できるかどうかだ。
その違いは重要だ。
多くのブロックチェーンプロジェクトはインフラの構築に焦点を当てている。OpenLedgerは異なる質問をしているようだ:インフラはAIエコシステム全体で経済的帰属をどのようにサポートできるか?
私はその質問をはるかに興味深いと思う。
一歩引いて広い視野で見ると、私はAI開発を非常に相互接続されたプロセスとして見ている。データ提供者はリソースを作り、開発者はモデルを構築し、アプリケーションはユーティリティを提供し、ユーザーはフィードバックを生成し、自律エージェントはますます人々や組織のためにタスクを遂行する。
これらのコンポーネントは独立して動作しない。
システムによって生み出される価値は、彼らの相互作用から生じる。
私が考えるに、OpenLedgerが試みているのは、これらの相互作用が経済的に可視化される環境を作ることだ。データ、モデル、エージェントを別々の世界として扱うのではなく、プロジェクトは共通のフレームワークを通じてそれらを接続する方法を探ろうとしているようだ。
成功すれば、今日のAI経済における最大の非効率性の一つ、貢献と報酬の間の断絶を減少させる可能性がある。
もちろん、現実的であることも重要だと思う。
歴史は、インセンティブシステムが設計するのが非常に難しいことを示している。報酬を作るのは簡単だが、持続可能な報酬を作るのははるかに難しい。
経済的インセンティブが導入されると、参加者は自然にその周りで行動を適応させる。一部は真の価値を提供する。その他は報酬を最適化する。時間が経つにつれて、システムはオープン性、品質、公平性、効率のバランスを継続的に取らなければならない。
これは、OpenLedgerの未来が技術と同じくらい経済に依存する理由だ。
インフラは完璧に機能するかもしれないが、インセンティブが歪むと、システムは依然として苦しむ可能性がある。逆に、インセンティブが整合していれば、ネットワークは時間とともにますます価値のある貢献を引き寄せるかもしれない。
私が考え続けるもう一つの側面は流動性のアイデアだ。
私は、AI経済の多くが価値のある資産を含んでいるが、直接的にマネタイズするのが難しいと感じることが多い。データには価値があるが、効率的な市場が欠けていることが多い。モデルはユーティリティを生み出すが、継続的な経済参加を捉えるのに苦労するかもしれない。自律エージェントは有用な仕事を遂行できるが、しばしば限られた経済的枠組みの中で動作する。
OpenLedgerは、これらの資産をより経済的に活発にする方法を模索しているようだ。
それをほぼ休眠資源を生産的な資本に変えるようなものだと思う。
未使用のデータセットには潜在的な価値がある。アイドル状態のモデルには潜在的な価値がある。タスクを待っている自律エージェントには潜在的な価値がある。課題は、これらのリソースを貢献を認識し、報酬を与えることができるシステムに接続することだ。
それがOpenLedgerの中心的なアイデアの一つのようだ。
そのプロジェクトが最終的に成功するかどうかは、私には自信を持って予測できない。
私が言えるのは、その方向性が知的に魅力的だと感じるということだ。
何年にもわたり、AIに関する議論は主に知性そのものに焦点を当ててきた。モデルがどのように学び、どのように推論し、どのように改善するか。しかし、ますます、私は会話が所有権、帰属、価値の分配にシフトしていると思う。
AIが価値を生み出すとき、誰が利益を得るのか?
データが成功した結果に貢献したとき、誰が報酬を受けるべきか?
自律エージェントはデジタル経済にどう参加すべきか?
これらの質問は、AIシステムがより能力を持つようになるにつれて、ますます重要になっている。
OpenLedgerを見ると、AIとブロックチェーンを単に人気のある技術だからといって統合しようとしているプロジェクトとは見えない。私は、彼らの間に存在する構造的な問題に取り組もうとしている試みを見ている。このプロジェクトは、単なる知性では不十分であることを認識しているようだ。経済的な調整も重要だ。
多くの面で、OpenLedgerはAIエコシステム内で価値がどのように移動するかを再設計する実験のように感じる。
私の観点から最も興味深い部分は、技術が機能するかどうかではない。技術は時間とともに改善されることが多い。私がもっと興味を持っているのは、システムがデータ提供者、モデルビルダー、開発者、自律エージェントの間でインセンティブをうまく整合できるかどうかである。過度の複雑さを生み出さずに。
それは難しい課題だ。
しかし、私はそれが次のAI経済の段階を定義する課題であると信じている。
OpenLedgerを追い続ける中で、私は同じ考えに戻ってくる。人工知能の未来は、誰が最も賢いモデルを構築するかだけで決まるわけではないかもしれない。それは、これらのモデルが生み出す価値を帰属、調整、分配するための最も効果的なシステムを作る誰によっても形作られるかもしれない。
OpenLedgerはその可能性を探ろうとしている。
それが将来のインフラの主要な部分になるか、単に重要な実験に過ぎないかはともかく、私が思うに、その質問は現在利用可能な答えよりもはるかに重要である。そして急速に進化するAIの風景の中で、時には最も価値のあるプロジェクトは、OpenLedgerを見ていると、ブロックチェーンについて考えるのではなく、デジタル経済の表面下で静かに育ってきた問題について考えている自分がいる。
私たちは、データが世界で最も価値のある資源の一つになった時点に達したと思うが、それを作成する人々とそれから利益を得る人々との関係は驚くほど切り離されている。毎日、人々は会話、アプリケーション、取引、検索、オンライン活動を通じて膨大な情報を生成している。そのデータはAIシステムを燃料にし、モデルを改善し、企業がますます強力な製品を構築するのを助ける。しかし、ほとんどの貢献者は、自分たちの貢献から生じる価値にほとんど参加しない。
私が興味を持つのは、この不均衡は誰かが意図的にそのように設計した結果ではなかったということだ。多くの点で、それはインターネットが進化した結果に過ぎない。中央集権的なプラットフォームは、情報を収集し、整理し、マネタイズする効率的な場所になった。時間が経つにつれて、データの所有権、インフラの所有権、価値の獲得が同じ場所に集中するようになった。
人工知能がますます重要になるにつれて、この問題は無視できないほど難しくなると思う。
AIモデルは膨大なデータセットに依存している。それらのデータセットは数え切れないほどの個人、ビジネス、アプリケーション、システムから来ている。モデル開発者は専門知識と革新を提供する。ユーザーはパフォーマンスを改善するフィードバックを提供する。しかし、参加者の数にもかかわらず、経済的な構造は驚くほど狭く感じることが多い。
このスペースを勉強すればするほど、挑戦は技術的なだけではないと感じる。それは経済的でもある。
もはや、単により良いAIを構築する方法ではない。人々、データ、モデル、エージェントを公正に調整するシステムを構築する方法が問われているのだ。
ここでOpenLedgerが私の注意を引いた。
モデルのパフォーマンスや計算能力にのみ焦点を当てるのではなく、OpenLedgerがより深い構造的問題に取り組もうとしているのが見える。このプロジェクトは比較的シンプルなアイデアから始まるようだ:データ、AIモデル、そして自律エージェントが生産的なデジタル資産になっているなら、貢献を追跡し、価値をより透明に分配できるインフラが必要かもしれない。
この視点は面白いと思う。なぜなら、純粋な技術からインセンティブ設計へと会話がシフトするからだ。
ほとんどのAIの議論では、データは原材料として扱われる。それはシステムに入って、トレーニングに貢献し、その後ほとんど視界から消えてしまう。元の貢献者と、そのデータによって生み出される未来の価値との間の関係は、しばしば測定不可能になる。
OpenLedgerは代替的アプローチを探っているようだ。
プロジェクトについて読むと、データを受動的な入力として位置付けようとしているのではなく、むしろデータを広範なネットワーク内で価値を生み出し続けることができる経済的資産として扱おうとしている。このアイデアは、貢献が特定され、帰属されることができれば、報酬がより効果的に分配される可能性があるということだ。
一見すると、これは簡単に聞こえる。
考えれば考えるほど、ますます複雑になっていく。
AIシステム内での貢献を測定するのは簡単ではない。データは孤立して価値を生み出すことはほとんどない。モデルは千のデータセットに依存するかもしれない。複数の貢献者が同時に結果に影響を与えるかもしれない。情報の有用性は時間とともに変化することが多い。
このため、OpenLedgerが直面している本当の課題は、ブロックチェーンが取引を記録できるかどうかではないと思う。本当の課題は、貢献そのものが意味のある方法で測定できるかどうかだ。
その違いは重要だ。
多くのブロックチェーンプロジェクトはインフラの構築に焦点を当てている。OpenLedgerは異なる質問をしているようだ:インフラはAIエコシステム全体で経済的帰属をどのようにサポートできるか?
私はその質問をはるかに興味深いと思う。
一歩引いて広い視野で見ると、私はAI開発を非常に相互接続されたプロセスとして見ている。データ提供者はリソースを作り、開発者はモデルを構築し、アプリケーションはユーティリティを提供し、ユーザーはフィードバックを生成し、自律エージェントはますます人々や組織のためにタスクを遂行する。
これらのコンポーネントは独立して動作しない。
システムによって生み出される価値は、彼らの相互作用から生じる。
私が考えるに、OpenLedgerが試みているのは、これらの相互作用が経済的に可視化される環境を作ることだ。データ、モデル、エージェントを別々の世界として扱うのではなく、プロジェクトは共通のフレームワークを通じてそれらを接続する方法を探ろうとしているようだ。
成功すれば、今日のAI経済における最大の非効率性の一つ、貢献と報酬の間の断絶を減少させる可能性がある。
もちろん、現実的であることも重要だと思う。
歴史は、インセンティブシステムが設計するのが非常に難しいことを示している。報酬を作るのは簡単だが、持続可能な報酬を作るのははるかに難しい。
経済的インセンティブが導入されると、参加者は自然にその周りで行動を適応させる。一部は真の価値を提供する。その他は報酬を最適化する。時間が経つにつれて、システムはオープン性、品質、公平性、効率のバランスを継続的に取らなければならない。
これは、OpenLedgerの未来が技術と同じくらい経済に依存する理由だ。
インフラは完璧に機能するかもしれないが、インセンティブが歪むと、システムは依然として苦しむ可能性がある。逆に、インセンティブが整合していれば、ネットワークは時間とともにますます価値のある貢献を引き寄せるかもしれない。
私が考え続けるもう一つの側面は流動性のアイデアだ。
私は、AI経済の多くが価値のある資産を含んでいるが、直接的にマネタイズするのが難しいと感じることが多い。データには価値があるが、効率的な市場が欠けていることが多い。モデルはユーティリティを生み出すが、継続的な経済参加を捉えるのに苦労するかもしれない。自律エージェントは有用な仕事を遂行できるが、しばしば限られた経済的枠組みの中で動作する。
OpenLedgerは、これらの資産をより経済的に活発にする方法を模索しているようだ。
それをほぼ休眠資源を生産的な資本に変えるようなものだと思う。
未使用のデータセットには潜在的な価値がある。アイドル状態のモデルには潜在的な価値がある。タスクを待っている自律エージェントには潜在的な価値がある。課題は、これらのリソースを貢献を認識し、報酬を与えることができるシステムに接続することだ。
それがOpenLedgerの中心的なアイデアの一つのようだ。
そのプロジェクトが最終的に成功するかどうかは、私には自信を持って予測できない。
私が言えるのは、その方向性が知的に魅力的だということだ。
何年にもわたり、AIに関する議論は主に知性そのものに焦点を当ててきた。モデルがどのように学び、どのように推論し、どのように改善するか。しかし、ますます、私は会話が所有権、帰属、価値の分配にシフトしていると思う。
AIが価値を生み出すとき、誰が利益を得るのか?
データが成功した結果に貢献したとき、誰が報酬を受けるべきか?
自律エージェントはデジタル経済にどう参加すべきか?
これらの質問は、AIシステムがより能力を持つようになるにつれて、ますます重要になっている。
OpenLedgerを見ると、AIとブロックチェーンを単に人気のある技術だからといって統合しようとしているプロジェクトとは見えない。私は、彼らの間に存在する構造的な問題に取り組もうとしている試みを見ている。このプロジェクトは、単なる知性では不十分であることを認識しているようだ。経済的な調整も重要だ。
多くの面で、OpenLedgerはAIエコシステム内で価値がどのように移動するかを再設計する実験のように感じる。
私の観点から最も興味深い部分は、技術が機能するかどうかではない。技術は時間とともに改善されることが多い。私がもっと興味を持っているのは、システムがデータ提供者、モデルビルダー、開発者、自律エージェントの間でインセンティブをうまく整合できるかどうかである。過度の複雑さを生み出さずに。
それは難しい課題だ。
しかし、私はそれが次のAI経済の段階を定義する課題であると信じている。
OpenLedgerを追い続ける中で、私は同じ考えに戻ってくる。人工知能の未来は、誰が最も賢いモデルを構築するかだけで決まるわけではないかもしれない。それは、これらのモデルが生み出す価値を帰属、調整、分配するための最も効果的なシステムを作る誰によっても形作られるかもしれない。
OpenLedgerはその可能性を探ろうとしている。
