

数年前、私はAIで最も重要な資源は計算(コンピュート)だと考えていました。
最も処理能力が高い者が勝つ。そんな前提は当時は当然のように思えました。ところが最近では、もっと面白くない何かに気づくようになりました。知能ではない。正確さでもない。
さらに具体的には、機械の記憶が人間の記憶と違う挙動をし始めたら何が起きるのでしょう。
人間は日常的に物を忘れます。会話を忘れる。細部を忘れる。名前を忘れる。ミスを忘れる。忘れることは、ときに健康的です。人がある種の情報をどれくらいの期間持ち回るかを制限することを前提に、実際に法制度全体が組み立てられていることすらあります。ですが、経済が重要な情報を忘れると、その結果は驚くほど高くつくことがあります。
この区別は、私がAIのインフラを見ているとき、ずっと頭から離れません。
多くの人は今でも、AIの核心的な問題は「より良い答えを生成すること」だかのように話します。けれども企業がAIを試す様子を見ているほど、より良い答えが本当のボトルネックだとは私は確信できなくなっています。多くの場合、その問題は答えが生成された後に現れるようです。
その情報はどこから来たのか。
誰がそれを貢献したのか。
それを誰かが検証できますか。
そしておそらく最も重要なのは、6か月後に何かがうまくいかなかったとき、誰かが何が起きたのかを再構成できるのか、ということです。
その問いは、お金が絡むまでは退屈に聞こえます。
多くのAIプロジェクトは、知能レースで競い合っています。より速いモデル。より良い推論。より効率的な学習。けれども、@OpenLedger はAIそのものとは別のところを見ているように思えます。ほとんどAIの下、という感じで。
私の解釈では、このプロジェクトは奇妙な問いを投げかけています。希少な資源が知能ではなく、「追跡可能な知識」だとしたらどうなるのか。
最初は、それはデータの所有権をめぐるブランディングのための取り組みに聞こえました。じっくり考えるほど、この説明に対する居心地の悪さが増していきました。
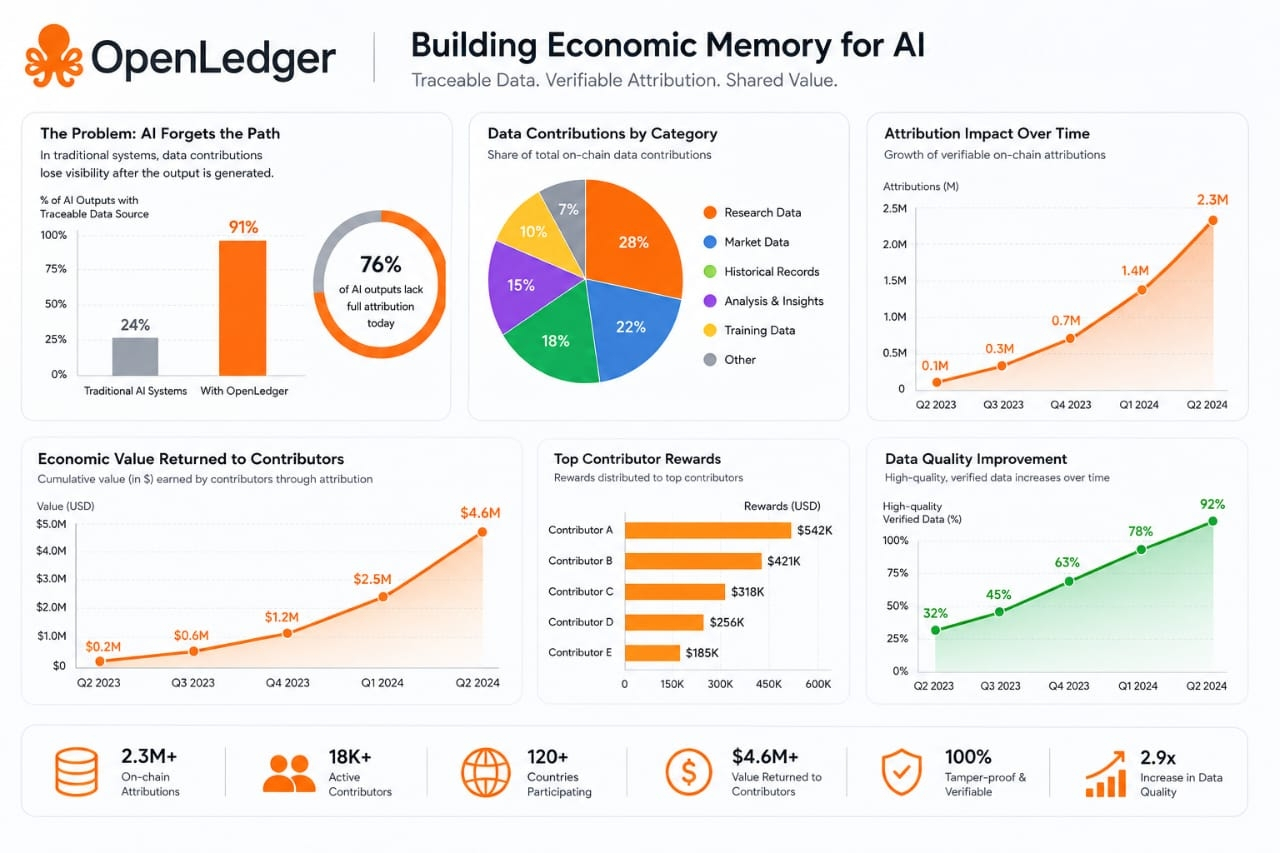
というのも、AIシステムが互いに相互作用を始めると、知識の連鎖は非常に素早く混乱します。たとえば10個のAIシステムが1つの出力に貢献している状況を想像してください。1つは調査を提供する。別の1つは市場データを提供する。さらに別の1つは過去の記録を提供する。他にも分析、フィルタリング、順位付けの仕組みを追加する。やがて答えが現れます。皆が答えを見ます。でも、ほとんど誰も道筋(パス)を見ていません。その見えない道筋が、最終出力よりも重要になる可能性があります。
金融機関がAI支援の業務フローを試すという話を読んだことを覚えています。私を惹きつけたのは、モデルが有用な出力を出すかどうかではありませんでした。むしろ、その後のコンプライアンスの議論です。組織は、そのAIが賢いかどうかを尋ねていたわけではありません。必要になった場合に、規制当局へ意思決定のプロセスを説明できるのかを問うていたのです。それはまったく別の種類の問題のように感じました。
経済は、驚くほど長い間、完璧でない知能を許容できます。ですが耐えられないのは、見えない説明責任です。
それが、部分的にOpenLedgerが私の目を引いた理由です。
サプライチェーンでは、出自(プロヴェナンス)の記録が重要です。企業は製品がどこから来たのかを知る必要があるからです。医療でも、記録が存在します。記憶はそれ自体を信頼できないからです。それでも、AIの多くはいまだに帰属(アトリビューション)を「任意のもの」のように動いています。変だと感じます。AIが生産性ツールにとどまる間はそれでいいのかもしれません。でも、AIが経済活動の当事者になったら私は確信が持てません。
その視点で見ると、OpenLedgerの主張はより面白く見えてきます。
データの貢献が追跡可能なままであれば、知識は単にモデルに入って消えてしまうだけではありません。貢献者は、下流での価値創造につながった状態で残り続ける可能性があります。さらに重要なのは、意思決定の連鎖が観測可能になることです。Proof of Attribution(帰属証明)の中核メカニズムは、すべてのデータ貢献をオンチェーン上の永続的で検証可能な状態変化として記録します。企業のプライベートなデータベースではありません。静かに修正できるログでもありません。記録が制度上の善意ではなく数学に依存する台帳(レジャー)です。
より大きな問題は「経済的な記憶」なのかもしれません。
システムが知識の出どころを見失うと、徐々に信号とノイズを区別する能力を失っていきます。高品質な貢献者を特定しにくくなります。悪い情報と良い情報が、似たような条件で競い始めます。やがてインセンティブがずれ始めます。そのプロセスは遅い。ほとんど見えない。けれども、突然誰もが「品質が悪化している」ことに気づきます。
AIの外でも似たパターンを見たことがあります。金融市場はしばしば、透明性をうっかり取り除いてしまったと気づくまで、何年も効率性の最適化に費やします。ソーシャルプラットフォームは、人々の関心を最適化することで、信頼性を弱めてしまったと気づく前に、しばらくはその状態で進みます。システムは一度に全てが壊れることは滅多にありません。ゆっくりと、そして気づきにくい形で変質します。AIのインフラも、同様のものに直面するかもしれません。
それでも、OpenLedgerの「道筋」が単純だとは思いません。誰も本当には語らないトレードオフがここにあります。皆が理屈の上では説明責任を支持しています。しかし説明責任が運用上の負担を生むと、支援ははるかに薄くなります。だからこそ私は、OpenLedgerを「確実な勝者」と見なしていません。私が面白いと思うのは、賭けの方向そのものです。
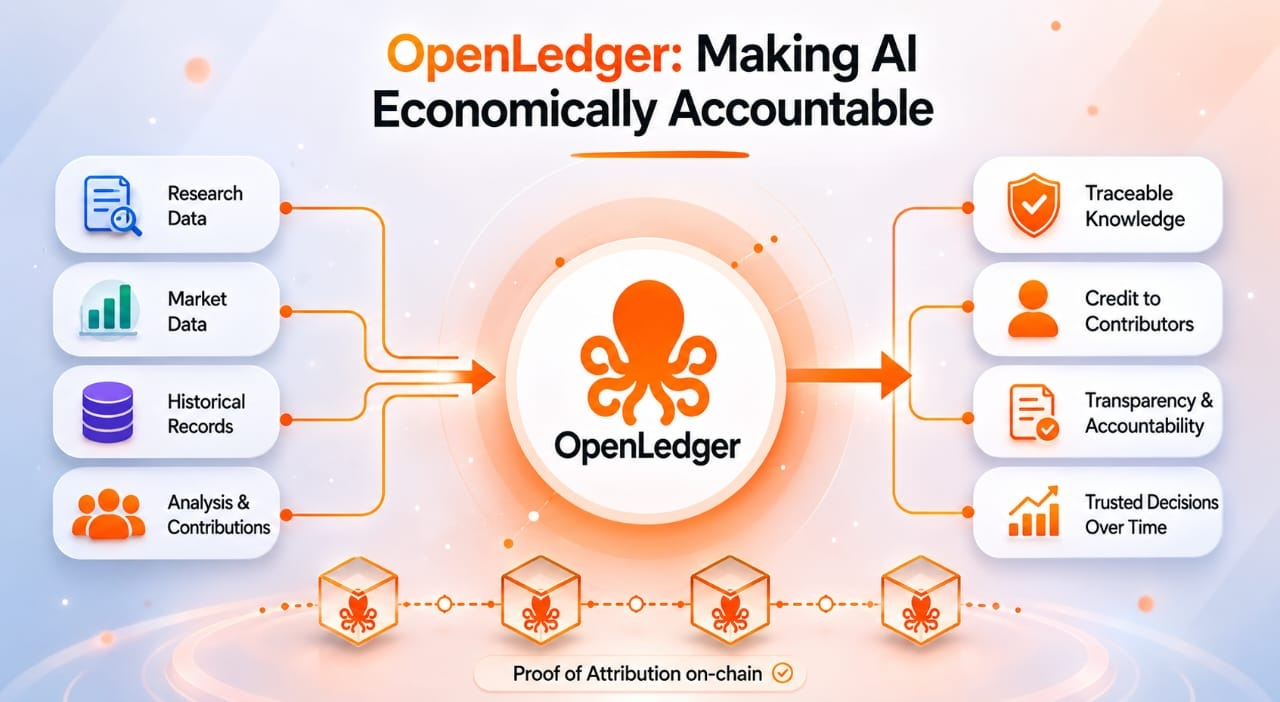
業界はAIをより賢くすることに執着しています。OpenLedgerは、AIを経済的に説明責任のあるものにすることに関心があるように見えます。それらは同じ目的ではありません。しかも、私は市場が誤った希少性に注目しているのではないかと考え続けています。
計算コストは時間とともに安くなります。モデルは改善します。推論コストも下がります。ですが信頼できる記録は、システムが複雑になるほど、なぜかより価値が高くなる傾向があります。
たぶん、AIの忘れっぽさは、今日では技術的な不便に聞こえるでしょう。製品の不具合。エンジニアがいずれ解決するはずのもの。あるいは、忘れっぽさが、誰も気づかないまま隠れたリスクの源になり、AI主導の市場が「誰が・何を・いつ・なぜ」提供したのかを覚えることに依存し始めてから、ようやく問題になるのかもしれません。
それが、OpenLedgerがかけている賭けです。
私は、多くの賭けの中でもそれより面白いと感じます
