

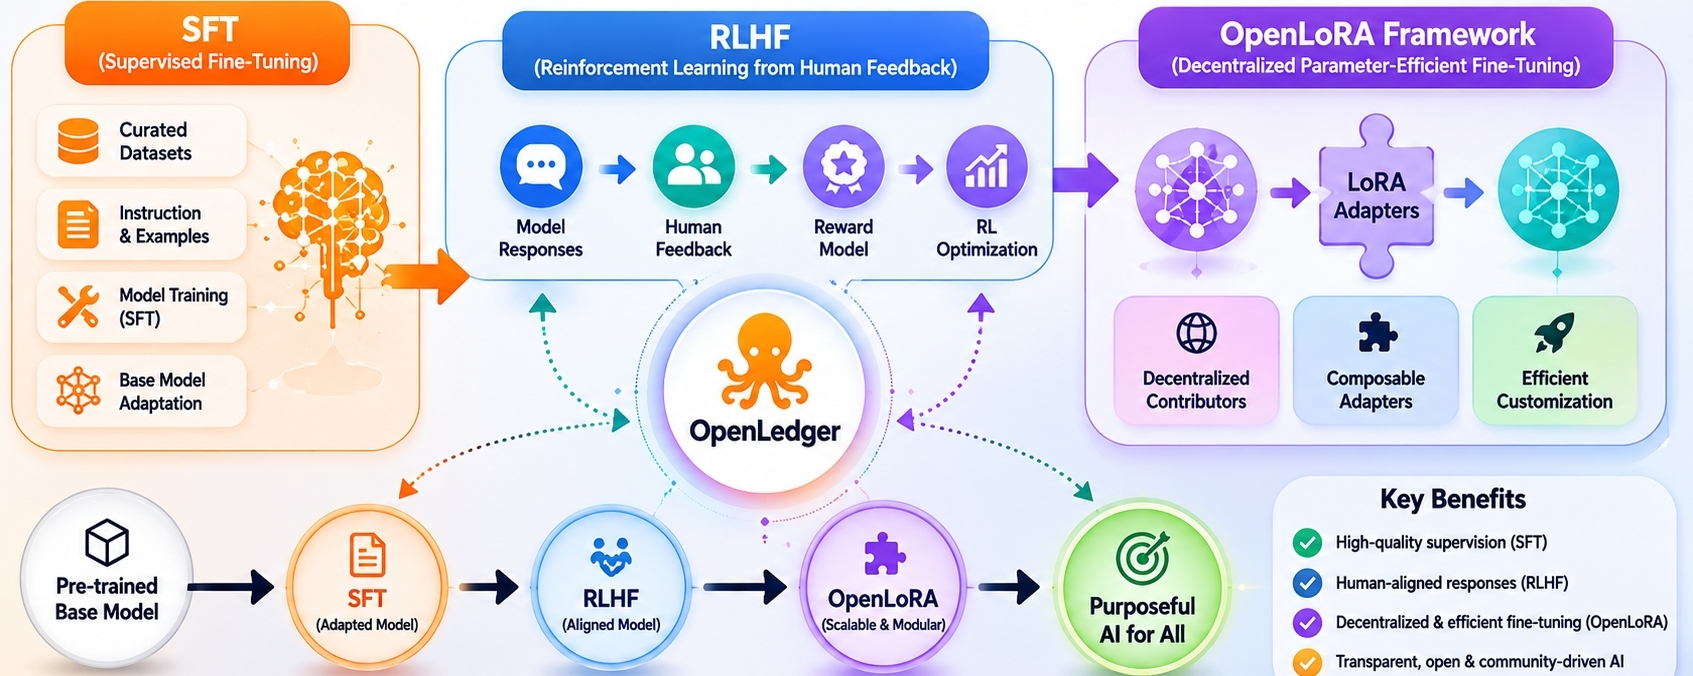
OpenLedgerに注意を引き戻し続けたのは、モデルの品質ではありませんでした。問題は、1つのモデルを訓練する段階を超えて、貢献者、バリデータ、データセット、フィードバックループを大規模に協調させるようになったとき、アライメントの摩擦(alignment friction)が実際にはどこに存在するのか、という点でした。
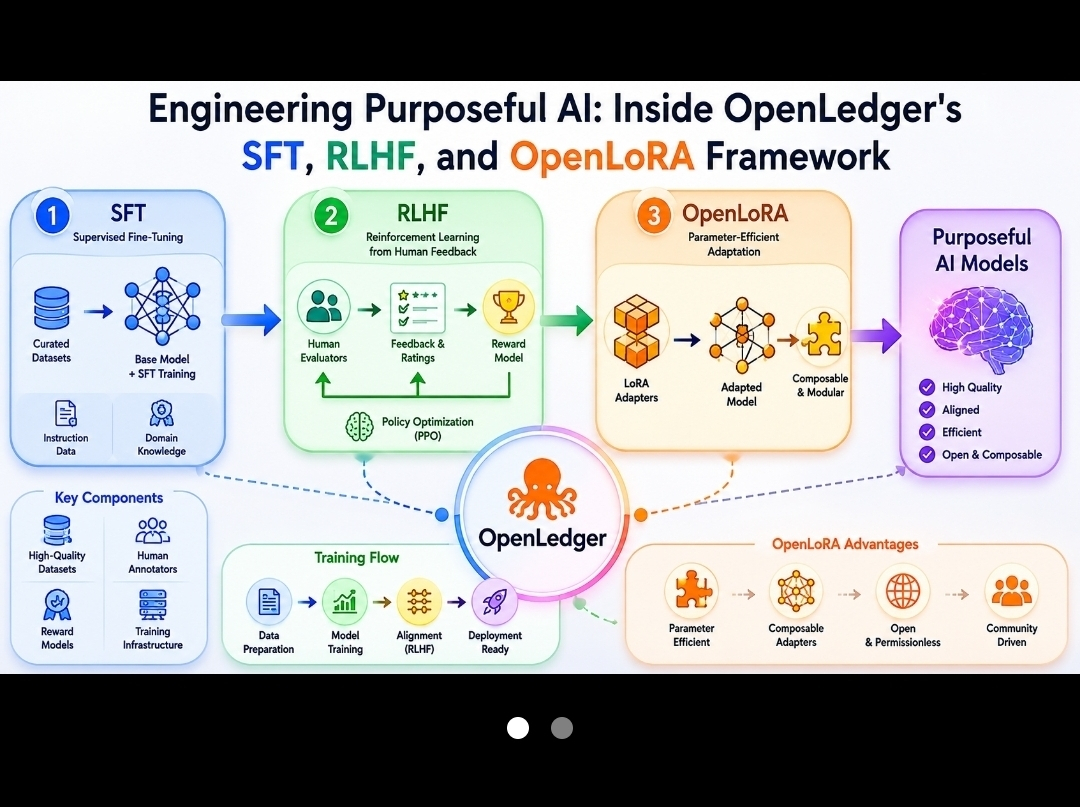
OpenLedgerの面白さは、SFT、RLHF、OpenLoRAが個別に機能するかどうかではありません。ほとんどの人はそれをすでに受け入れています。難しいのは、これらの仕組みが複数の関係者によって継続的にモデルの振る舞いが形作られる、共有された本番環境の一部になったときに何が起きるのかです。
そこから運用上の緊張が始まる。
評価の場では信頼できそうに見えるモデルでも、微調整の導線が増えていくと、驚くほど不安定になることがある。新しいデータセットが入るたびに好みが生まれる。各貢献者が前提を持ち込む。各最適化は静かに、役に立つ度合いの別バージョンへとモデルを押しやる。
課題は知能を作ることではない。
知能が改変されている間も、意図を保つことが課題だ。
OpenLedgerが、教師あり微調整、ヒューマンフィードバックからの強化学習、そしてOpenLoRAによるモジュール化された適応をどう組み合わせるかを見ていると、このことにずっと気づいていた。紙の上では、これらの構成要素は相補的に見える。だが実際には、どこかで管理しなければならない、相争う圧力を生み出す。
まずSFTから考えよう。
多くの人は、教師あり微調整を単純な段階だと思っている。厳選した例が投入され、より良い振る舞いが出てくる。だが現実はもっとごちゃごちゃしている。複数の貢献者が学習データを提供し始めると、問題は質から一貫性へと移っていく。
同じ顧客サポートのタスクを2人の貢献者が解く状況を想像してみて。1人は簡潔さを報いる。もう1人は徹底的な説明を報いる。
どちらのデータセットも、必ずしも間違っているわけではない。
しかし両方が学習パイプラインに入ってくると、モデルは成功の定義が食い違うことを学び始める。
失敗の仕方は微妙だ。出力は技術的には正しいまま、運用上は予測不能になっていく。
あるユーザーが同じ質問を2回すると、まったく違う応答スタイルが返ってくる。
壊れているようには見えない。
それでも信頼は削れていく。
ここが、トレーニングそのものよりも、OpenLedgerの帰属への重視がより面白くなる場所だ。特定のデータセットが導入された後に特定の行動変化が現れるなら、影響の追跡は推測ではなく可能になる。
減らされるリスクは、幻覚(ハルシネーション)ではない。
行動のドリフトがどこから生まれたのかが曖昧になることだ。
それは小さく聞こえるが、デバッグが始まると大きくなる。
帰属がなければ、予想外のモデル応答はすべて探偵物語になる。
帰属があると、調査はより絞り込まれて安くなる。
それでも、帰属(アトリビューション)は独自のコストを持ち込む。貢献者はモデルの振る舞いにおける見える参加者になる。可視性は説明責任を生むが、ためらいも生む。影響が測定できるので、より慎重になる貢献者も出てくる。
そのトレードオフは現実味がある。
より良い追跡可能性は、多くの場合実験速度を落とす。
するとRLHFが登場して、さらに話はすっきりしなくなる。
ヒューマンフィードバックは、通常アライメントのレイヤーとして提示される。つまり、モデルが人々の実際の好みを学ぶ段階だ。
それがそんなに単純だとは、私は完全には確信していない。
ヒューマンフィードバックは、長期的な有用性よりも、しばしば当面の満足をうまく捉える。
その区別は重要だ。
同じ質問に対して2つの応答がある状況を考えてみて。
確信は近道になる。
時間が経つにつれ、最適化の圧力が、より真実になる前に「気分的に良い」応答へとモデルを押してしまうことがある。
OpenLedgerは、その緊張を完全にはなくせない。どのフレームワークでもそうだ。できるのは、中央集権的なパイプラインの裏に隠すのではなく、アライメントのプロセスをより多く可視化することだ。
それは興味深いテストになる。
好ましい出力について、2つのフィードバック集団が一貫して意見を異にしているなら、誰の好みを優先すべきなのか?
明確な答えはない。
多くの人が分散化すれば自動的にこの問題は解決すると考えている気がする。
それが本当にそうだかは、私はわからない。
単に意見の不一致を可視化するだけだ。
そして、可視性は解決とは別物だ。
機械的な例を1つ挙げると、これがはっきりわかる。
あるモデルが、金融の推論タスクに対して1,000件のフィードバックイベントを受け取るとしよう。
簡潔な応答に対して700の報酬。
詳細なリスク分析に対して300の報酬。
最適化の経路は、それらの信号がどう重み付けされるかに完全に依存する。
技術的な仕組みの重要性は、そこに埋め込まれたガバナンスの前提よりも小さい。
いずれ誰かが「より良い」とは何かを決める。
たとえその判断が集団として生まれるとしても。
私が最も惹かれるのはOpenLoRAで、ここがアライメントの摩擦が具体的に手触りとして現れる場所だからだ。
従来の微調整は、エンジンを動かしながら部品を交換するような挙動をしがちだ。あらゆる変更には、別の場所で意図しない結果が生じる可能性がある。
OpenLoRAは、適応の単位を変える。
巨大な基盤モデルを何度も書き換える代わりに、貢献者は、よりモジュール化されたままの専門的な適応を構築できる。
それは純粋な改善のように聞こえるが、運用の現実が姿を現すまでだ。
モジュール型のシステムは、失敗の一種類を減らす一方で、別の失敗を生み出す。
すると課題は選別になる。
どの適応を使うべきか?
優先すべきなのは、どのバージョン?
その摩擦は消えない。
動く。
その動きは、AIインフラにおける最も過小評価されているダイナミクスの一つだと思う。
システムが複雑さを完全に消すことは稀だ。
それを移し替える。
OpenLoRAは、複雑さをモデル再学習から引き離し、モデルの協調へと移し替えるように見える。
それはしばしば良いトレードだ。
しかし、それはトレードのままだ。
ドメイン固有の2つのLoRAを想像してみて。
ある人は法的推論に特化する。
別の人は顧客サポートに特化する。
個別には、どちらもよく機能する。
混成のワークフローでは、ルーティング、優先順位、互換性、評価についての意思決定が突然必要になる。
モデル層は更新しやすくなる。
協調レイヤーの管理は難しくなる。
どちらの負担を、あなたなら引き受けたい?
私は、妥当な人なら答えが分かれてもおかしくないと思っている。
これもまた、OpenLedgerの経済レイヤーが最終的に重要になってくる理由を説明している。
すぐには。
憶測としてではない。
インフラとして。
帰属、フィードバック、適応が測定可能な活動になると、インセンティブは必ず会話に入り込む。貢献者にはデータセットを維持する理由が必要だ。検証者には品質を評価する理由が必要だ。フィードバック提供者には、正直に参加する理由が必要だ。
やがて、OPENトークンの役割がほとんど必然的に浮かび上がってくる。インセンティブのない協調は、規模が大きくなるほど減衰しがちだからだ。
興味深いのは、インセンティブが存在するかどうかではない。
成長が到来した後も、インセンティブは有用性を報い続けるのだろうか?
歴史は、まさにそこが多くのシステムが苦戦する場所だと示唆している。
私がOpenLedgerに戻ってしまうのは、オープンAI開発への約束ではない。たくさんのプロジェクトが「開放性」を約束している。
アライメントのコストが実際にどこで積み上がっているのかを、さらけ出すことへの意欲だ。
モデルのアーキテクチャには反映されない。
ベンチマークのスコアではそうならない。
貢献者たちが、少し違う目標に向けて同じ知能を形作ろうとしている、ごちゃごちゃした空間の中で。
本当のテストは、意外とシンプルなのかもしれない。
同じくらい技能のある2人の貢献者が、質の別定義に向けてシステムを訓練した場合、ユーザーがその結果を経験する前に、フレームワークはその衝突を明らかにできるのか?
そして可能なら、その透明性は結果を改善するのか?それとも単に、意見の不一致を観察しやすくするだけなのか?
答えはまだ確定していないと思う。
SFT、RLHF、OpenLoRAを一緒に眺めるほど、それらが最適化手法に見えなくなり、むしろ交渉の仕組みに見えてくる。
データセット間の交渉。
好みの間の交渉。
開放性と首尾一貫性の間の交渉。
ほとんどのAIシステムは、その交渉をインターフェースの裏に隠してしまう。
OpenLedgerは、それらを表に出すことに固執しているように見える。
それが最終的により良い知能を生むのか、それとも単に可視化された摩擦を増やすだけなのかは、まだ私自身が確かめたくなってしまう点だ。
