

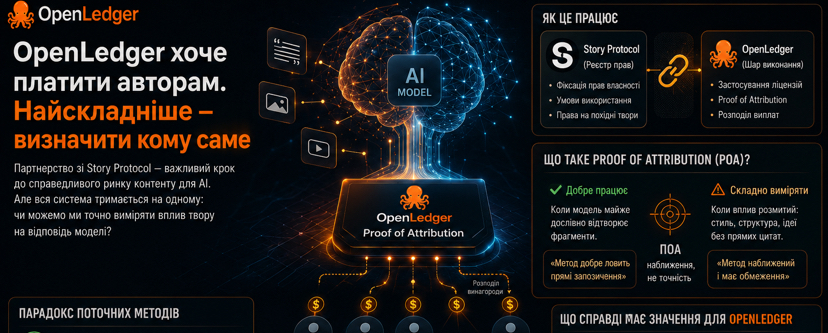

最近、「『AIは作者に支払う』というフレーズを聞くたびに、妙な感覚を抱いていることに気づきます。それは正しく聞こえます。ほとんど誰も反対できないでしょう。でも、それについて考えれば考えるほど、単純な疑問にぶつかります。つまり、あなたの作品がデータセットに存在するという事実に対して支払うのか、それともモデルの回答に対する実際の影響に対して支払うのか?
そして、これは私にはまったく別の2つの経済だと思えます。
ちょうどそのことを、Story Protocolとのパートナーシップ @@OpenLedger を調べ始めたときに考えました。アイデアは美しいです。コンテンツには所有者がいて、AIは利用する権利を得て、作者は報酬を受け取る。Story Protocolが権利を固定し、OpenLedgerがアトリビューションと支払いの分配を担う、というわけです。
でもここは、ひとつの土台にすべてがかかっています——Proof of Attribution。
問題は、大規模なAIモデルにおけるアトリビューションが、いまだに正確ではないことです。システムは、モデルがテキストをほぼ逐語的に再現するような直接的な一致はうまく捉えられます。しかし、直接のコピーなしでモデルが学んだ「ぼやけた」影響——つまりスタイル、思考の構造、全体的なアプローチ——の理解は、はるかに難しいのです。
そして面白いことになります。一番簡単なのは、そもそも証明が容易なもの——引用やほぼそのままの剽窃——に対して支払うことです。逆に、いちばん難しいのは、実際のAIトレーニングでは常に起きるあの種の影響に対して支払うこと。
だから私は、このパートナーシップを「AIにおける著作権問題の解決」としてではなく、むしろ、今日われわれが測定できるのはその一部の影響に対して、システムを構築しようとする試みとして見ます。
ここであなたの意見を聞きたいです。もしあなたのコンテンツがAIの学習に使われたとしたら、あなたにとってより重要なのはどちらでしょうか。最大限正確なアトリビューションか、それとも、システムが少なくとも作者に対して支払おうとするという事実か。
