最近、オープンレジャーのアーキテクチャを見ていて、主にアトリビューションシステムと貢献者のインセンティブについて考えている。
多くの人はオープンレジャーをただのAIと暗号トークンの組み合わせだと思っているが、正直言ってもっと興味深いのはAIデータそのものの周りに調整インフラを構築しようとしている部分だ。
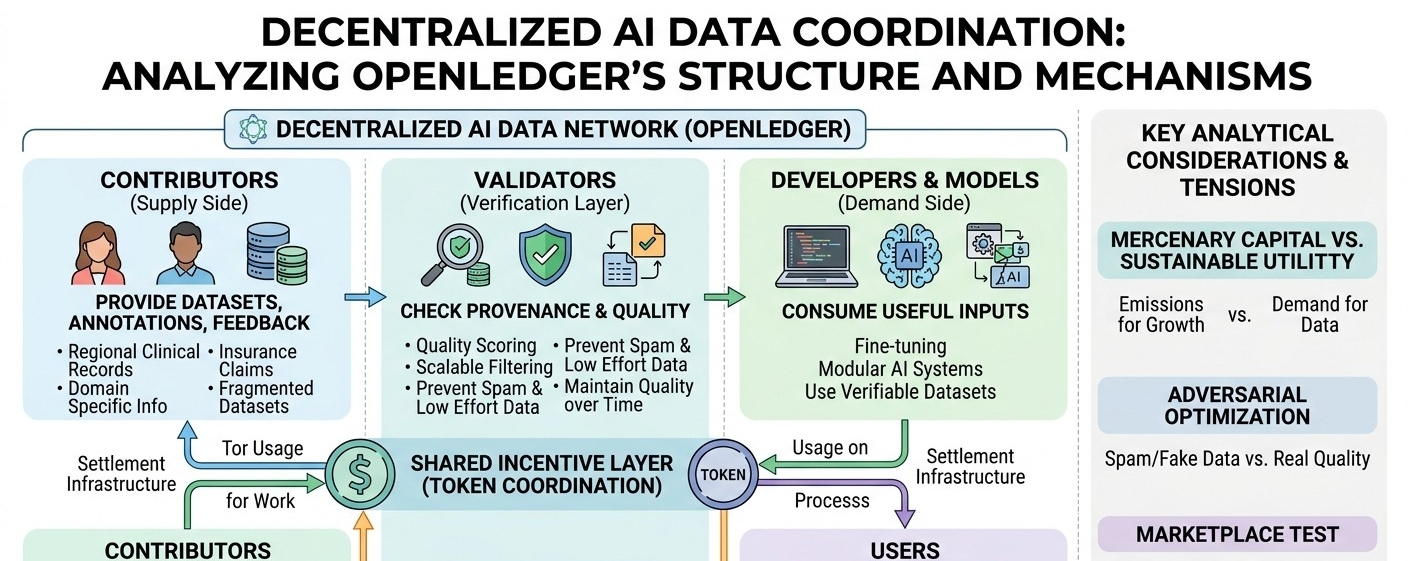
私が注目したのは、ネットワークが貢献者、バリデーター、開発者、ユーザーを共通のインセンティブレイヤーを通じてつなげようとしていることだ。
貢献者はデータセット、アノテーション、フィードバックループ、またはドメイン特有の情報を提供する。
バリデーターは出所と品質をチェックする
開発者はモデルに有用な入力を消費する
ユーザーはアプリケーションや推論を通じて需要を生み出す
理論的には、トークンはそれらすべての価値を調整する
分散型貢献システムは実際に特定の分野では意味を持つ
地域の臨床記録や保険請求の注釈で訓練されたヘルスケアモデルは、中央集権的なシステムが常に優先して収集するわけではない断片化されたデータセットを必要とするだろう
オープンレジャーはその前提に基づいて設計されているようだ
未来のAIシステムが完全に垂直統合されるのではなく、よりモジュラーで外部調整されるようになる
そして、帰属レイヤーが正直に言うと、全体のアーキテクチャで最も難しい部分のように感じる
貢献者が下流の有用性に基づいて報酬を受ける場合、プロトコルはどのデータが実際に重要だったかをどうやって知るのか
そして、これが私がずっと考えている部分だ
AIモデルは混合入力からパターンを吸収する
一つの小さな高品質データセットは、何百万もの一般的な例よりも重要になり得る
だから帰属は非常に迅速に確率的になる
それは受け入れ可能かもしれない
貢献者は完璧な精度を必要としないだろう
彼らはただ、公平で操作が難しいと感じるシステムが必要だ
しかし、トークン報酬が意味を持つようになると、人々はプロトコルが測定するメトリクスの周りで最適化する
そこにインセンティブの緊張が現れる
排出が実際の需要が存在する前に支配する場合、貢献者は複製データセット、合成フィラー、低労力の注釈、または報酬システムが許す単なるスパムインタラクションをアップロードするかもしれない
したがって、検証レイヤーは貢献レイヤーと同じくらい重要だ
オープンレジャーは出所追跡、品質スコアリング、スケーラブルなフィルタリングを必要としており、中央集権的なモデレーションに流れることなく
フィルタリングが少なすぎると、ネットワークが騒がしくなる
フィルタリングが多すぎると、分散型の前提が弱まる
マーケットプレイス側はおそらく本当の長期的なテストだ
理想的には、開発者は検証されたデータセットやモデルアクセスのために支払い、ユーザーは推論需要を生み出し、貢献者は排出だけでなく実際のネットワーク使用から収益を得る
そのバージョンでは、トークンは単なるインセンティブの燃料ではなく、決済インフラストラクチャになる
しかし、全体のアーキテクチャは将来のAI需要が十分に断片化されて、この種のコーディネーションレイヤーが必要になることに依存している
大規模なプラットフォームがトレーニング、デプロイメント、ユーザーフィードバックを内部で制御し続けるなら、分散型AIデータ市場は比較的ニッチなままであるかもしれない
見守る
実際の使用料と排出
時間と共に貢献されたデータセットの品質
開発者は帰属可能な外部データを求めている
参加によって帰属の争いがどのようにスケールするか
まだクリーンな結論は出ていない
オープンレジャーは分散型AIシステムの持続可能なコーディネーションレイヤーを構築しているかもしれない
または、トークンインセンティブが需要側が完全に存在する前に市場を作り出せるかどうかをテストしているのかもしれない