

暗号AIで気づくことの一つは、みんなモデルについて話すけど、ほとんど誰も評判について話さないことだ。
取引においては、評判が基本的に全てだから、それが変だ。
信号が賢く聞こえるからといって信用するわけじゃない。信用するのは、次のことがわかっているときだ。
データがどこから来たのか、
誰がそれに貢献したのか、
その貢献者たちが以前に正確だったかどうか、
そしてインセンティブが整合しているかどうか。
だからこそ、OpenLedgerのアーキテクチャは人々が思っている以上に重要に感じる。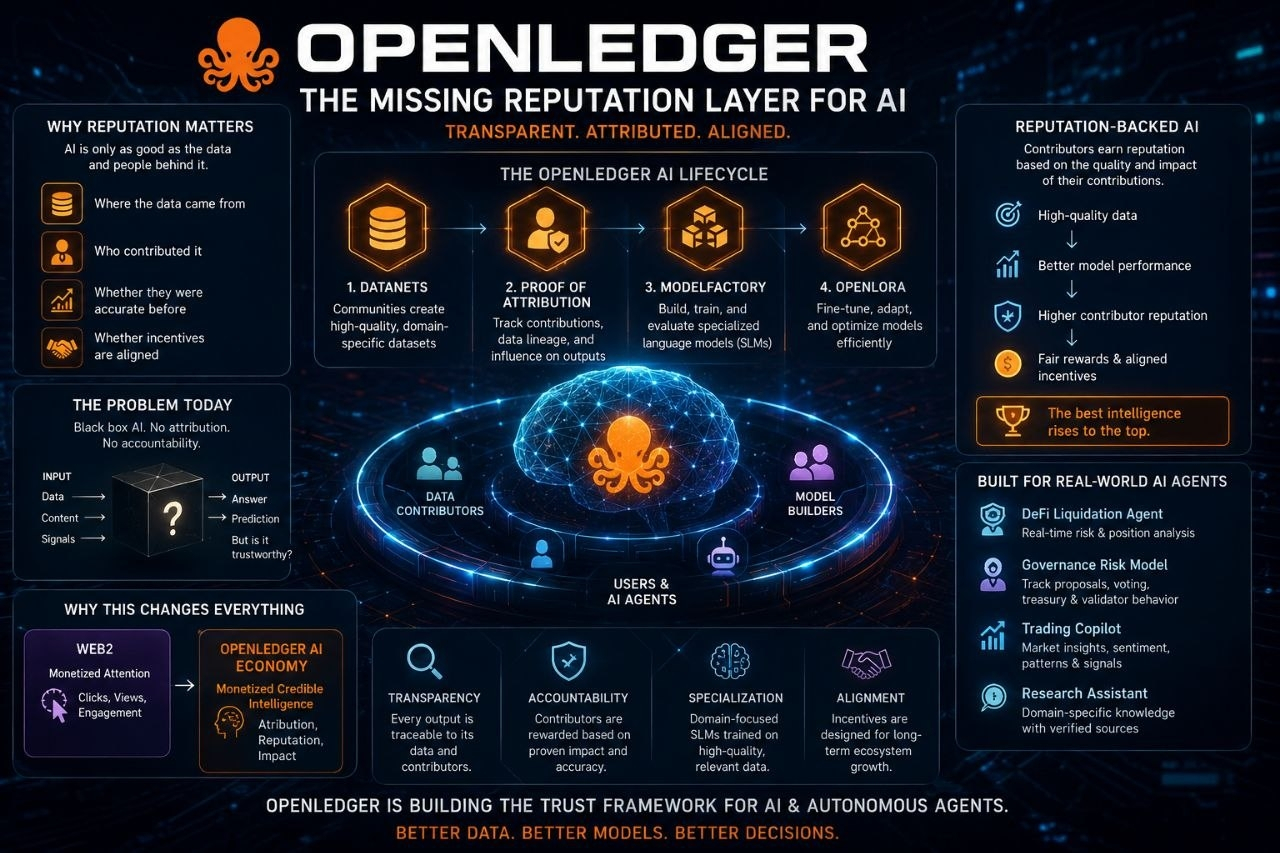
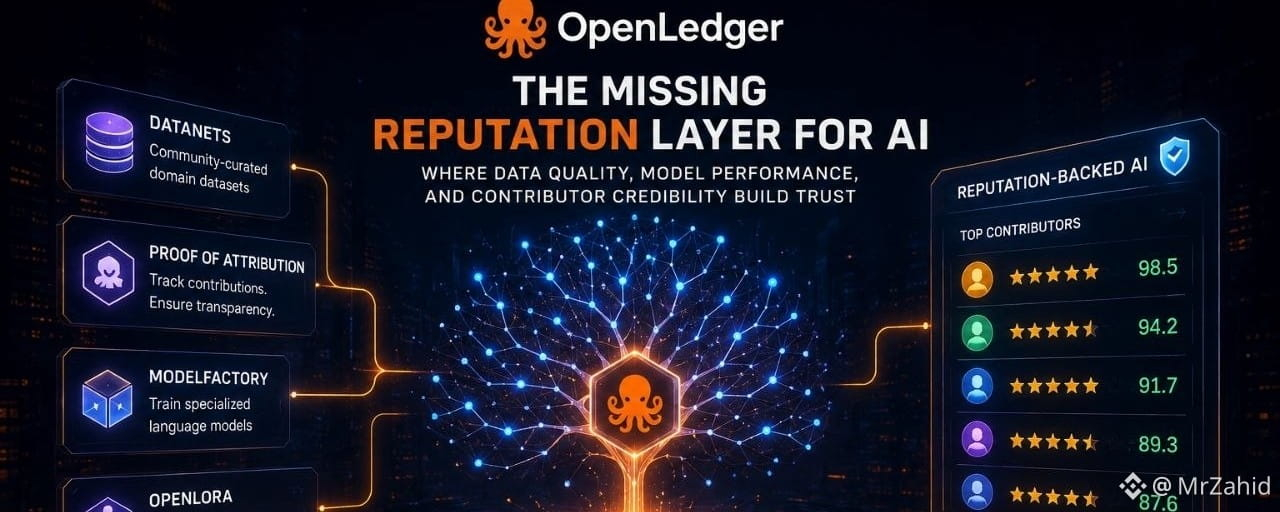
OpenLedgerは単にAIモデルをオンチェーンでホストしようとしているわけではない。もっと大きな狙いは、データ品質、モデルのパフォーマンス、貢献者の信頼性が透明な帰属を通じて全て結びつく経済システムを作ることのようだ。彼らのインフラはDatanets、Proof of Attribution、ModelFactory、OpenLoRAをフルAIライフサイクルスタックに統合している。
面白いのは?これは、評判(リピュテーション)によって裏付けられたAIの土台を作ります。
そして正直、今この物語はものすごく過小評価されていると思います。
今日のほとんどのAIシステムはブラックボックスのように動作しています。質問すると答えが返ってくる。でも、根本のデータがゴミじゃないことをただ祈るだけ。ところがOpenLedgerのProof of Attribution(帰属の証明)メカニズムは、どのデータセットや貢献者がモデルの出力に影響したのかを追跡するよう設計されています。
それによってインセンティブが完全に変わります。
ガバナンス・リスクだけにフォーカスした、暗号研究のDatanetを想像してください。貢献者がガバナンスのサマリー、財庫の変更、バリデータの振る舞い、提案の議論、そして投票の異常をアップロードします。時間が経つにつれて、システムは、上流での高いシグナル情報を一貫して提供し、下流のAI出力を改善している貢献者を特定できるようになります。
すると突然、貢献者は“ユーザー”だけではなくなります。
彼らは、リピュテーション(評判)を伴う知的サービス提供者になります。
それは大きな変化です。
なぜなら、未来のAI経済はたぶん、生のコンテンツ量を報酬にしないからです。検証された有用性を報酬にするでしょう。
トレーダーとして、これはとても重要です。私がこれまで見つけた中で最高の市場インサイトのいくつかは、ニッチな領域で小さなオーディエンスしか持たないのに、驚くほど正確なパターン認識を持つ研究者から得られました。現在のAIシステムは、すべての情報を同じ“スープ”に平坦化してしまいます。OpenLedgerの構造は、帰属(アトリビューション)の質や、過去の貢献価値に基づいた重み付けを可能にするかもしれません。
それは、実際の意思決定がどう行われるかにかなり近いです。
それに、OpenLedgerが掲げる特化型言語モデル(SLM)への注力は、市場が思っている以上に賢いとも感じています。OpenLedgerに関する研究は繰り返し、巨大な万能モデルを作ろうとするのではなく、領域特化の知能を重視する点を強調しています。
正直…それって、アルファが実際にどう機能するかに一致しています。
一般的な知識は、めったに“優位性”を生みません。特化した文脈がそれを生みます。
DeFiの清算エージェントには、詩を理解する必要はありません。
ガバナンス・リスクのモデルには、映画の雑学は要りません。
トレーディングのコパイロットには、広範なネットの雑音は不要です。
彼らには、高品質な領域データで訓練された、鋭く焦点の合った文脈が必要です。
OpenLedgerのDatanetは、まさにその原則のために作られています。コミュニティがターゲットを絞ったデータセットを作り、貢献者がそれを改善し、モデルはそこに特化し、帰属メカニズムが報酬をシステムを通じて配分します。
私が強気だと思うのは、技術だけではありません。経済設計そのものです。
OpenLedgerが成功すれば、AI市場は規模だけを報いるのをやめて、検証可能な専門性を報いるようになるかもしれません。
それはまったく別のインターネット経済です。
Web2で支配的だったプラットフォームは、注目(アテンション)を収益化しました。
次世代のAIインフラは、信頼できる知性を収益化するかもしれません。
そしてもしそれが起きるなら、OpenLedgerはAIチェーン以上の存在になれる可能性があります。自律エージェントが、どの情報—そしてどの貢献者—が実際に影響力を持つに値するのかを評価するために使う信頼の枠組みになれるかもしれません 🤝