


今日は座って考えていて、何をするか決めようと思い、ModelFactoryについて調べることにしました。@OpenLedger きれいな説明のせいではなく、単純な問いとして:『すべての人に利用可能』がどこで終わり、実際の難しさがどこから始まるのか?
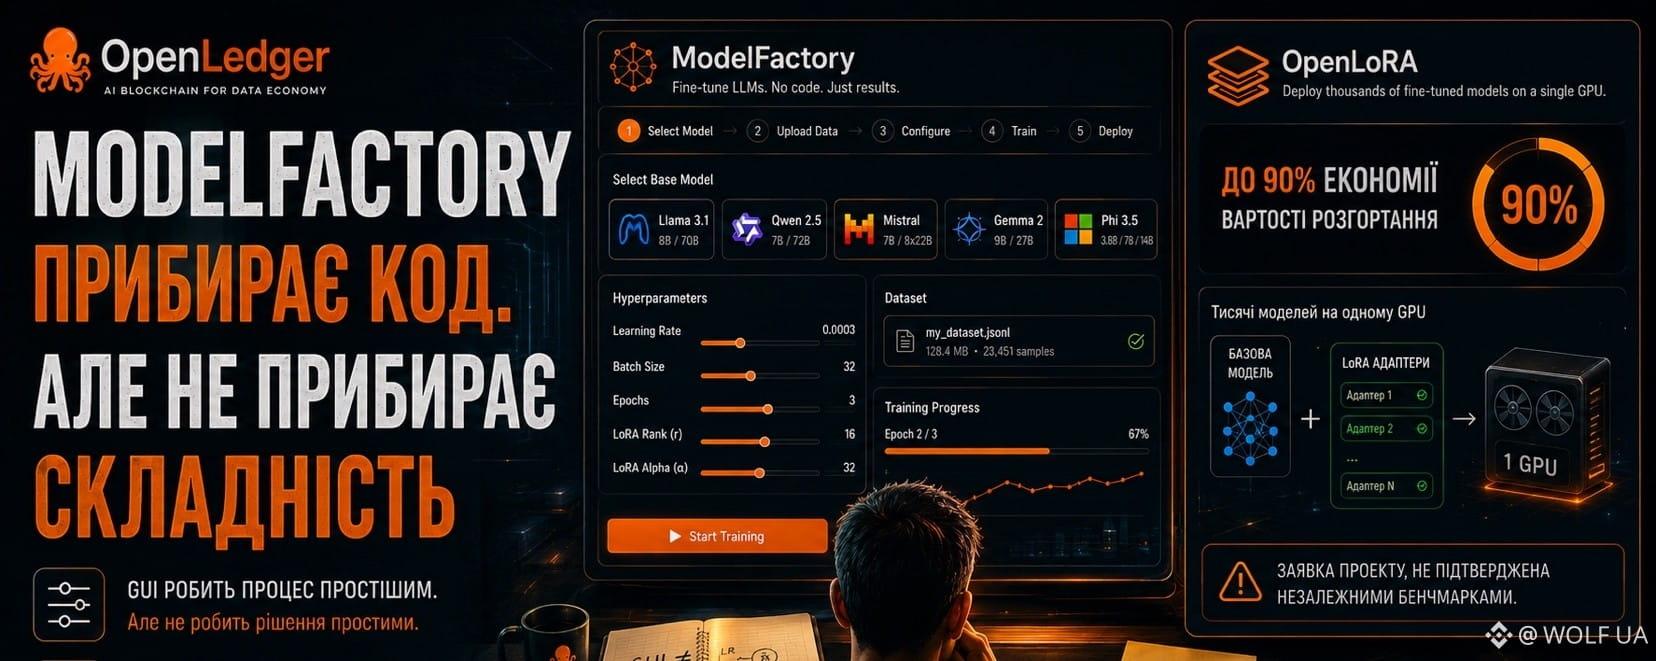
アイデアそのものは強力です。コードを書く代わりに、Pythonスクリプトを実行してMLツールを扱うことに取り組むのではなく、ユーザーはグラフィカル・インターフェースを使えます。モデルを選び、自分のデータを読み込み、パラメータを設定して、スタートを押すだけです。
ファインチューニングを一度もやったことがない人にとっては、これは本当に大きな参入障壁を取り除いてくれるかもしれない。
でもドキュメントを読んでいる間に、こんな考えをふと掴んだ。インターフェースはコードを隠すけれど、解決策までは隠してくれない。
学習率、バッチサイズ、エポックのスライダーはただのものに見える。けれども問題は、それが自分のタスクにとってどんな意味を持つのかを説明してくれないことだ。全部を当てずっぽうに設定すると、モデルはほとんど学習できないか、逆に悪い方向に動き始めることすらある。
OpenLoRAでもまったく同じ感覚が生まれた。そもそものコンセプトは技術的に妥当そうだ。軽量なLoRAアダプターなら、GPUをより効率的に使える。けれども「最大90%の節約」といった数字になると、もはやプレゼンを見たいというより、独立した計測結果を見たい気持ちになる。
私にとって絵がこのように見える限りでは、良いエンジニアリングのアイデアはもうある。問題はそれがそもそも動くかどうかではなく、デモやプロトタイプの外でどれくらい機能するかだ。
ちなみに、実際にファインチューニングをやった人の話を聞いてみたい:GUIでは足りなくなって、コードで完全に制御したくなるのはどのタイミング?
