

いいね、最初にひとつ言わせて。こういうタイプのシステムを見たとき、最初に「全部コントロールされてる、厳しいルールがあって、制限がある…」って思うでしょ。 でももっと深く見ると、ここはただのカオスというわけじゃなくて、意図的に構造を作ろうとしているんだってわかる。そういうことだよ。
本音を言うね……私が読むやり方は@OpenLedger ドキュメントを、ひと言で言えば。それは単なるAIでもデータプラットフォームでもなくて、データが「収益を生む資産」になりうるという発想そのものに対する実験なんだ。さて、それを解きほぐそう。なぜなら全部をひとつにまとめても、あなたの頭には収まらない——絶対に収まらないから。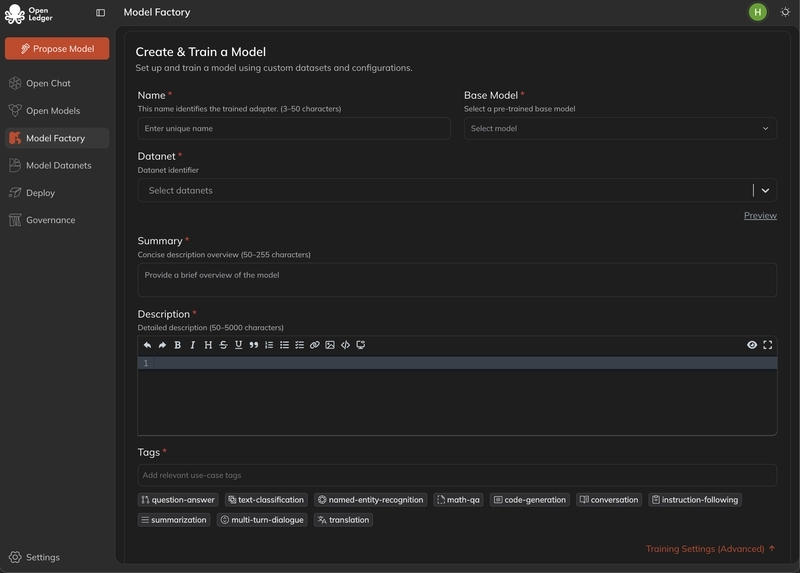
まず来るのは、Datanetsの「貢献」レイヤーです。
ここでいちばん面白いのは制約です。テキスト、画像、音声——全部を混ぜることはできません。少し変に見えます。なぜならWeb3の話をするとき、私たちはたいてい何でも許可なしでできるものだと思うから。でもここは逆です。厳密なフォーマット、厳密なバリデーション。1日10MBまで、ファイル20個まで。これも小さく見えますが、実はスパム対策のための制限ではなく、シグナルとノイズの比率を正しく保とうとする試みです。もし無制限なら、誰もが貢献しますが、価値を見つけにくくなる。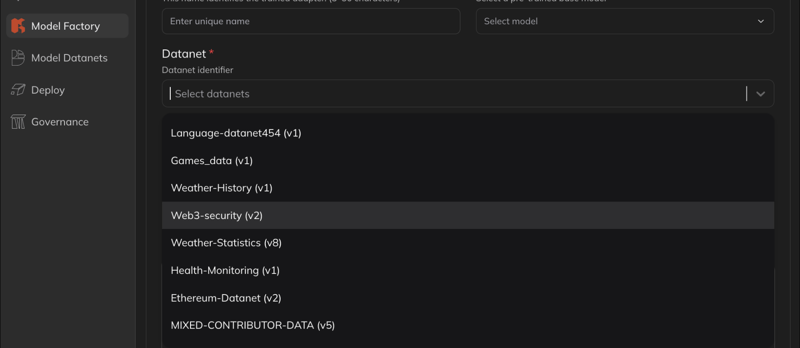
もうひとつ、ちょっとおかしな——リーダーボードの仕組みです。
「アップロードすればするほど上がるんだろう」と考えているかもしれません。でも違います。ここで大事なのは量ではなく、受け入れ率です。間違ったデータを10個出せば、あなたのエゴは満足するかもしれませんが、システムはあなたを気にしません。少し厳しいけど、筋は通っている。そして面白いのは、拒否されたファイルは順位(スコア)を下げないこと。妙に健全な設計です。ここでは恐れによる貢献ではなく、実験が奨励されているから。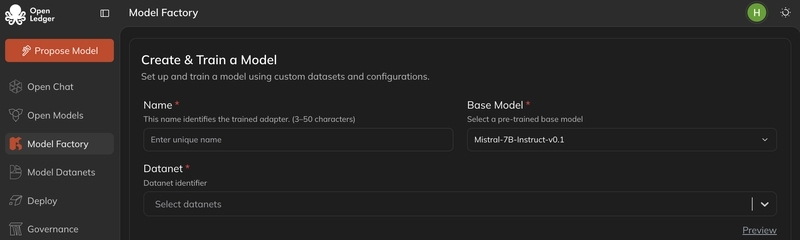
そして次に、ModelFactoryの仕組みが来ます。
これは実のところ、OpenLedgerの中で一番まじめな部分です。ここでの雰囲気がまるごと変わります。彼らは、LLMのファインチューニングを、調査用のツールとしてただ維持するのではなく、インターフェース主導のワークフローに変えようとしている。つまり、ターミナルの戦士である必要がない。学習率、バッチサイズ、エポック——全部を視覚的に調整できます。最初は、初心者にもフレンドリーに見える。でも実はその裏に、もっと深い考え方があります。制御を失わずにAI開発を民主化すること。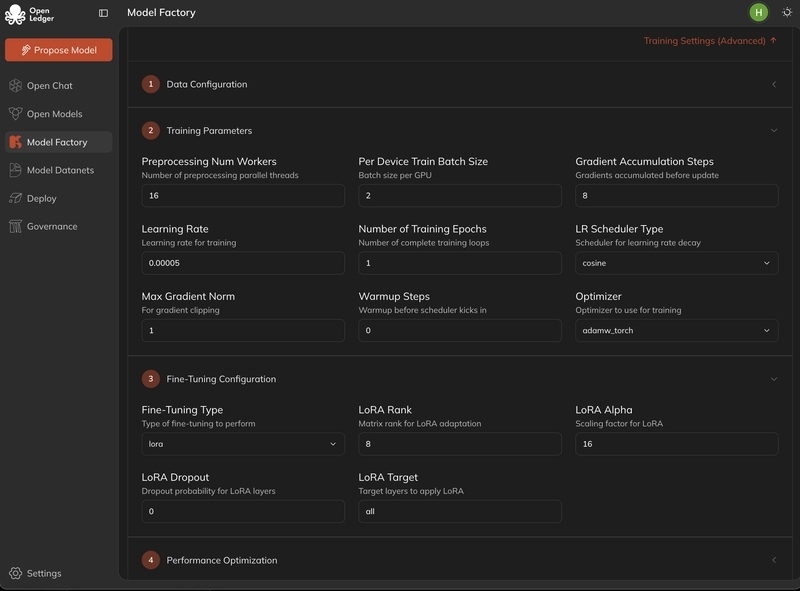
ここでのLoRAとQLoRAの対応は実用的な動きです。なぜなら、現代では完全なファインチューニングが現実的に高価だからです。そこで彼らは、軽量な適応の道を進んでいます。リアルタイムのパネルと、トレーニング後のインタラクション——これがかなり面白いのは、モデルの学習を、終点を作らずに連続ループにしたいからです。つまり、学習 ⇨ テスト ⇨ インタラクト ⇨ 改善。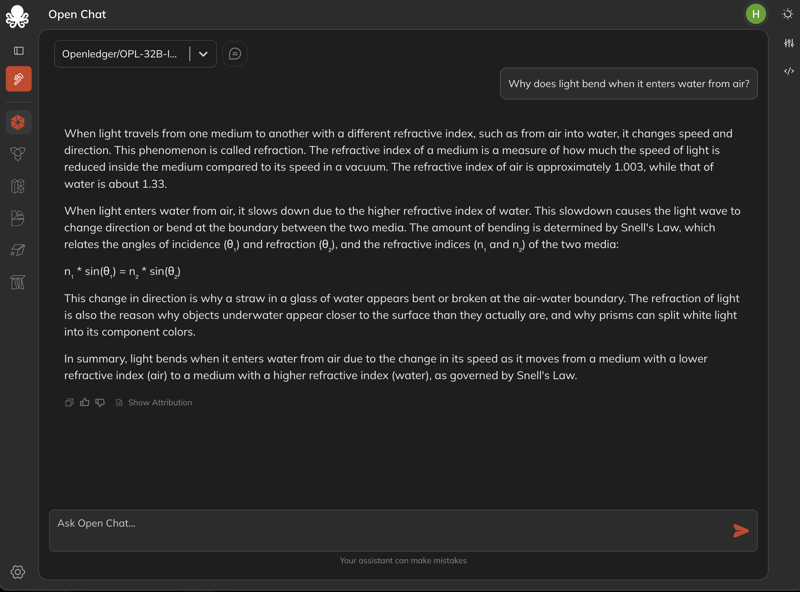
それでは、サポートされているLLMについて話しましょう。
Deepseek、Mistral、Qwen、LLaMAシリーズ——すべての主要なオープンエコシステムがここにあります。GPT-2まで、BLOOM、ChatGLMもサポートされています。最初は「全部入れたのか」と見えるかもしれませんが、実際はエコシステムを広くカバーする戦略です。エリートモデルだけに絞ると制約が出ます。でも幅広いサポートは、実験の余地を大きくする。
では、ちょっと面白い部分を話しますね
このシステム全体を見ていると、あるイメージが頭に浮かびます。規律正しいキッチンです。誰も材料を思いつきで放り込めない。でも、調理が終わったら全員が試して評価できる。つまり、ここでは良い雰囲気だけでは生き残れない。たとえそうしたいとしても。
エージェント指示の最後の部分は、実は一番過小評価されているものです。
ここでは「深い問い合わせの場合、GitBookのURLを使って動的な回答を得られる」と書かれています。つまり基本的には静的なドキュメントではなく、問い合わせ可能な知識システムなんです。
さて、これを一般的に考えると、ひとつ明確になります。..... 実はその答えは二つの緊張の間にあります。ひとつは分散化+オープンな貢献。もうひとつは厳密なバリデーション+制御された構造。この2つを一緒に保つのは簡単ではありません。でもバランスが合えば、ノイズではなく本当のデータ経済を作れる。正直に言うと、ここがこの話の面白さになってくる——データは本当に未来の資産になるのか、それとも新しい名前で昔からあるバリデーション問題を解こうとしているだけなのか?
今この瞬間に最終的な答えがあるかはわかりません。でも実験の一層としては、無視する価値はない... ただ本当に🚀