

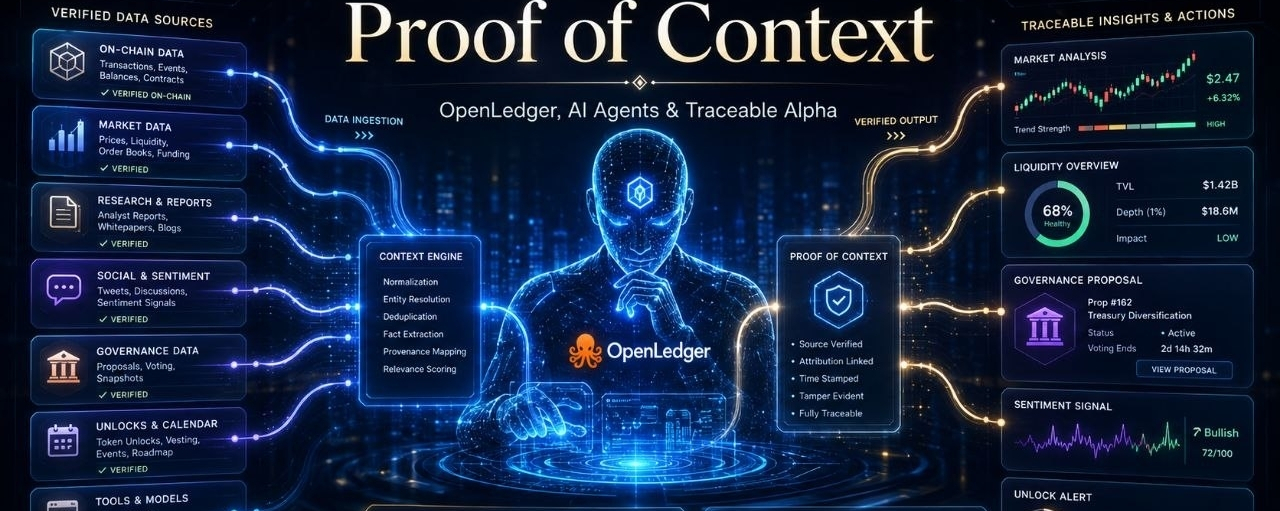
クリプトのトレーディングから学んだことの一つは、生の知性だけでは不十分だってことだ。スピードも重要だし、より良いモデルも必要だ。でも、文脈が良いエントリーとボロボロのトレードを分けることが多い。モデルが「このトークンは強そう」と言っても、アンロック、ガバナンス投票、薄い流動性、悪いデータ、突然のセンチメントの変化を見逃すと、その「強い」シグナルはすぐに出口流動性に変わることがある😅
だから、OpenLedgerのAIエージェントの方向性は面白いと思う。@OpenLedger 自らをAIブロックチェーンインフラとして、Datanetsと呼ばれるコミュニティ所有のデータセットを用いた専門的なモデルのトレーニングとデプロイに役立つと説明している。そして、データセットのアップロード、モデルのトレーニング、報酬、ガバナンスなどのアクションはオンチェーンで行われる。これは重要だ。なぜなら、AIエージェントはプロンプト以上のものが必要だからだ。彼らには信頼できる文脈、追跡可能なデータ、そして人々がその知識レイヤーを改善し続ける理由が必要だ。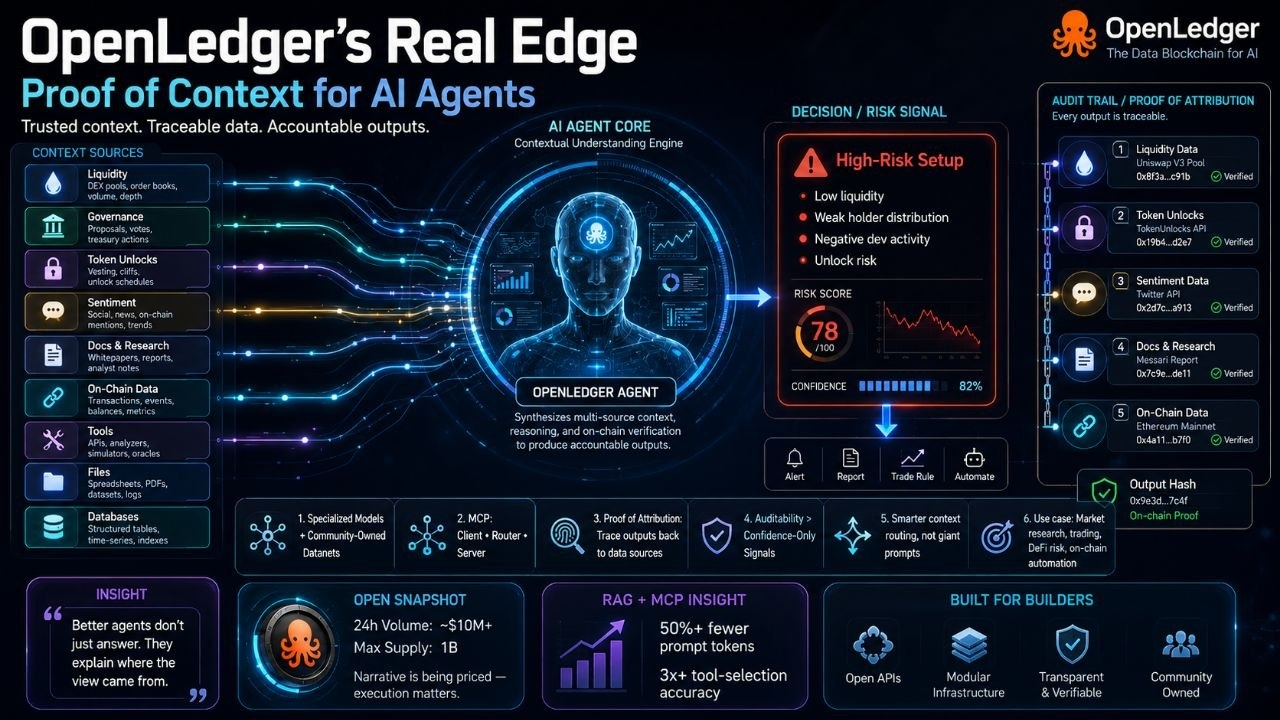
私が今注目しているテーマは、OpenLedgerの「Model Context Protocol(MCP)」の観点です。エージェント重視の資料の中でOpenLedgerは、MCPを、モデルが外部の状態、ツール、ファイル、データベース、そして実行可能なレスポンスにアクセスするための構造として説明しています。クライアント、サーバー、ルーターのフローを使うことで、モデルがコンテキストを受け取り、ツールとより整理された形でやり取りできるようになります。
ビルダーにとって、それは単なるオタク的なインフラではありません。チャットボットと、役に立つエージェントの違いなんです。
OpenLedgerでマーケットリサーチ用のエージェントを作ることを想像してください。基本的なボットなら、トークンニュースを要約するかもしれません。より良いボットなら、流動性データを引き出し、それをソーシャルの勢いと比較し、ドキュメントを読み、ガバナンス提案を確認し、アンロックのリスクをフラグします。でも本当のアルファは、エージェントが「自分の見解はどこから来ていて、どのデータソースが出力を形作ったのか」を説明できるときに生まれます。そこでOpenLedgerのProof of Attributionが強力になります。OpenLedgerはProof of Attributionを、AIの出力をデータソースや貢献者まで遡って追跡するための方法だと位置づけています。つまり、貢献者はブラックボックスの学習パイプラインに消えるのではなく、クレジットされ報われるということです。
ここでの私の取引ロジックはシンプルです。AIエージェントには、単に「確信」を与えてほしくない。監査可能性を与えてほしい。エージェントが「高リスクのセットアップ」と言ったなら、それが低い流動性なのか、弱い保有者分布なのか、ネガティブな開発活動なのか、あるいは拠出したDatanetsの過去のパターンなのかを確認したい。トレーサビリティのない確信は、単なる雰囲気です。トレース可能な確信は、ツールになります。
また、スケーラビリティの論点もあります。近年のRAG-MCPに関する研究では、検索ベースのツール選択によってプロンプトトークンを50%以上削減でき、ベンチマークテストではツール選択の精度が3倍以上に向上したことが分かっています。これは、エージェントには巨大で過負荷なプロンプトではなく、より賢いコンテキストのルーティングが必要だという考えを裏付けます。OpenLedgerのエージェントスタックは、その方向性に合致しています。専門化されたデータセット、専門化されたモデル、コンテキスト・ルーティング、アトリビューションの仕組みが連携して動きます。
そして市場面でも、OPENはすでに真剣にウォッチできるほど流動性が十分です。CoinGeckoによれば、確認時点で24時間の出来高が約$10M以上、最大供給量は1Bです。だからといって「買い」を意味するわけではありません。つまり、市場がその物語(ナラティブ)を実際に価格づけしているということです。だからビルダーやトレーダーは、単なる盛り上がりではなく、実行(execution)を評価すべきです。
より大きな全体像は?OpenLedgerは、AIエージェントを神秘的な予測マシンのような存在から、説明責任のある市場運営者へ近づけられるかもしれません。取引、リサーチ、DeFiのリスク、オンチェーン自動化において、それは大きな転換です。暗号資産の世界では誰もがアルファが大好きです。でも次の波は、そのアルファがどこから来たのかを証明することかもしれません。 $OPEN #OpenLedger