

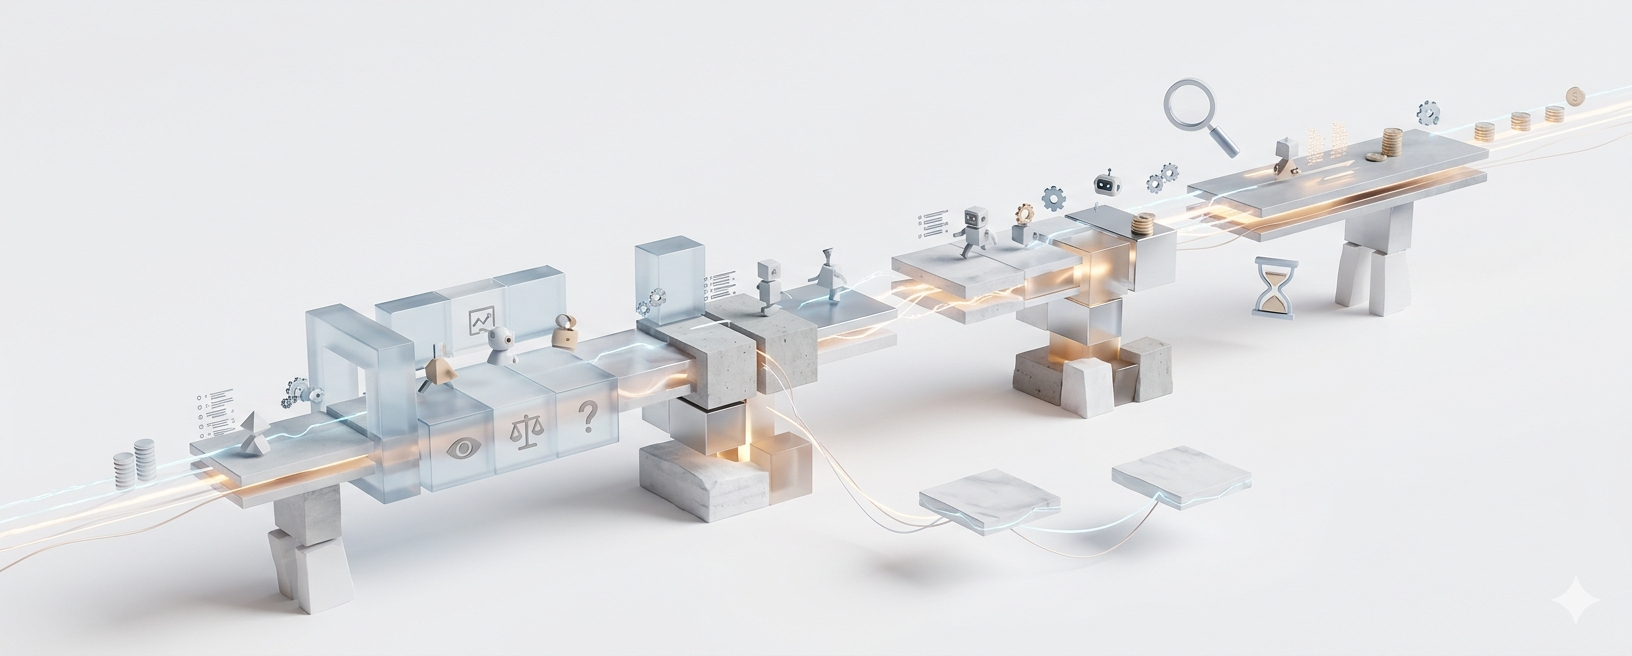
OpenLedgerは橋のように感じる。実際に何をつなげているのか、ずっと聞いている。
私はしばらくの間OpenLedgerを見ているが、ファンというわけではなく、むしろ建設現場の近くに立って、壁ができる前に何が作られているのかを理解しようとしている。
OpenLedgerのアイデアは、紙の上ではシンプルで、データとモデル、エージェントと価値との間の橋であり、OpenLedgerの活動を所有権と流動性に結びつけるものだ。
OpenLedgerを初めて聞いたときは、クリーンすぎる感じがした。
本物のOpenLedgerシステムは、言葉ではなく行動を見始めると決してきれいではありません。
最初に気づくのは、OpenLedgerが実際には一つのものではなく、互いに重なり合っている層のように感じることです。OpenLedgerのデータが流れ、OpenLedgerのエージェントがそれに基づいて行動し、OpenLedgerのモデルがそれから学び、そしてその間でOpenLedgerの価値が追跡され、分配されるはずです。
その間が私をずっと悩ませている部分です。
私が見てきたOpenLedgerシステムでは、あまりにも多くのことが自動的に起こると、責任が薄くなります。壊れているわけではなく、ただ薄くなるのです。注意深く見ればまだ透けて見えるような状態です。
私は自分に問いかけ続けています。OpenLedgerのエージェントが速く動き出したとき、実際に何を検証しているのは誰なのでしょうか?
OpenLedgerのデザインには何かがありますが、それは明らかにスピードのために構築されています。OpenLedgerのエージェントはあまり待たず、反応し、適応し、続けます。そのようなOpenLedgerの構造は、伝統的なシステムが依存している摩擦を通常取り除きます。
摩擦は必ずしも悪いことではありません。時には、摩擦が人間に間違いに気づく時間を与えることがあります。
それがないと、リアルタイムで監査するのが難しいが効率的なシステムになります。
私は、暗号とAIに関する試みについて考えます。ほとんどは、価値と貢献の間の調整の約束から始まりますが、後に実際に貢献がどのように測定されるのかが不明確になります。理論ではなく、混沌とした実際の使用においてです。
OpenLedgerはその解決を試みているように感じます。まだ完全に安定した答えは見当たりませんが、誰もがそうかもしれません。
もう一つ、私が何度も考え直しているのは、OpenLedgerのデータ所有権の理論です。OpenLedgerのユーザーはデータを提供し、帰属や価値を得ますが、実際のOpenLedgerシステムではデータはきれいには分離できず、あるOpenLedgerのデータが別のOpenLedgerに影響を与えます。すべてのOpenLedgerモデルはリミックスされるので、OpenLedgerの所有権は一体どこから始まり、どこで終わるのでしょうか?
その線は単なる技術的なものではなく、すぐに哲学的になります。
そして、OpenLedgerエージェントの層があります。それがより自律的になるほど、OpenLedgerシステムは予測可能に感じます。怖い意味ではなく、後でこれを追跡できるかという意味でです。
なぜなら、速いOpenLedgerシステムは賞賛しやすいですが、それらの内部で何が起こったのかを再構築しようとすると、難しくなります。
時々、私はOpenLedgerのインテリジェンスに対する流動性のこの全体的なアイデアが、実際には調整を説明する新しい方法なのか、それとも本当に何か新しいもので、まだ安定していないだけなのか疑問に思います。
結論は出ていませんが、OpenLedgerについては、一度のきれいなパスで理解されるものではないと思います。
私は一つのシンプルなことについて考え続けています。もしOpenLedgerのエージェントが継続的に行動し、OpenLedgerの価値が継続的に分配されるなら、実際にその継続性を見守っているのは誰なのでしょうか?
さらに重要なのは、OpenLedgerのフローの奥深くで何かが間違った場合、誰かがそれに気づくまでにどれくらいの時間がかかるのかということです。
おそらく、ここでの試験は、OpenLedgerのブリッジ自体のアイデアではなく、すべてのステップを見ずに何がそれを横切っても信頼できるかどうかです。
私はまだそのようにOpenLedgerを見守っています。納得はしていませんが、排除もしていません。ただ、実際に重みがどこにあるのか疑問に思っています。