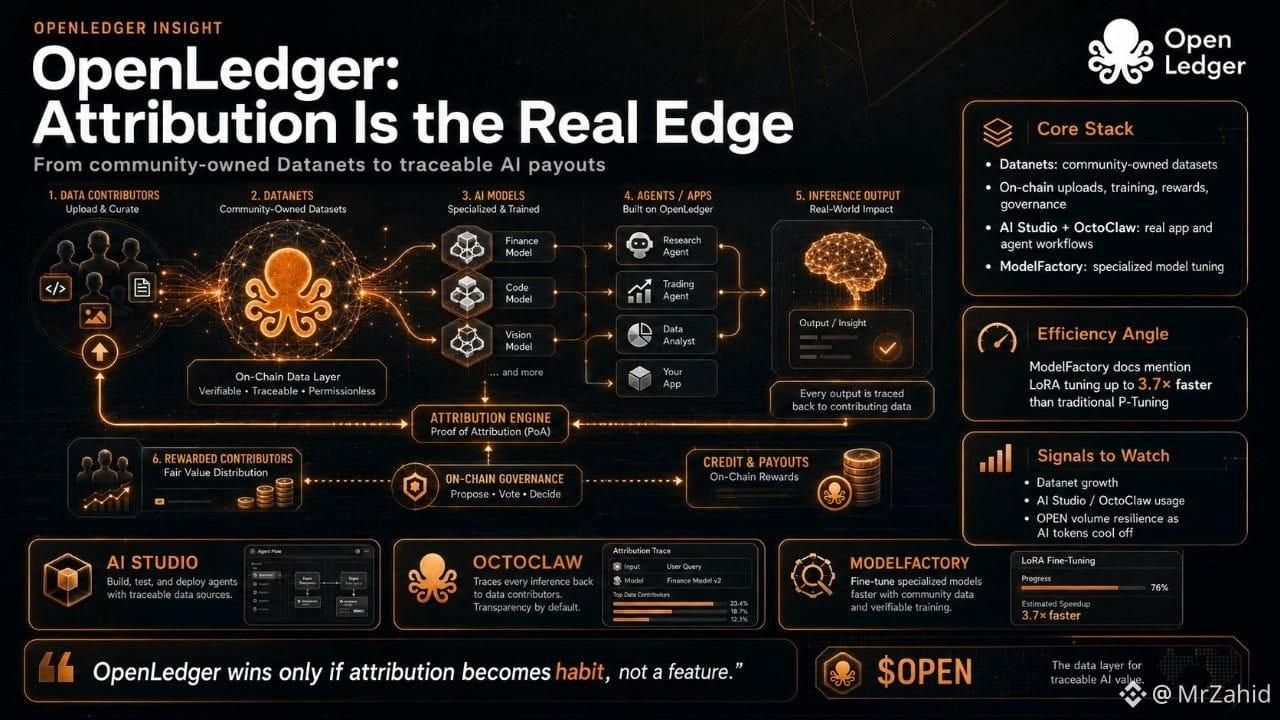
俺はちょうどOpenLedgerのドキュメントとサイトをチェックし終えたんだけど、実際に印象に残ったのはいつもの「AI x ブロックチェーン」ピッチじゃなくて、アトリビューションレイヤーなんだ。OpenLedgerは、アップロード、モデルのトレーニング、報酬クレジット、ガバナンスがオンチェーンにあるコミュニティ所有のデータセットであるDatanetsの周りで構築している。これは大事なことだ。なぜならAIの価値は上に漏れやすいから:ユーザーがデータを作り、モデルがそれを吸収し、プラットフォームがそれをマネタイズし、貢献者は雰囲気を得る。
OpenLedgerがひっくり返すのは、支払いのロジックだ。もしアトリビューションの証明がどのデータが推論に影響を与えたかを追跡できるのなら、データは単なる原材料ではなく、取引可能な生産的資産になる。だから、俺はOpenLedgerをミームチャートのように見るんじゃなくて、インフラプレイとして見るべきだと思う:需要は、検証されたデータ、専門的なモデル、エージェントワークフローを必要とするビルダーから来るはずで、リテールのハイプだけじゃない。
俺のトレード論理はシンプルだ:緑のキャンドルを盲目的に追いかけることはしない。まずは三つのシグナルを追跡する:Datanetの成長、AI Studio/OctoClawからの実際のアプリ使用、そしてOPENのボリュームが健康なままで広範なAIトークンが冷やされるかどうかだ。ドキュメントではModelFactoryのLoRAチューニングが従来のP-Tuningよりも最大3.7倍速いと主張しているが、これは本当に効率的なアングルだ。
ホットテイク:OpenLedgerはアトリビューションが習慣になれば勝つ、機能ではなく。🚀
使用したソース:OpenLedgerのドキュメントはDatanets、オンチェーンアクション、アトリビューション、ガバナンスを説明している;サイトはOctoClawとAI Studioを強調し、ModelFactoryのベンチマークでは最大3.7倍速いLoRAチューニングに言及している。
@OpenLedger $OPEN #OpenLedger