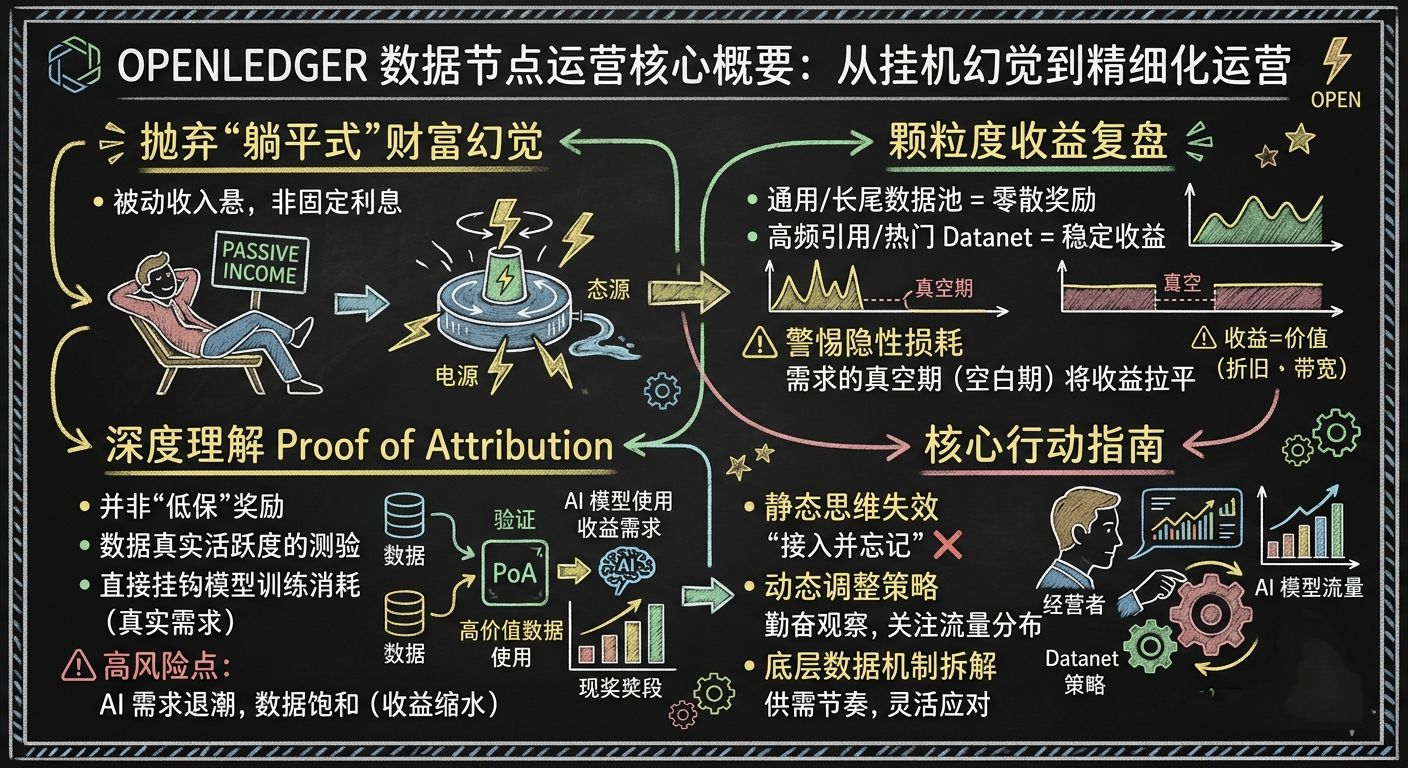
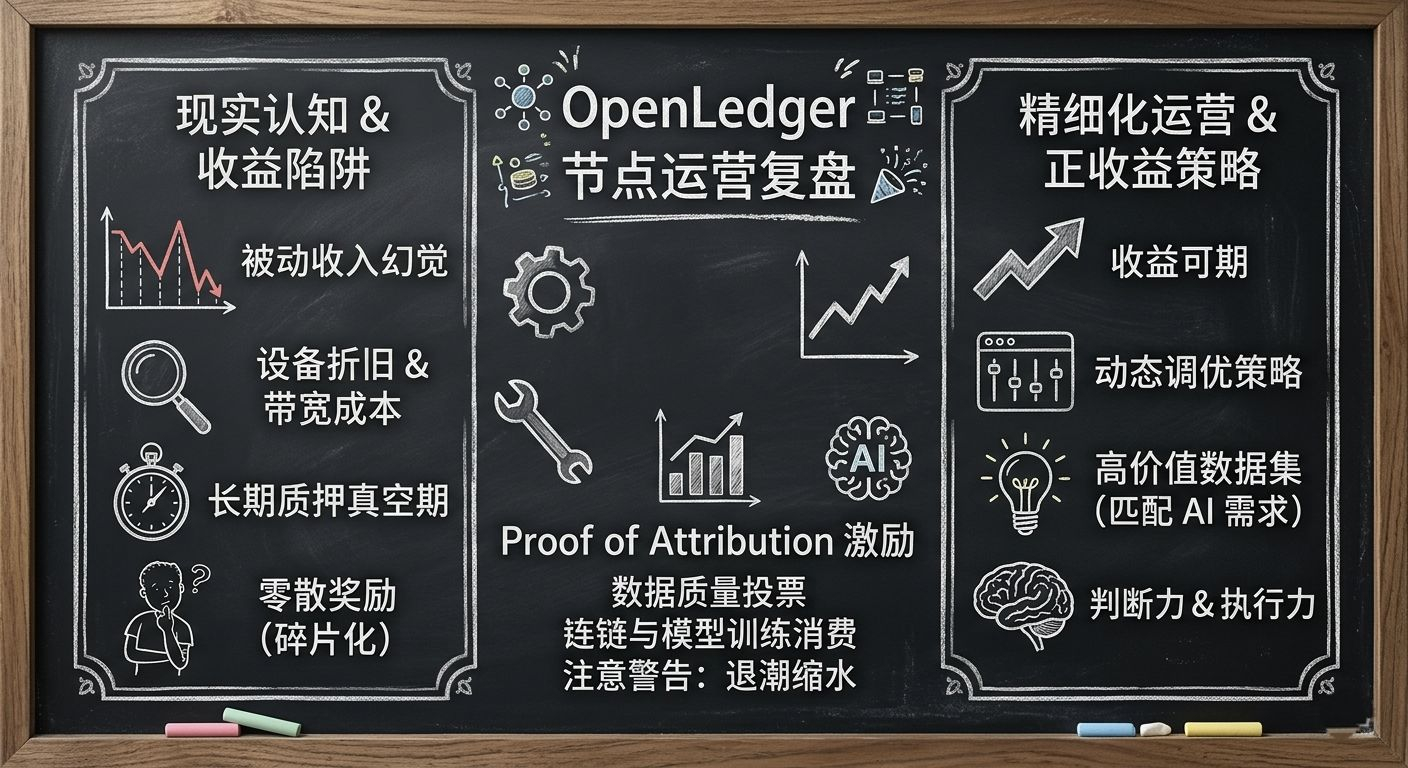
最近俺また@OpenLedger のエコシステムにいくつかのデバイスを追加投資したんだ。この期間のDatanetの粒度利益を深掘りしてみたら、心の持ちようが最初に参入した時よりもずっと落ち着いてきたよ。多くの人がAIデータノードを単純に考えすぎていて、機械を稼働させるだけで、アカウントにある$OPEN が自動的に増え続けると思ってる。この「寝てるだけ」スタイルの富の幻想は、実際には多くの参入者の白昼の夢に過ぎない。
俺は過去のインタラクション履歴を振り返ってみた。単に稼働時間を追求して、長尾データプールやニッチなデータに接続した結果、電気代やネットワークの損失を除いた後のROIは驚くほど低い。多くの人がいわゆるエアドロップの期待に踊らされて、AIトレーニングの文脈では低品質なデータには全く議決権がないことを見落としている。せいぜい無効な負荷をプロトコルに提供しているだけだ。OpenLedgerで長期的な利益モデルを構築したいなら、データの資産化の理解がカギになる。ノードは単なる物理端末ではなく、動的に調整が必要なデータポータルだってことを理解しなきゃならない。比較してみると、安定して利益を生むノードは、例外なく現在の主流モデルのトレーニングニーズに正確にマッチしているDatanetだ。ここには大きな認知のギャップがある:ほとんどの人が現在のAPYしか見ていないが、AIトレーニングの計算力ニーズは段階的に変動するんだ。そのため、需要のピークの前にデータキャッシュの配置をしっかりやっておかないと、あなたの帯域幅とストレージはほとんどの時間、無駄に回っていることになる。
それから、#OpenLedger の注目されているインセンティブメカニズムについても話そう。長時間の観察を通じて、いわゆる利益分配は本質的にエコシステムが高価値データセットに即時に価格を付けていることに気づいたよ。もしあなたのデータが大モデルの微調整や検索強化生成の重要な経路に直接ヒットしないのであれば、ノードのオンライン時間がどれだけ長くても、報酬メカニズムはアルゴリズムの重み付けでそれをフィルタリングしてしまうだろう。
要するに、$OPEN のトラックでは、静的な構成戦略は完全に機能しなくなっている。未来の利益のスペースは、本当にノードをデータファクトリーとして精緻に運営する人だけに属する。覚えておいて、OpenLedgerが報酬するのはあなたのデバイスのオンライン時間ではなく、あなたがデータ供給者としてこのAI革命の波に対する判断力と実行力だ。
俺は過去のインタラクション履歴を振り返ってみた。単に稼働時間を追求して、長尾データプールやニッチなデータに接続した結果、電気代やネットワークの損失を除いた後のROIは驚くほど低い。多くの人がいわゆるエアドロップの期待に踊らされて、AIトレーニングの文脈では低品質なデータには全く議決権がないことを見落としている。せいぜい無効な負荷をプロトコルに提供しているだけだ。OpenLedgerで長期的な利益モデルを構築したいなら、データの資産化の理解がカギになる。ノードは単なる物理端末ではなく、動的に調整が必要なデータポータルだってことを理解しなきゃならない。比較してみると、安定して利益を生むノードは、例外なく現在の主流モデルのトレーニングニーズに正確にマッチしているDatanetだ。ここには大きな認知のギャップがある:ほとんどの人が現在のAPYしか見ていないが、AIトレーニングの計算力ニーズは段階的に変動するんだ。そのため、需要のピークの前にデータキャッシュの配置をしっかりやっておかないと、あなたの帯域幅とストレージはほとんどの時間、無駄に回っていることになる。
それから、#OpenLedger の注目されているインセンティブメカニズムについても話そう。長時間の観察を通じて、いわゆる利益分配は本質的にエコシステムが高価値データセットに即時に価格を付けていることに気づいたよ。もしあなたのデータが大モデルの微調整や検索強化生成の重要な経路に直接ヒットしないのであれば、ノードのオンライン時間がどれだけ長くても、報酬メカニズムはアルゴリズムの重み付けでそれをフィルタリングしてしまうだろう。
要するに、$OPEN のトラックでは、静的な構成戦略は完全に機能しなくなっている。未来の利益のスペースは、本当にノードをデータファクトリーとして精緻に運営する人だけに属する。覚えておいて、OpenLedgerが報酬するのはあなたのデバイスのオンライン時間ではなく、あなたがデータ供給者としてこのAI革命の波に対する判断力と実行力だ。