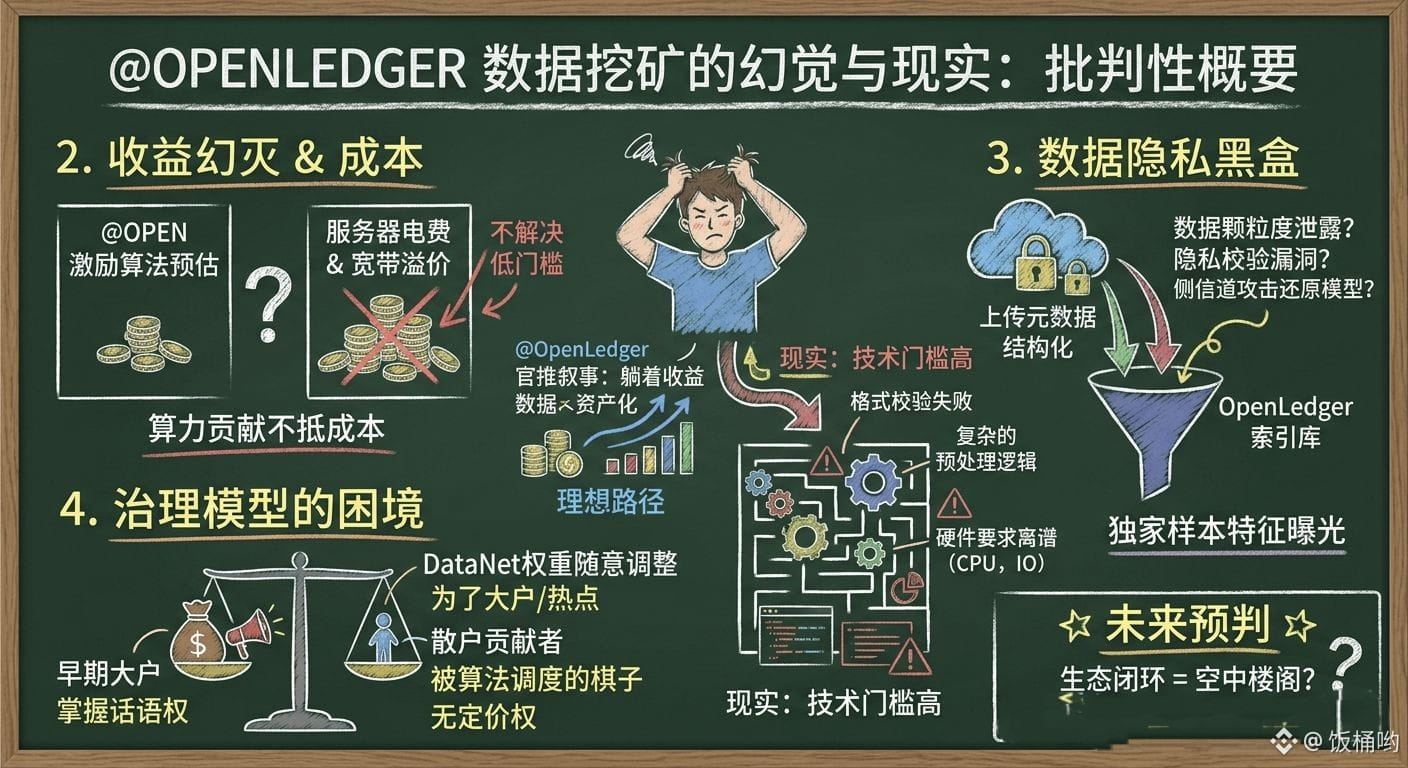
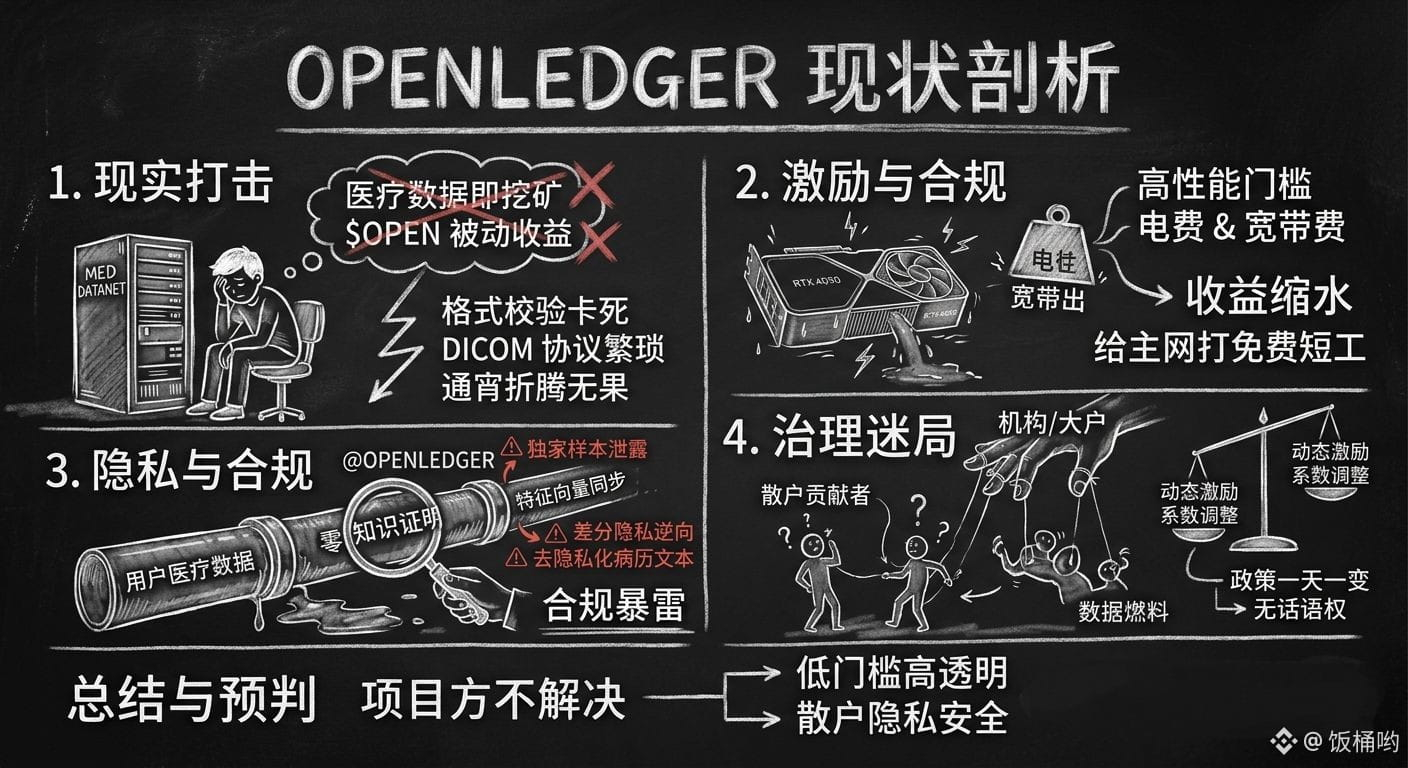
数日前、広場で@OpenLedger のAI医療画像アノテーションプラットフォームが話題になっていて、思わずスタジオに貯めていた皮膚病理切片データセットをMed DataNetにアップロードしてしまった。結局、一晩中格闘して、フォーマット検証の段階で動けなくなり、複雑なDICOM変換プロトコルとラベルの整合性の論理にほぼ崩壊寸前に。\n\n自分が以前、彼らの公式からの医療データとマイニングの壮大な物語に煽られて、底に眠る資産をアップロードすれば$OPEN のパッシブインカムが得られると幻想を抱いていたのを認めざるを得ない。しかし、検証ノードをデプロイする段階で、現実が私に一発の平手打ちを食らわせてきた。公式ドキュメントでは、これを低いハードルの共同構築と呼んでいるが、実際にはVRAMとネットワーク帯域幅のスループット要求が高すぎて驚愕。自分の4090最高スペックワークステーションで三日間走らせた結果、彼らの最新のダイナミックインセンティブ方程式を計算したところ、終日フル稼働の電気代と商業用ブロードバンド代を差し引いたら、手元に残った$OPEN はコーヒー一杯を買うのもやっとで、純粋にメインネットで無料の短期労働をしていたに過ぎない。\n\n収益が縮小する以上に恐ろしいのは、基盤データの権利確定とコンプライアンスの底なし沼。@OpenLedgerは、会う人すべてに彼らのゼロ知識証明と同態暗号技術を自慢し、データは利用可能だが見えないと称している。しかし、実際の操作では、高レベルのインセンティブウェイトを得るためには、データの特徴ベクトルと去匿名化された病歴テキストをパッケージ化して同期させる必要がある。医療データは口頭では去中心化匿名保存とされているが、誰が検索層のルーティングノードがハッカーによって差分プライバシーの逆工学で攻撃されないと保証できるだろうか?一度独占サンプルが漏洩したら、責任を負うのは我々データを提供したデジタルマイナーではないのか?#OpenLedger \n\nさらにひどいのは、$OPEN の現在のコミュニティガバナンスの雰囲気。政策が日々変わり、我々散発的な個人投資家には知る権利すらなく、ましてや発言権などない。要するに、庄家のアルゴリズムに何度も収穫される燃料として扱われている。今や完全に夢から覚めた。@OpenLedgerはAI生産資材の配分方式を本当に覆そうとしているのか、それとも去中心化AIの殻を借りて新たなトラフィックを描く餌をまいているのか、議論の余地はない。この言葉をここに置いておく。プロジェクト側が散発的な個人投資家のプライバシーの安全と収益の透明性を軽視する限り、大口がコミュニティで左右に手を動かすだけで、このいわゆるWeb3+AIの物語は結局のところ蜃気楼に過ぎない。