OpenLedgerと、AIがついに同じ壁にぶつかっているかもしれないという奇妙な感覚。
私は暗号資産の世界に十分長くいるので、プロジェクトが「何かを再定義する」と主張するたびに毎回反応しないようになりました。
ほとんどの場合、それらの言葉は同じ古いインセンティブを包み直しただけの使い回しです。新しいトークン、新しいブランディング、でも根本の現実は同じ――少数のインサイダーが価値をつかみ、群衆が流動性を提供し、そして最終的に物語はどこか別の場所へ移っていきます。
たぶんそれが、最近AIに結びついたものに対して興奮するのが遅くなってしまった理由でしょう。すでに、この分野は大げさな約束であふれかえっているように感じます。毎週のように、知能を分散化するとか、エージェントをトークン化するとか、計算を作り直すとか、あるいはインターネットそのものを置き換えるとか、とにかく別のプロトコルが出てきます。しばらくすると、それらはすべて同じ種類のバックグラウンドノイズに溶け込んでしまいます。
でも時々、何かが私の注意を引きます。急にそれを信じたからではなく、本当に存在する問題に焦点を当てているように見えるからです。
OpenLedgerは、私にとってそういうタイプのプロジェクトです。
私は、それが機能すると言っているわけではありません。勝つとも言っていません。モデルが持続可能だとも言っていません。正直なところ、まだ分かりません。
でも私は、根底にある問いが、今のところ暗号資産界隈に漂うほとんどのAIの物語よりも、ずっと現実味があると感じ続けています。
問いはシンプルです。AIモデルが世界で最も価値ある仕組みの一部になりつつあるのに、なぜほとんど誰も、その価値がいったいどこから来ているのかをもう分かっていないのでしょうか?
最初は当然に聞こえます。でも深く考えるほど、AI経済全体がどれほど奇妙に見えてくるかが分かります。
今日のほとんどのAIシステムは、たいていは報酬も所有も、さらには承認さえも見たことがない人々から集めたデータの海の上に作られています。作家、アーティスト、研究者、掲示板のユーザー、開発者、ニッチなコミュニティ、無作為なインターネットのアーカイブ——それらすべてが取り込まれ、やがて数十億ドル規模の価値を持つ製品になっていきます。
そして不思議と、みんなそれを普通のことだと受け入れてしまったのです。
たぶん、仕組みが大きくなりすぎて問い直せなくなったからでしょう。たぶん、それを作る企業が規制よりも速く動いたからです。たぶん、モデルが一定の規模に達すると、現実的に帰属(アトリビューション)を追跡できなくなったからです。
最後の部分が重要です。
何年も前から、AIにおける最大の問題の一つは、そもそも帰属(アトリビューション)そのものです。モデルが十分な量のデータで学習すると、影響の追跡はぼやけてしまいます。全体がブラックボックスになります。役に立つブラックボックスであることもありますが、それでもブラックボックスです。
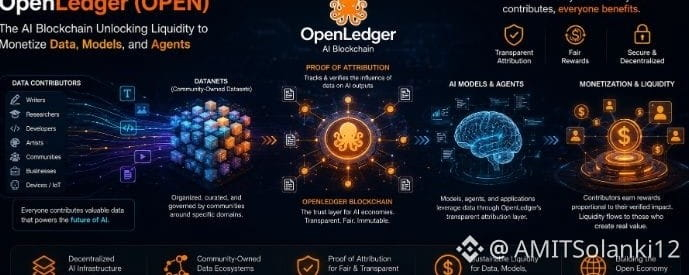
その部分こそ、OpenLedgerがこの「帰属証明(Proof of Attribution)」という考え方でずっと巡っているところです。
最初に読んだとき、その構想はあまりにも野心的に聞こえます。プロトコルは、モデルの出力をそれに影響したデータへと結びつけようとし、そのうえでネットワークを通じて貢献者に比例して報酬を与えます。
私は以前、暗号の世界で似たことがさまざまな形で試みられるのを見てきました。音楽ロイヤルティ。クリエイター・エコノミー。ストレージのインセンティブ。注目市場。データ市場。
結局ほとんどの人が同じ壁に突き当たりました。意味のある形で貢献を測るのは、あまりに残酷なほど難しいのです。$OPEN