タイトル:
OpenLedgerはAIチェーンのように感じられるが、$OPENは実際には計算ではなくデータの価格付けかもしれない 🧠🔍
分散型AI(DeAI)のランドスケープをよく見ると、90%のプロジェクトが同じに見える。彼らは計算パワーを商品化するレースをしており、基本的にはGPUを貸し出すための分散型サーバーファームを構築している。しかし、OpenLedger($OPEN)は静かに根本的に異なるプレイブックを実行している。
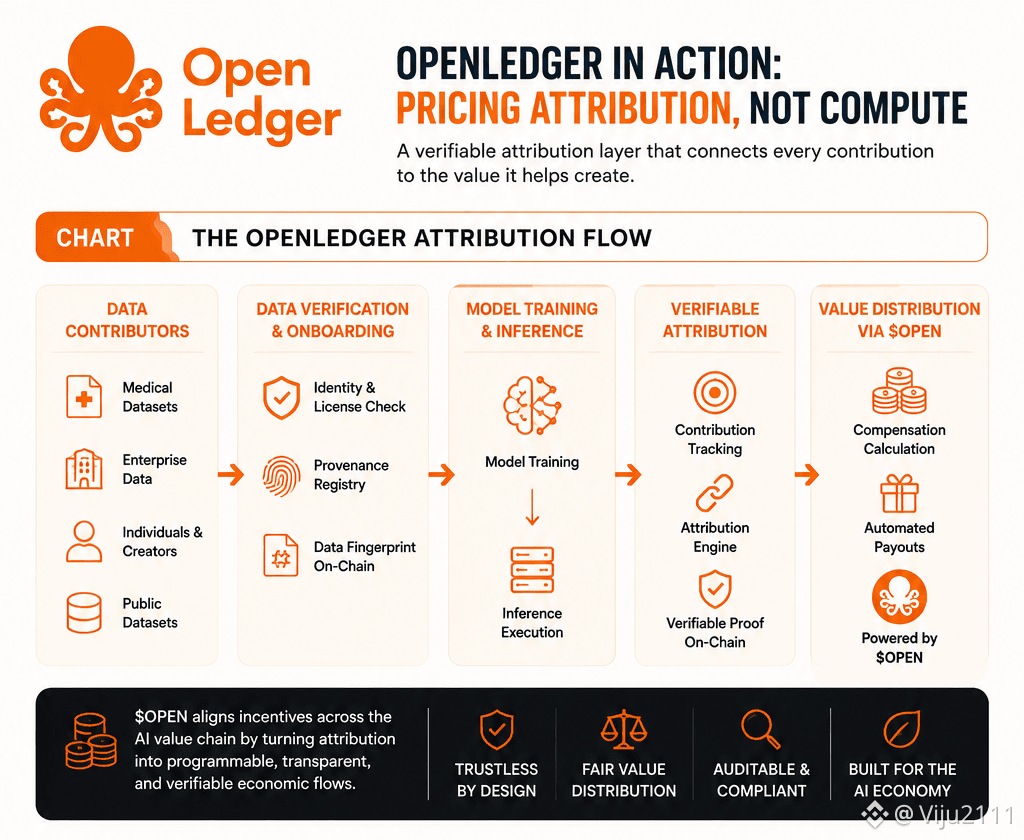
表面的には標準的な高性能AIブロックチェーンのように見え、呼吸し、行動しているが、そのコア経済エンジンは計算サイクルの価格付けではなく、AIデータの価格付けである。
この区別が$OPENの将来の価値にとって重要な理由はここにある。
計算トラップ vs. データボトルネック
GPUをレンタルする(分散型計算)は底辺へのレースだ。大手テック企業は巨大な中央集権型データセンターを構築しており、web3計算プロトコルは常に価格で互いに切り下げ合っている。計算は商品だ。
しかし、データはそうではない。今日のAIにおける最大のボトルネックはグラフィックカードを見つけることではなく、高品質で専門的、かつ検証可能にクリーンなデータを取得してモデルを訓練することだ。OpenLedgerのアーキテクチャは、OPスタックを使用してEVM互換インフラを構築し、このデータパイプラインに全く焦点を当てている。彼らが呼ぶDatanetsを通じて、コミュニティは専門的なデータセットをオンチェーンで共同作成、ホスト、キュレーションすることができる。
アトリビューションの証明(PoA)登場
ここが$OPENトークンの物理学が面白くなる部分だ。標準的なプルーフ・オブ・ワークやプルーフ・オブ・ステークのメカニズムを使用して単にトランザクションを保護するのではなく、OpenLedgerはアトリビューションの証明(PoA)を実装している。
💡 アトリビューションの証明は、特定のデータセット、LoRA、またはベースモデルが最終的なAIエージェントの出力にどのように影響を与えるかを正確に追跡するプロトコルレベルのメカニズムだ。
AIモデルが展開されたり、AIエージェントがクエリに応答したりすると、OpenLedgerは使用されたデータの系譜をオンチェーンで追跡する。あなたの提供したデータがそのモデルを微調整するのに役立った場合、プロトコルはそれを検証し、あなたにクレジットが付与されることを保証する。 @OpenLedger #OpenLedger