
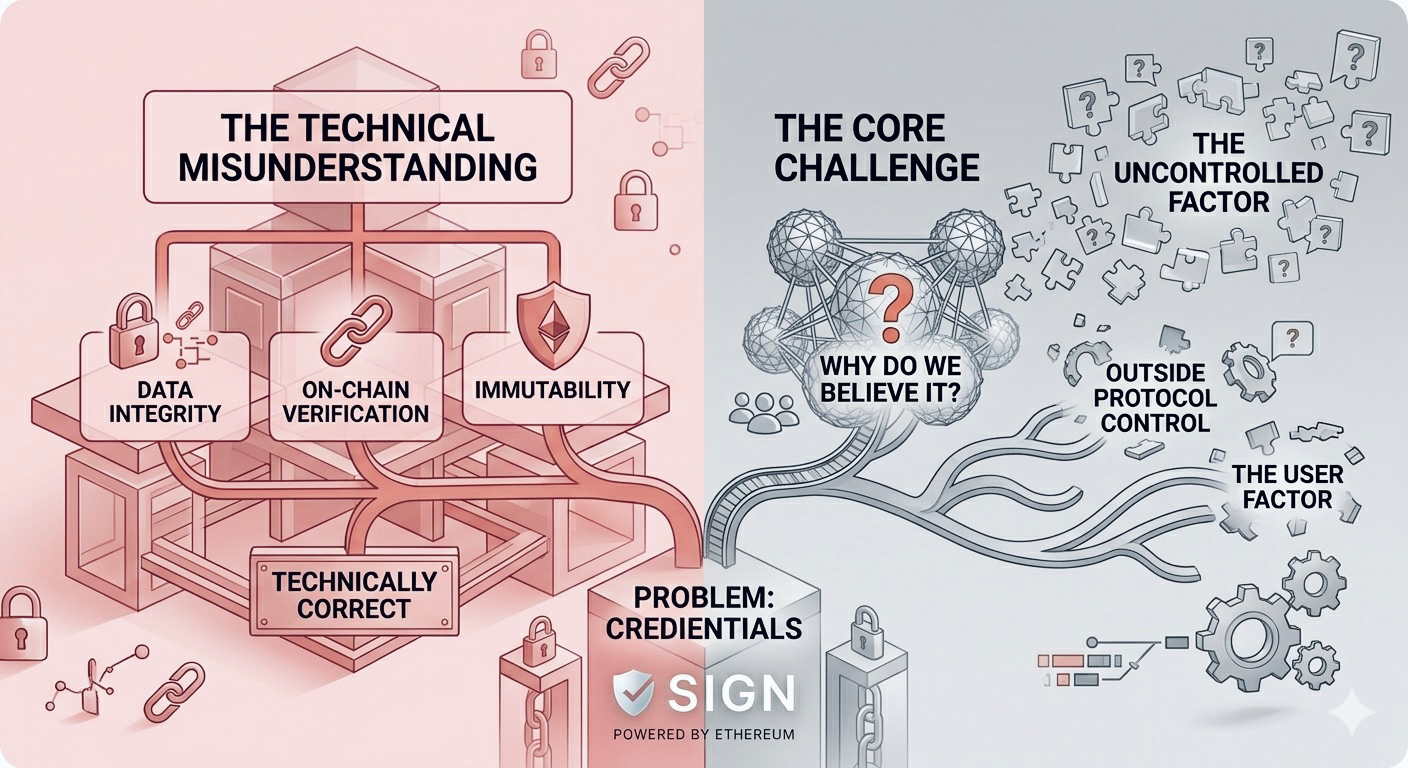
私は以前、問題はデータにあると思っていました:情報が正しいことをどう証明するか、オンチェーンでそれをどう検証するか、すべてを透明にし、修正不可能にするにはどうするか。
しかし、それは最大の誤解かもしれません。
なぜなら、データが完全に正確であっても、もっと重要な質問が残ります:なぜ私たちはそれを信じるのか?
SIGNのようなシステムは、クレデンシャルを非常に良く構造化できます。スキーマは明確で、検証ロジックは厳密で、データは不変です。
技術的には、すべてが正しいです。
問題は、プロトコルが制御できない部分にあります。
そのクレデンシャルの発行者は誰ですか?彼らは以前に何をしていましたか?他にどれだけのシステムが彼らを受け入れていますか?そして、もっと重要なことに、実際にどれだけの人が彼らを信頼していますか?権威はプロトコルにはありません。それは、ネットワークがあなたを認識するかどうかにあります - そしてそれは標準化できないものです。
各クレデンシャルが特定の発行者に関連付けられると、同じデータはもはや同等ではなくなります。それらは、発行者の履歴、行動、および使用頻度に基づいて分岐し始めます。同じ主張ですが、信頼の度合いは異なります。これは、以前は隠されていたレイヤーを明らかにします:データの背後にいる権威です。
SIGNはデータを検証するだけでなく、このレイヤーを可視化します。
そして、多くのシステムが同じ発行者を使用すると、権威が蓄積され始めます - 宣言を通じてではなく、繰り返し使用されることによって。クレデンシャルが受け入れられるたびに、その発行者の地位が強化されます。
徐々に、彼らはトラストアンカーとなります。彼らがそう言うからではなく、システムがそれを正しいと見なすからです。
データの正確性にのみ焦点を当てたモデルと比較して、これは全く異なるシフトです:"データは正しいか"から"このデータの背後に誰がいるのか"へ。
しかし、ここでも技術的な解決策のない問題が現れます。
あなたはオンチェーン全体の履歴を見ることができ、発行者を比較でき、時間に沿った行動を観察できる - しかし、信頼するかどうかの決定は依然として社会的な行動です。プロトコルはあなたに信頼を強制することはできません、ただすべてをより透明にすることしかできません。
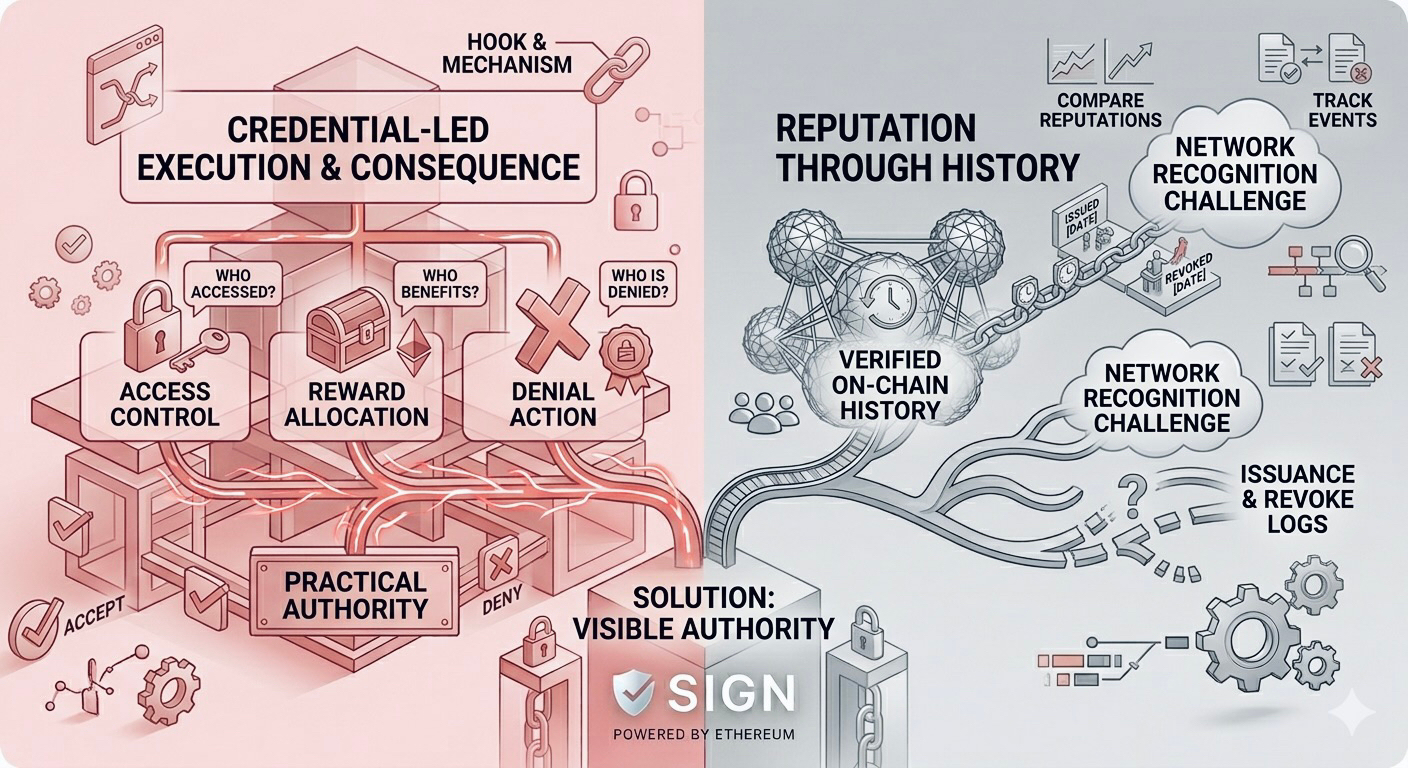
クレデンシャルがフックなどのメカニズムを通じて実行と接続されると、検証はもはや受動的な情報ではなく、結果を伴うようになります。誰がシステムにアクセスできるか、誰が利益を受けるか、誰が拒否されるかは、クレデンシャルが受け入れられるかどうかに依存します。この時、権威は象徴的なものではなく、システム内の実際の行動となります。
クレデンシャルの全ライフサイクルは、発行から取り消しまで、オンチェーンで記録されています。
レピュテーションはもはや言葉ではなく、履歴です:検証可能で、追跡可能で、比較可能です。
しかし、それは問題が解決されたことを意味するわけではありません。なぜなら、SIGNが行うすべてのことは権威を明らかにすることであり、その権威を認識するかどうかはネットワークに依存します。
同じ発行者を使用するシステムが十分でない場合、信頼レイヤーは形成されません。ネットワーク効果がなければ、権威は蓄積されません。そして、権威が蓄積されなければ、検証は各アプリケーション内の孤立した機能に過ぎません。
それが、SIGNのデータ検証の方法ではなく、彼らが検証を独立したレイヤーに変えることができるかどうかを追跡している理由です - 権威が存在するだけでなく、広く認識されるレイヤー。
もし信頼がプロトコルにないのなら、それは実際にどこで形成されるのですか?
\u003cm-7/\u003e \u003cc-9/\u003e \u003ct-11/\u003e