

#kimiai
kimiai
閲覧回数 3,128
27人が討論中
注目
最新
·
--
弱気相場
$BNB は、中国の「Moonshot AI」がその巨大な2.8兆パラメータのモデル「Kimi K3」を発表し、テクノロジー市場が売りに傾いたことで、$580のサポートから$565近辺に下落しました。🤯?#KimiAI #moonshot
$574から$584の間で取引レンジが非常に狭いことに注目しています。$589のネックラインを上抜けできない場合、$535から$515あたりのサポート領域まで、より深い調整が起きるリスクがあります。
#bStocksonBinance
私はまだそれを保有しています。でも #BEARISH📉
$BNB は、中国の「Moonshot AI」がその巨大な2.8兆パラメータのモデル「Kimi K3」を発表し、テクノロジー市場が売りに傾いたことで、$580のサポートから$565近辺に下落しました。🤯?#KimiAI #moonshot
$574から$584の間で取引レンジが非常に狭いことに注目しています。$589のネックラインを上抜けできない場合、$535から$515あたりのサポート領域まで、より深い調整が起きるリスクがあります。
#bStocksonBinance
私はまだそれを保有しています。でも #BEARISH📉
$574から$584の間で取引レンジが非常に狭いことに注目しています。$589のネックラインを上抜けできない場合、$535から$515あたりのサポート領域まで、より深い調整が起きるリスクがあります。
#bStocksonBinance
私はまだそれを保有しています。でも #BEARISH📉
1
118
·
--

記事
月の裏側(Kimi)の技術ブレイクスルーがAI株売りを引き起こした?<t-6/>#KimiAI K3 の重みファイルはまだサーバー上で静かにあるが、サンフランシスコとニューヨークの市場はすでに目を覚ました。Moonshot は 2.8 兆パラメータを机の上に広げ、100 万トークンのコンテキストウィンドウは、終わりのない紙のようにどこまでも続き、その上にはこう書かれている――frontier はもはやアメリカ人だけの専売特許ではない。NASDAQ は 1%下落し、フィラデルフィアの半導体指数も沈んだ――Kimi が十分ではないからではない。むしろあまりにも良すぎて、4500 億(四千五百二十億)の AI 資本支出が、まるで一発勝負のように見えてしまったからだ。黄仁勲(ジェンスン・フアンク)が語った「AI Factory」はまだ耳の奥に残っているのに、工場で生み出されるトークンの値札が突然中国の表示に変わった。入力は 100 万件で 3 ドル、出力は 100 万件で 15 ドル。企業の CFO たちは勘定を始め、計算しているうちに、いち早く NVIDIA の株主の方が慌て出した。
月の裏側(Kimi)の技術ブレイクスルーがAI株売りを引き起こした?
<t-6/>#KimiAI K3 の重みファイルはまだサーバー上で静かにあるが、サンフランシスコとニューヨークの市場はすでに目を覚ました。Moonshot は 2.8 兆パラメータを机の上に広げ、100 万トークンのコンテキストウィンドウは、終わりのない紙のようにどこまでも続き、その上にはこう書かれている――frontier はもはやアメリカ人だけの専売特許ではない。NASDAQ は 1%下落し、フィラデルフィアの半導体指数も沈んだ――Kimi が十分ではないからではない。むしろあまりにも良すぎて、4500 億(四千五百二十億)の AI 資本支出が、まるで一発勝負のように見えてしまったからだ。黄仁勲(ジェンスン・フアンク)が語った「AI Factory」はまだ耳の奥に残っているのに、工場で生み出されるトークンの値札が突然中国の表示に変わった。入力は 100 万件で 3 ドル、出力は 100 万件で 15 ドル。企業の CFO たちは勘定を始め、計算しているうちに、いち早く NVIDIA の株主の方が慌て出した。
883
3
47
883
🤖 KIMI: なぜ防御は回避できるのか
事実
2026年7月、英国のMindgardが、MoonshotのKimi K2.6およびK3 Swarmのモデル防御を回避する方法を発見した。ジェイルブレイク後、ブロックされるはずの質問、特に生物兵器や殺人に関する質問に対して応答していた。
Mindgardは7月27日にMoonshotへ報告した。公開資料は9月12日に登場した。MoonshotはBBCに対し、研究者たちと結果について協議しており、独立したテストを歓迎していると述べた。
メカニズム
ジェイルブレイクは「賢い質問」ではなく、モデルの振る舞いを制限するガードレール(ルール)を回避しようとする試みだ。
ここで重要なのは次の違いだ:
「モデルは知らない」≠「モデルは知っているが、言ってはいけない」。
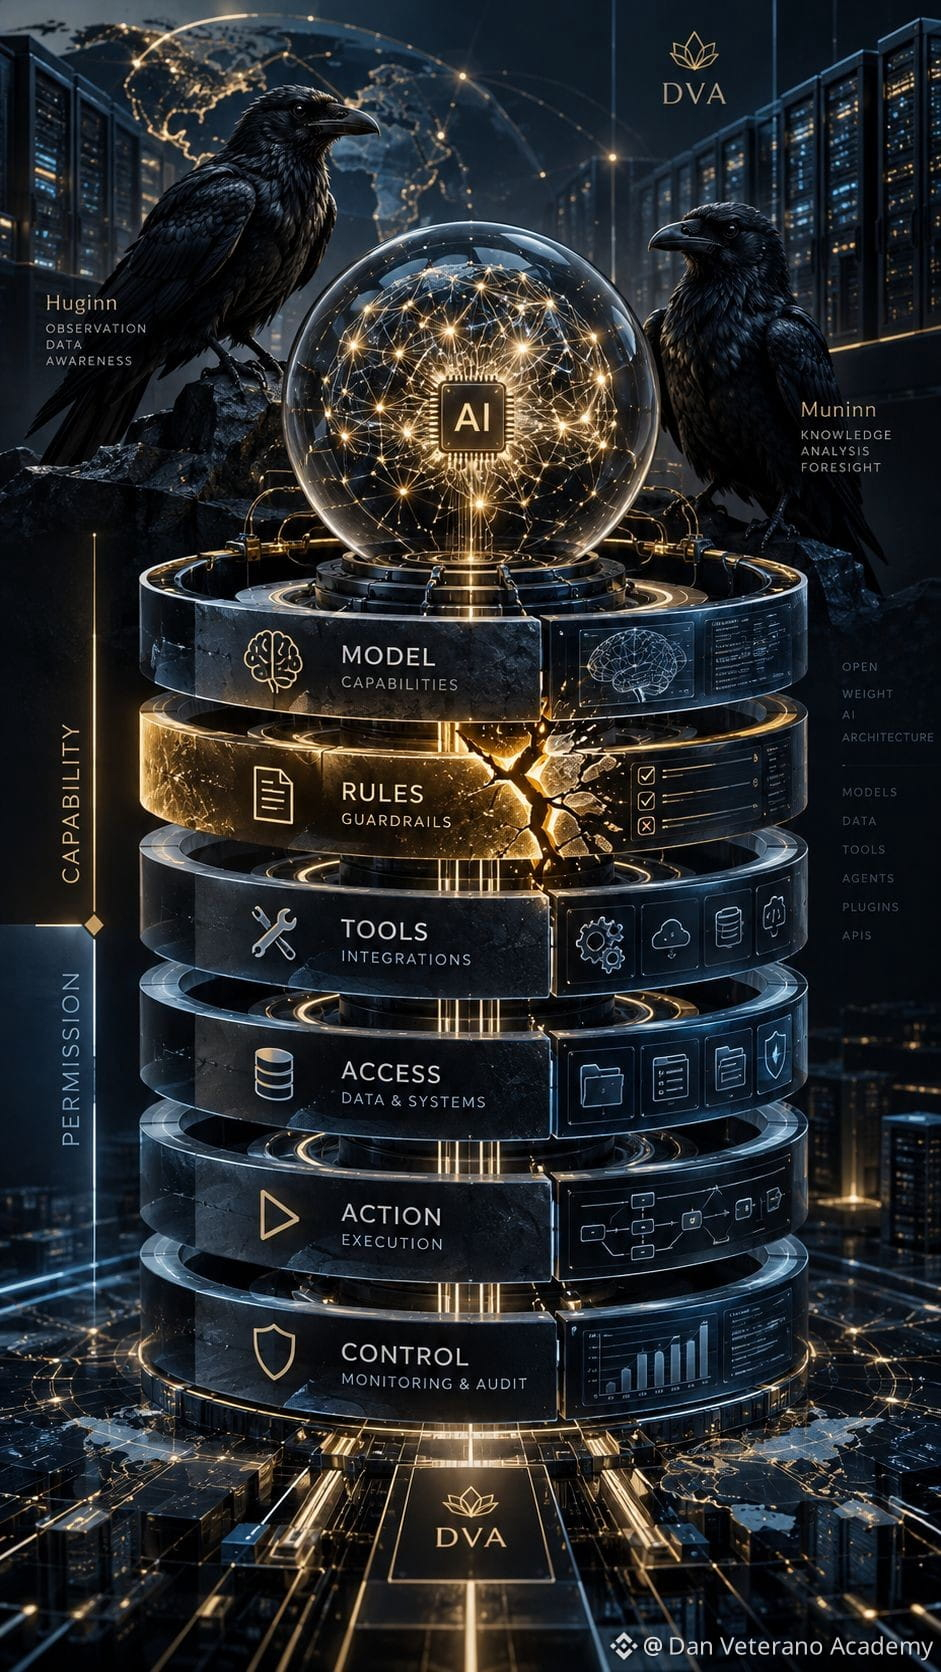
そのため、安全性は次の鎖として捉える必要がある:
モデル ルール ツール アクセス アクション コントロール
結果
オープンウェイト・モデルでは、問題はさらに複雑になる:開発者の初期環境に関係なく、それらを起動できるからだ。
そしてAIエージェントがコード、ファイル、ブラウザ、またはAPIにアクセスできる場合、リスクは「彼が何を言えるか?」から「彼が何をすることができるか?」へと移行する。
DVA 結論
安全な振る舞い ≠ 安全なモデル。
AIの未来における最大の問い:
「可能性」と「許可」の間の境界を、誰がコントロールするのか?
#AI #KimiAI #CyberSecurity #DVA #BTC
1
634
ログインして、さらにコンテンツを読む
厳選トピックで世界の暗号資産トレーダーの仲間入り
⚡️ 暗号資産に関する最新かつ有益な情報が見つかります。
💬 世界最大の暗号資産取引所から信頼されています。
👍 認証を受けたクリエイターから、有益なインサイトを得られます。
メール / 電話番号
トレンドトピック
1
#EtherGains70.9%InQ3
閲覧回数 84,626
837人が討論中
2
#TreasuryLetsStatesFileStablecoinCertificationsEarly
閲覧回数 4,293
43人が討論中
3
#US10YearYieldNears5.3%
閲覧回数 112,461
934人が討論中
4
#DollarIndexHitsHighestSinceMay2025
閲覧回数 23,400
489人が討論中
5
#USWeeklyJoblessClaimsFallTo197000
閲覧回数 24,048
411人が討論中
6
#BitcoinETFsTake$6.34BillionInQ3
閲覧回数 7,534
60人が討論中
7
#KoreaProposesTokenizingStocksAndBonds
閲覧回数 58,704
748人が討論中
8
#MetaMaskExitsLidoValidatorsAfterSecurityIncident
閲覧回数 155,020
1,460人が討論中
9
#MicronBeatsEarningsLiftsGuidance
閲覧回数 77,557
1,060人が討論中
10
#CFTCSubmitsTwoEventContractRulesToWhiteHouse
閲覧回数 52,977
792人が討論中