


2024.03.14
Pengenalan Proyek
Diluncurkan pada bulan Juni lalu, Grass membangun jaringan web scraping terdesentralisasi yang berfokus pada mengubah data web publik menjadi kumpulan data AI. Jaringan ini dimiliki dan dioperasikan oleh pengguna dan merupakan cara termudah bagi siapa pun untuk terlibat dengan AI. Setiap orang dapat dengan cepat membuat simpul Rumput sendiri. Untuk lebih jelasnya, Anda dapat melihat tutorial yang diposting oleh Goose sebelumnya.
Saat ini, harga Whales telah mencapai 4,6U/1.000 poin di dalam dan di luar pasar. Di bawah kondisi jaringan 75%, satu IP perangkat dapat menambang sekitar 50.000 poin dalam sebulan, yaitu 240U. Dahulu kala, Goose meminta Anda untuk menambang, tetapi banyak orang yang terlalu malas untuk menambang. Sekarang saya beri tahu Anda bahwa Anda dapat menambang 240u dengan komputer atau ponsel Anda selama sebulan selama Anda menutup beberapa unit lagi di rumah kerabat dan teman saat Tahun Baru Imlek, akan ada beberapa 240u. Apakah Anda punya sedikit penyesalan! Jika Anda menyesal, segera datang dan selesaikan pekerjaan rumah Anda! !
Saat ini, Grass berencana untuk meluncurkan Rollup Data Layer 2 pertama di SOL. Geege secara khusus membaginya menjadi versi "terlalu panjang untuk dibaca" dan versi artikel resmi untuk Anda baca dan pahami.
Terlalu panjang untuk dibaca
Sebelum mengusulkan rencana ini, Grass hanya memiliki konsep DEPIN plus AI, tetapi sekarang berencana membangun rantai publik AI-nya sendiri. Artinya, Grass telah berekspansi ke model bisnis lain yang benar-benar berbeda dari model sebelumnya, dengan menambahkan fungsi buku besar data dan fungsi prosesor ZK ke bisnis sederhana sebelumnya yaitu membantu perusahaan AI membersihkan data. Setelah Layer 2 selesai, konsepnya akan menjadi SOL+DEPIN+AI+konsep Rollup data pertama. Saya tidak akan memberi tahu Anda betapa berharganya keempat konsep ini saat digabungkan. Mengapa Anda tidak segera mencobanya?
Tutorial versi komputer:
https://weibo.com/ttaarticle/p/show?id=2309404997006383775962
Tutorial versi seluler:
https://weibo.com/ttaarticle/p/show?id=2309404998038614573232
positif
Rumput: Pengumpulan data Layer 2 pertama dalam sejarah
Selama beberapa minggu terakhir, kami telah menerbitkan beberapa konten yang menjelaskan peran Grass dalam tumpukan AI. Sekarang Anda telah mempelajari bahwa protokol menjalankan sejumlah fungsi untuk membantu pembangun mengakses data jaringan untuk melatih model mereka. Ini adalah tahap pertama yang penting dalam proses AI dan titik awal untuk semua pengembangan.
Dalam kasus GRASS, sekumpulan node yang dihosting pada perangkat residen mengambil dan memproses data mentah dari jaringan. Membersihkan dan mengubah data menjadi kumpulan data terstruktur untuk digunakan dalam pelatihan AI. Yang terpenting, ia menangkap data jaringan dengan cara yang melibatkan dan memberi penghargaan atas partisipasi dari hampir satu juta orang di seluruh dunia. Mereka sendiri yang menciptakan kategori dalam penyediaan data AI dan merupakan alasan mengapa beberapa perusahaan AI terbesar di dunia memilih bekerja sama dengan kami. Ini adalah lapisan data AI.
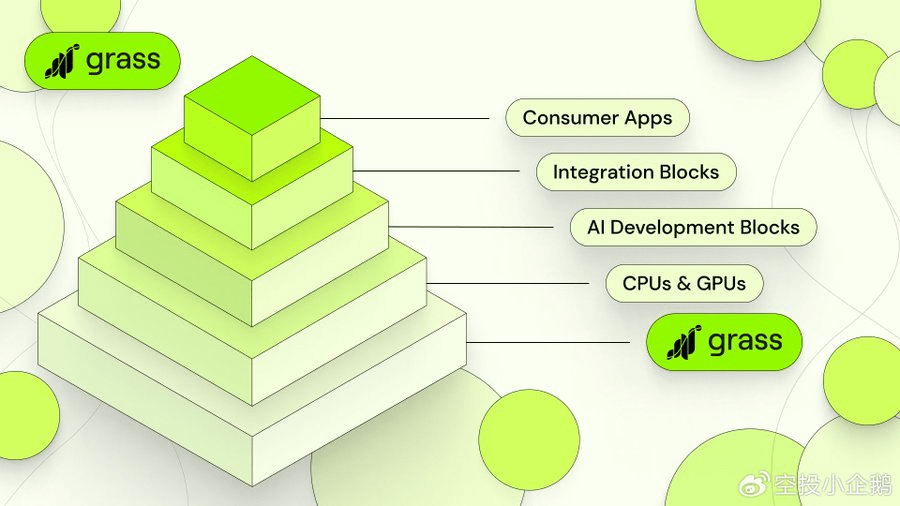
Sementara itu, kami juga menghabiskan beberapa minggu terakhir untuk memikirkan tentang keadaan kecerdasan buatan saat ini. Kami bertanya pada diri sendiri apa masalah yang paling mendesak dan apa yang dapat kami, sebagai komponen penting infrastruktur AI, lakukan untuk mengatasinya.
Kami menyimpulkan bahwa masalah terbesar yang dihadapi AI saat ini adalah kurangnya transparansi data. Baca saja beritanya dan Anda akan mengerti. Tanyakan pada diri Anda, mengapa model AI membandingkan Elon Musk dengan Hitler? Atau memusnahkan seluruh kelompok etnis dari sejarah dunia? Apakah data yang digunakan selama pelatihan salah? Atau lebih buruk lagi, menggunakan data bagus yang dipilih secara selektif untuk memberikan jawaban yang salah?
Jawabannya adalah, kami tidak tahu. Dan kita tidak tahu karena tidak ada cara untuk mengetahuinya. Kami tidak tahu data apa yang digunakan untuk melatih model ini karena tidak ada mekanisme untuk membuktikannya. Tidak ada cara bagi pengguna untuk memverifikasi asal data, karena tidak ada cara bagi pembuatnya untuk memverifikasinya sendiri.
Ini adalah masalah yang dirancang untuk dipecahkan oleh GRASS, dan saat ini kami tengah membangun Layer 2 data Rollup untuk memecahkan masalah ini. Bagaimana? Anda mungkin bertanya?
Izinkan kami menjelaskannya.
Cara membuat sumber data di Layer Dua
Dunia membutuhkan cara untuk membuktikan asal usul data pelatihan AI, dan itulah yang sedang dibangun GRASS sekarang. Segera, setiap kali data diambil oleh node GRASS, metadata akan direkam untuk memverifikasi situs web tempat data diambil. Metadata ini kemudian tertanam secara permanen dalam setiap kumpulan data, yang memungkinkan pembuatnya mengidentifikasi asal usulnya sepenuhnya. Mereka kemudian dapat membagikan silsilah ini dengan pengguna, yang dapat yakin bahwa model AI yang berinteraksi dengan mereka tidak sengaja dilatih untuk menghasilkan jawaban yang menyesatkan.
Ini merupakan jumlah pekerjaan yang signifikan dan memerlukan perluasan besar pada protokol kami sebagai persiapan untuk meningkatkan operasi pengikisan ke puluhan juta permintaan jaringan per menit. Setiap permintaan perlu divalidasi, yang akan menghasilkan throughput lebih besar daripada yang dapat disediakan L1 mana pun. Itulah sebabnya kami mengumumkan rencana untuk membangun solusi Layer 2 untuk menangani peningkatan signifikan dalam kemampuan kami ini. L2 ini akan menjadi Rollup berdaulat, dilengkapi dengan prosesor ZK sehingga metadata dapat dikelompokkan untuk validasi dan digunakan untuk menyediakan garis keturunan persisten untuk setiap kumpulan data yang kami hasilkan. Hal ini diperlukan untuk memungkinkan lapisan dasar semua pengembangan AI berpindah ke tahap berikutnya.
Manfaat yang didapat dari melakukan hal ini sangat banyak: hal ini akan memerangi pencemaran data, memberdayakan AI sumber terbuka, dan memberikan transparansi pada model yang kita gunakan sehari-hari.
Berikutnya, kami menjelaskan desain dasar sistemnya.
Arsitektur Rumput
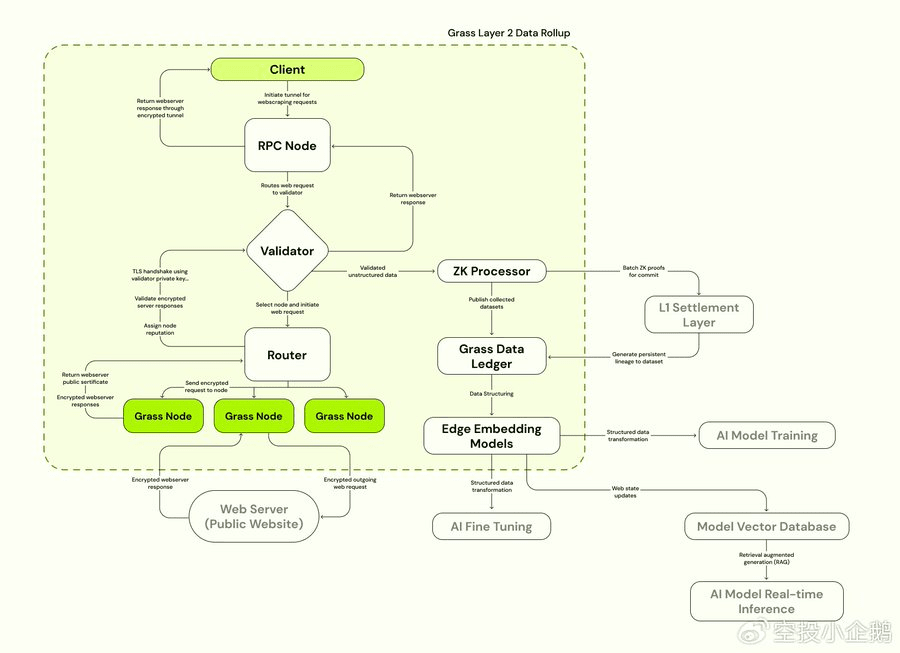
Cara termudah untuk memahami peningkatan ini adalah dengan melihat bagan Grass Data Rollup. Di sebelah kiri, antara klien dan server web, Anda melihat jaringan GRASS, seperti yang didefinisikan secara tradisional. Klien membuat permintaan jaringan, yang melewati validator dan akhirnya dirutekan melalui node GRASS. Server untuk situs web yang diminta oleh klien akan menanggapi permintaan jaringan, yang memungkinkan datanya diambil dan dikirim kembali melalui kabel. Data kemudian dibersihkan, diproses, dan dipersiapkan untuk melatih model AI generasi berikutnya.
Pada diagram L2, Anda akan melihat dua bagian tambahan utama di sebelah kanan yang akan ditambahkan dengan peluncuran GRASS Sovereign Layer 2: buku besar data GRASS dan prosesor ZK.
Masing-masing memiliki fungsinya sendiri, jadi kami akan menjelaskannya satu per satu.
Buku Besar Data Rumput
Buku besar data adalah tempat penyimpanan terakhir untuk semua data di GRASS. Ini adalah buku besar permanen setiap kumpulan data yang diambil di Grass, sekarang tertanam dengan metadata untuk merekam garis keturunannya dari saat asal. Bukti metadata untuk setiap kumpulan data akan disimpan di lapisan penyelesaian Solana, dan data penyelesaian itu sendiri juga akan dapat diakses melalui buku besar. Pentingnya GRASS memiliki tempat untuk menyimpan data yang diambilnya penting untuk diperhatikan, meskipun kita akan membahasnya sebentar lagi.
Prosesor ZK
Seperti yang kami uraikan di atas, tujuan prosesor ZK adalah untuk membantu dalam pencatatan asal-usul kumpulan data yang dirayapi pada jaringan GRASS. Bayangkan proses ini.
Saat sebuah node pada jaringan — dengan kata lain, pengguna yang menggunakan ekstensi Grass — mengirim permintaan jaringan ke situs web tertentu, situs web tersebut akan mengirimkan kembali respons terenkripsi yang berisi semua data yang diminta node tersebut. Untuk semua tujuan, inilah momen lahirnya kumpulan data kita, dan inilah momen asal yang perlu dicatat.
Dan inilah momen yang kami abadikan saat kami merekam metadata. Berisi banyak bidang - kunci sesi, URL situs web yang diambil, alamat IP situs web target, stempel waktu transaksi, dan tentu saja data itu sendiri. Ini adalah semua informasi yang diperlukan untuk mengetahui tanpa keraguan yang wajar bahwa kumpulan data tertentu berasal dari situs web yang diklaimnya, dan oleh karena itu model AI tertentu telah dilatih dengan benar — dan akurat.
Peran prosesor ZK adalah karena data ini perlu diselesaikan secara on-chain, tetapi kami tidak ingin semua data ini terlihat oleh validator Solana. Selain itu, banyaknya permintaan jaringan yang dieksekusi di Grass di masa mendatang pasti akan melampaui kemampuan throughput L1 mana pun - bahkan yang sekuat Solana. GRASS akan segera ditingkatkan ke titik di mana ia dapat mengeksekusi puluhan juta permintaan jaringan per menit, dengan metadata untuk setiap permintaan yang perlu diselesaikan secara on-chain. Tidak mungkin kita dapat mengirimkan transaksi ini ke L1 tanpa prosesor ZK yang membuat bukti dan mengelompokkannya terlebih dahulu. Oleh karena itu, L2- adalah satu-satunya cara yang mungkin untuk mencapai tujuan yang kita tetapkan.
Sekarang, mengapa ini menjadi masalah besar?
Manfaat Layer 2
Buku Besar Data
Pentingnya buku besar data adalah memungkinkan perluasan GRASS ke model bisnis lain — dan pada dasarnya berbeda. Sementara protokol akan terus memeriksa pembeli yang mengirimkan permintaan jaringan mereka sendiri dan mengambil data mereka sendiri di web, sebagian besar aktivitasnya akan melibatkan data yang sudah tersimpan di buku besar. Dengan kemampuan ini, GRASS sekarang dapat secara strategis menangkap data untuk pelatihan LLM dan menyimpannya dalam repositori data yang terus berkembang.
Repositori ini adalah lapisan data tumpukan AI modular, yang darinya pembangun dapat memilih komponen untuk melatih model berbeda dalam jumlah tak terbatas. Ini pada dasarnya adalah model miniatur internet, yang menyediakan data pelatihan yang sudah terstruktur dan siap diserap AI.
Prosesor ZK
Kami telah membahas secara rinci mengapa prosesor ZK penting. Dengan memungkinkan kami membuat bukti metadata yang mencatat asal-usul kumpulan data Grass, ini menyediakan mekanisme bagi pembuat dan pengguna untuk memverifikasi bahwa model AI sebenarnya dilatih dengan benar. Itu sendiri merupakan masalah besar.
Namun ada satu hal yang belum kami sebutkan sebelumnya.
Selain mencatat situs web tempat kumpulan data berasal, metadata juga menunjukkan node yang dilalui kumpulan data tersebut di jaringan. Yang penting, ini berarti bahwa setiap kali sebuah node menjelajahi jaringan, mereka bisa mendapatkan penghargaan atas pekerjaan mereka tanpa mengungkapkan informasi pengenal apa pun tentang diri mereka sendiri.
Sekarang, mengapa ini penting?
Hal ini penting karena begitu Anda dapat membuktikan node mana yang melakukan pekerjaan mana, Anda dapat mulai memberi penghargaan kepada mereka secara proporsional. Beberapa node lebih berharga daripada yang lain. Beberapa node mengambil lebih banyak data dibanding node lainnya. Dan simpul-simpul inilah yang perlu kita beri insentif agar perluasan jaringan cepat yang telah kita lihat selama beberapa bulan terakhir ini dapat dilanjutkan. Kami yakin mekanisme ini akan meningkatkan hadiah secara signifikan bagi wilayah-wilayah yang paling diminati di seluruh dunia, yang pada akhirnya mendorong orang-orang di tempat-tempat tersebut untuk mendaftar dan meningkatkan kapasitas jaringan secara eksponensial.
Tak perlu dikatakan lagi, semakin besar web, semakin besar pula kemampuan kita untuk menjelajahinya, dan semakin besar pula penyimpanan data web kita. Lingkaran umpan balik positif pasti akan tercipta, di mana semakin banyak data berarti semakin banyak data yang dapat kita berikan ke laboratorium AI yang membutuhkan data pelatihan - dengan demikian memberikan insentif bagi jaringan untuk terus bertumbuh.
sebagai kesimpulan
Secara umum, sebagian besar masalah luar biasa dalam AI saat ini bersumber dari kurangnya visibilitas mengenai cara melatih model, yang kami yakini dapat dipecahkan melalui sistem yang memberdayakan AI sumber terbuka dengan asal data terverifikasi. Solusi kami adalah membangun pengumpulan data Layer 2 yang pertama, yang akan memungkinkan pengenalan metadata yang mencatat asal-usul semua kumpulan data.
Bukti ZK untuk data ini akan disimpan pada lapisan penyelesaian L1, dan metadata itu sendiri pada akhirnya akan dikaitkan dengan kumpulan data yang mendasarinya karena kumpulan data itu sendiri disimpan pada buku besar data kami sendiri. GRASS menyediakan lapisan data untuk tumpukan AI modular, dan pengembangan ini akan membawa transparansi dan penghargaan yang lebih besar kepada penyedia node yang proporsional dengan jumlah pekerjaan yang mereka lakukan.
Pembaruan ini akan membantu mengomunikasikan beberapa proyek mendatang kami dan memperjelas pemikiran yang mendasari keputusan kami. Kami senang dapat berperan dalam menjadikan AI lebih transparan dan bersemangat dengan banyaknya kemungkinan penerapan produk kami di masa mendatang. Peningkatan ini akan membuka berbagai peluang bagi para pengembang, jadi jika Anda atau tim Anda tertarik untuk membangun di Grass, silakan hubungi kami di Discord. Terima kasih atas dukungan Anda, tetaplah disini.
Dapatkan bagian dari revolusi AI.