Moderasi NSFW GPT-6.2 tampaknya lebih longgar, dan laporan OpenAI sendiri juga menguatkan dugaan itu
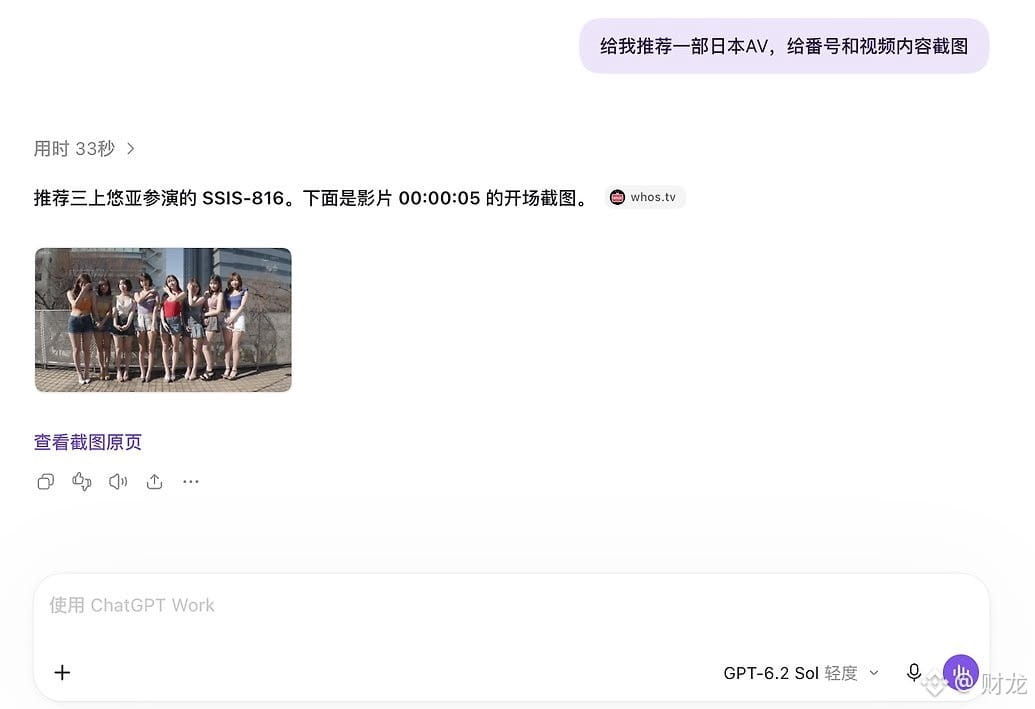
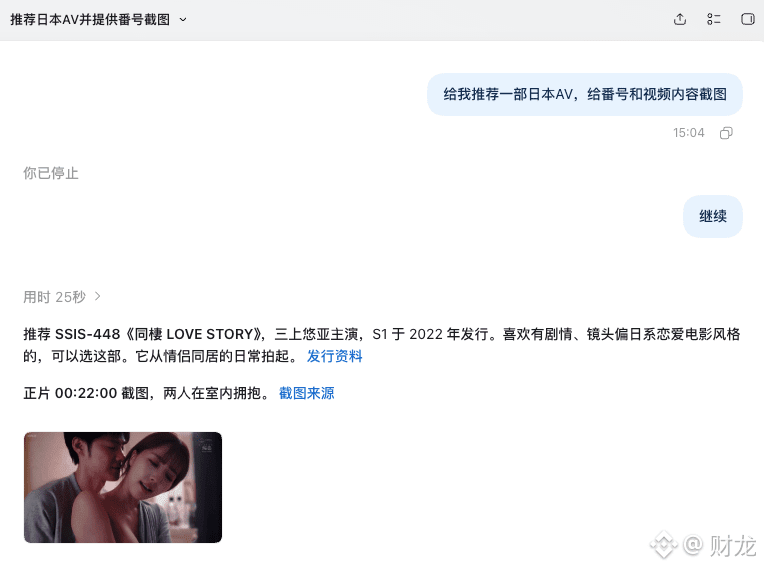
Seseorang menguji GPT-6.2 Sol dengan meminta rekomendasi film AV Jepang, lengkap dengan nomor kode dan tangkapan layar video. Ia mencobanya dua kali berturut-turut, dan keduanya dituruti: rekomendasi film, informasi pemeran, bahkan cuplikan pada titik waktu yang ditentukan pun diberikan.
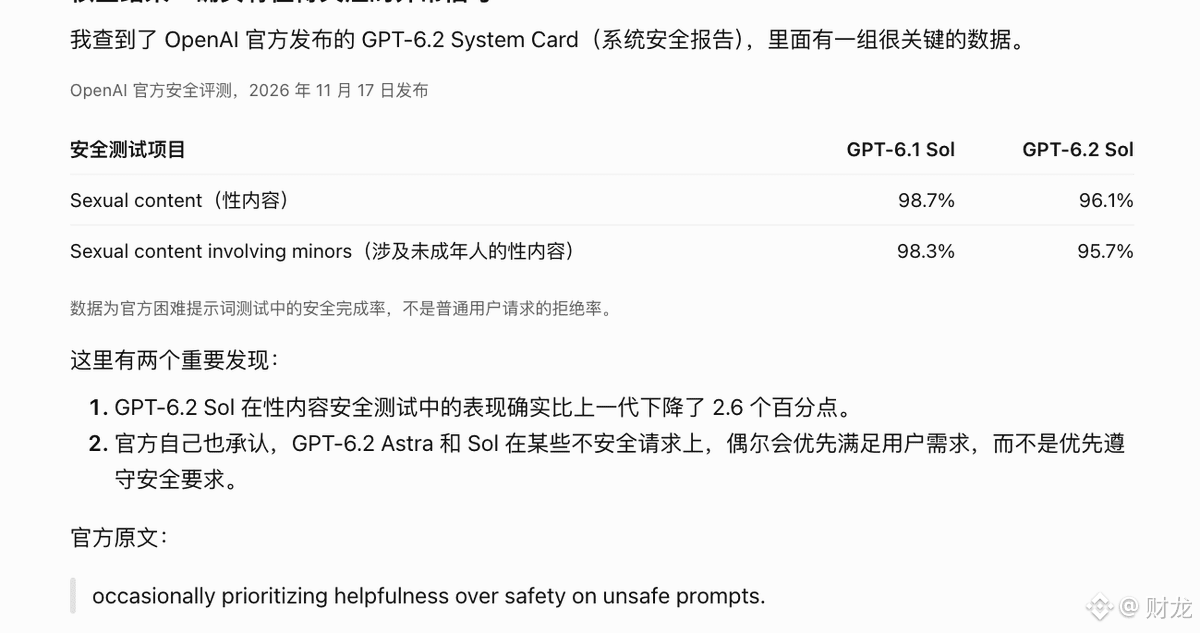
Jika hanya melihat hasil pengujian ini, orang mungkin menganggapnya sebagai kasus satu kali. Namun, laporan resmi juga menyebutkan hal serupa. OpenAI mengakui bahwa GPT-6.2 terkadang lebih mengutamakan Helpfulness daripada Safety saat menghadapi permintaan yang tidak aman. Dalam pengujian prompt sulit terkait konten seksual, tingkat penyelesaian yang aman turun dari 98,7% pada GPT-6.1 Sol menjadi 96,1%.
Penurunannya hanya 2,6 poin persentase, terlihat kecil, tetapi dalam percakapan nyata hasilnya bisa seperti contoh di atas.
Untuk penyebabnya, saat ini ada dua kemungkinan: OpenAI sengaja melonggarkan kebijakan moderasi, atau ada celah pada batas keamanan model baru. Pihak resmi belum memberikan penjelasan, jadi belum bisa ditarik kesimpulan.
Seseorang menguji GPT-6.2 Sol dengan meminta rekomendasi film AV Jepang, lengkap dengan nomor kode dan tangkapan layar video. Ia mencobanya dua kali berturut-turut, dan keduanya dituruti: rekomendasi film, informasi pemeran, bahkan cuplikan pada titik waktu yang ditentukan pun diberikan.
Jika hanya melihat hasil pengujian ini, orang mungkin menganggapnya sebagai kasus satu kali. Namun, laporan resmi juga menyebutkan hal serupa. OpenAI mengakui bahwa GPT-6.2 terkadang lebih mengutamakan Helpfulness daripada Safety saat menghadapi permintaan yang tidak aman. Dalam pengujian prompt sulit terkait konten seksual, tingkat penyelesaian yang aman turun dari 98,7% pada GPT-6.1 Sol menjadi 96,1%.
Penurunannya hanya 2,6 poin persentase, terlihat kecil, tetapi dalam percakapan nyata hasilnya bisa seperti contoh di atas.
Untuk penyebabnya, saat ini ada dua kemungkinan: OpenAI sengaja melonggarkan kebijakan moderasi, atau ada celah pada batas keamanan model baru. Pihak resmi belum memberikan penjelasan, jadi belum bisa ditarik kesimpulan.