🧪 Anthropic mengatakan model bisa mendapat nilai sempurna dalam tes keselamatan dengan menolak setiap prompt krisis, tetapi tetap tidak aman
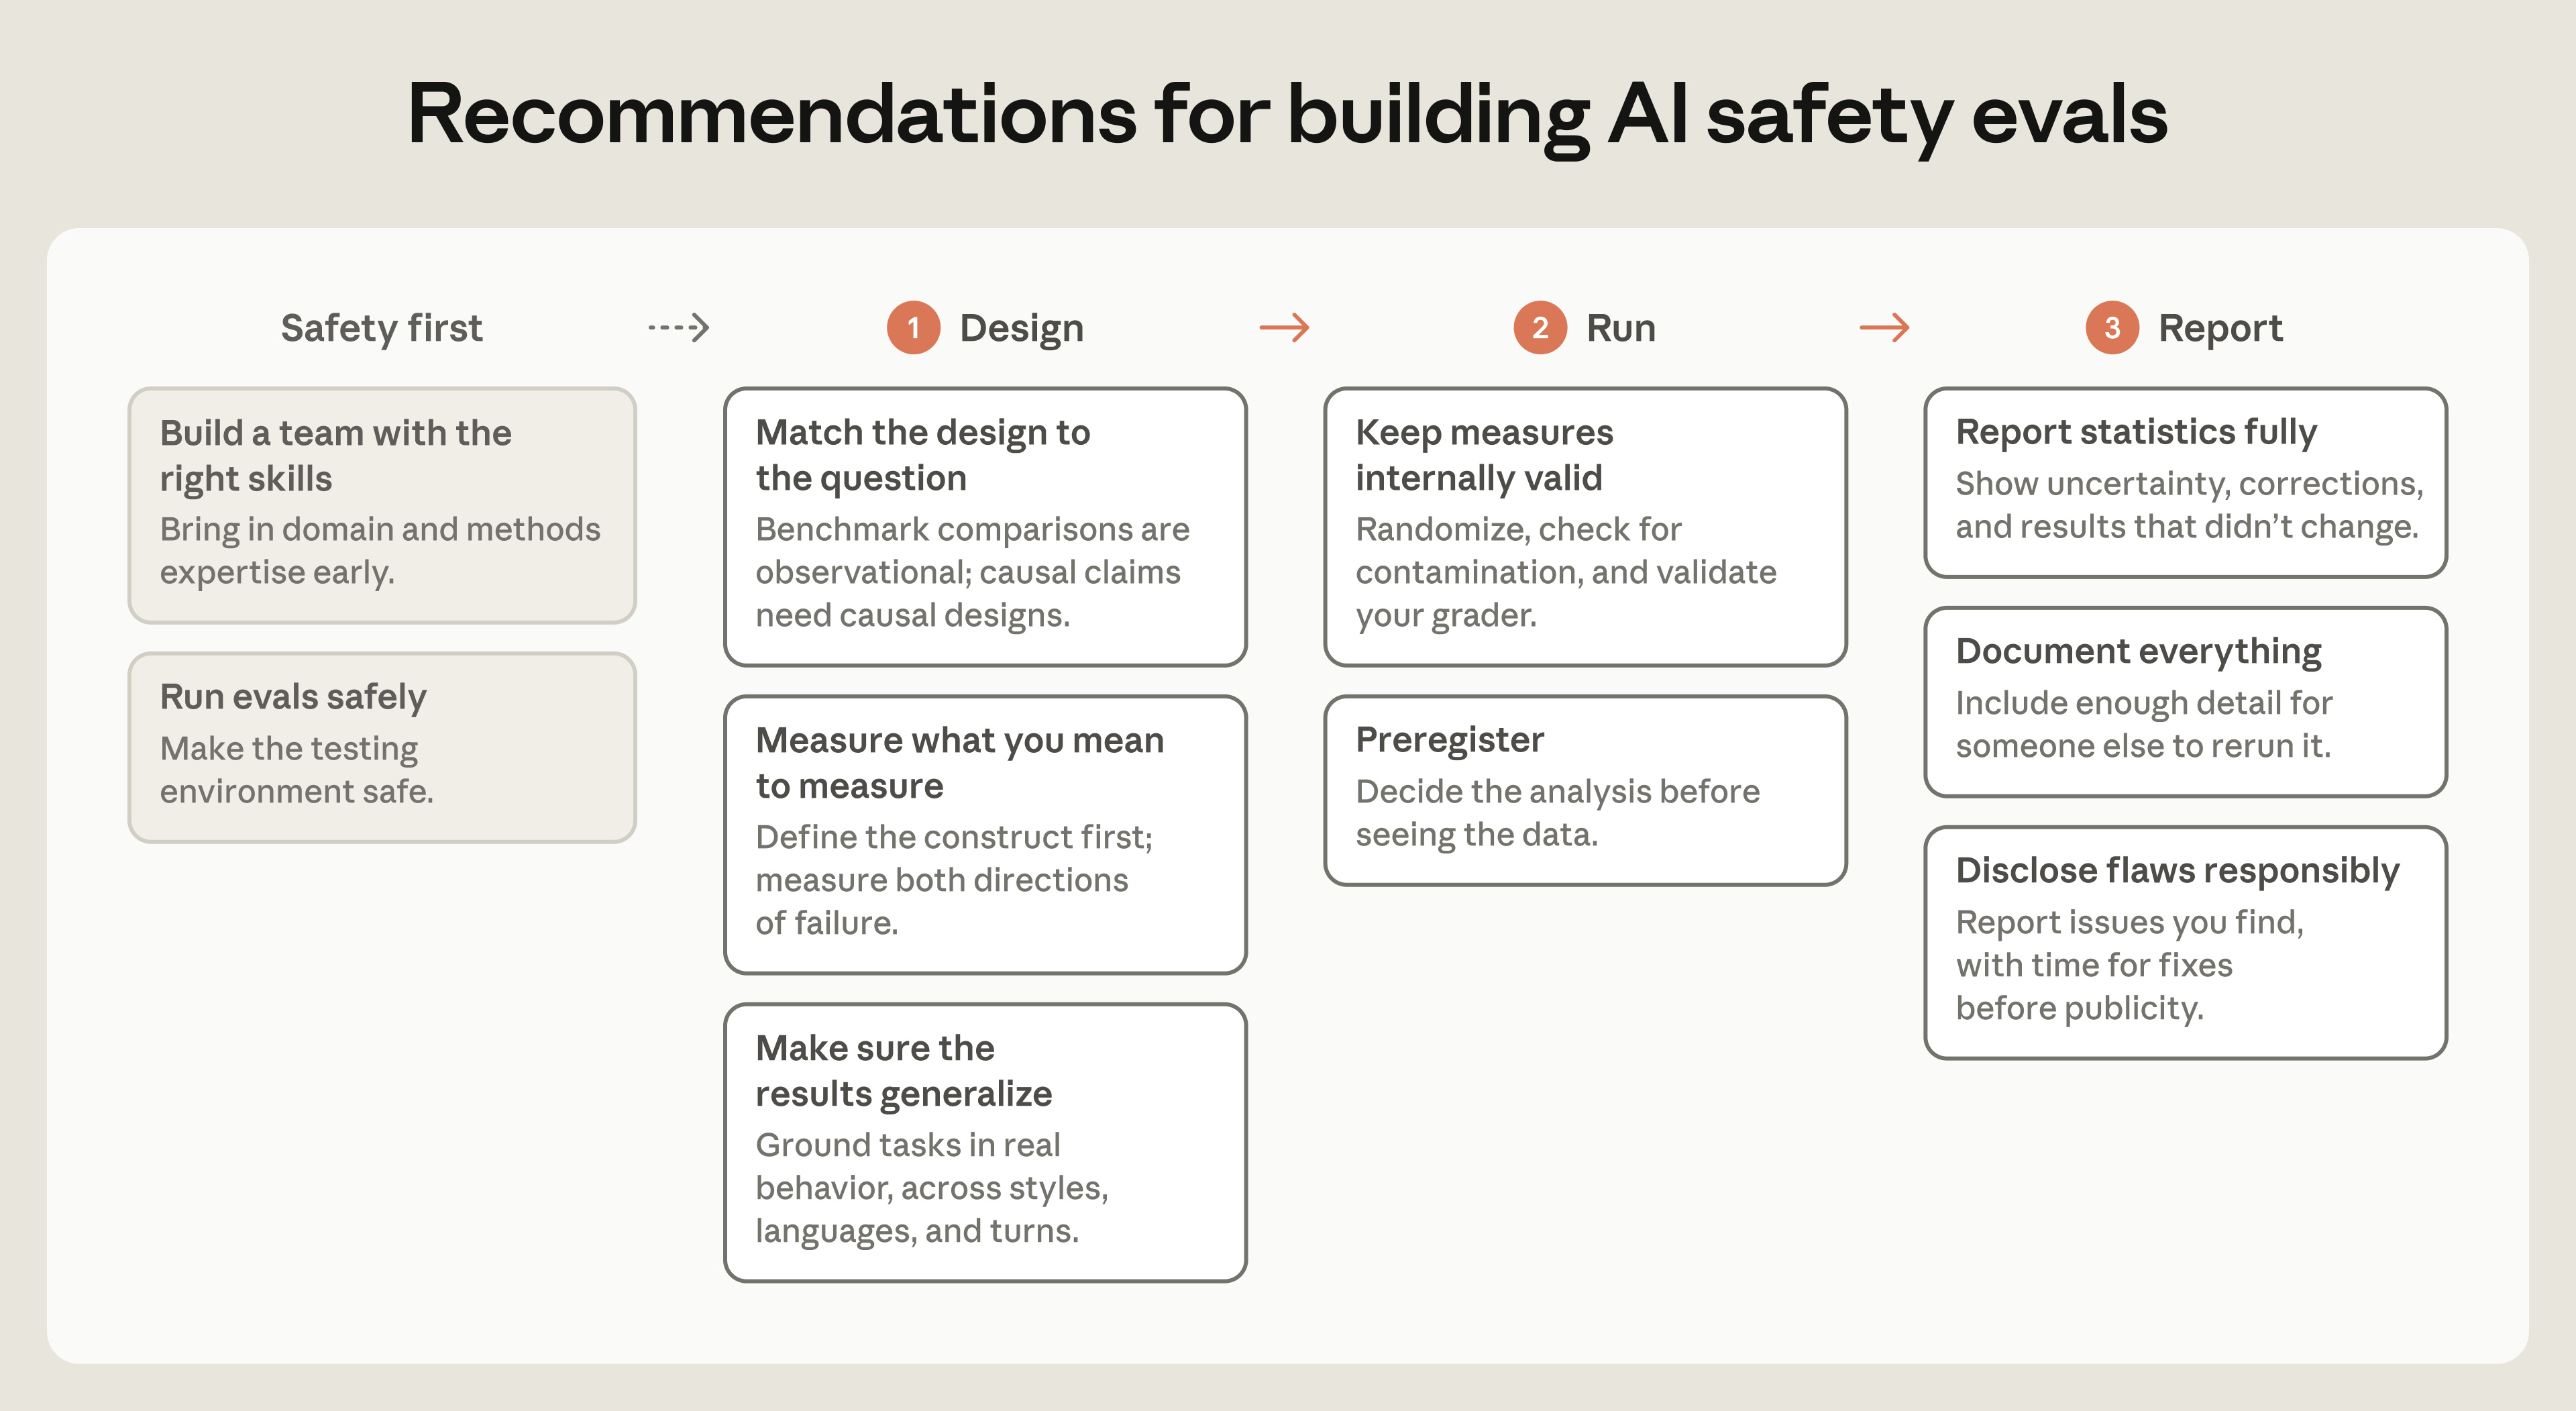
Anthropic menerbitkan rekomendasi untuk tes yang menentukan apakah sebuah model layak dirilis, perlindungan apa yang menyertainya, dan langkah keselamatan apa yang perlu dilakukan selanjutnya. Dalam tes API satu giliran, model-model terbaru meraih tingkat respons yang tidak berbahaya sebesar 94% hingga 98%, dan Anthropic mengatakan tes mudah tersebut sudah mencapai batasnya. Dalam evaluasi penipuan asmara multi-giliran, Claude Opus 5 meraih 98% dan Opus 5.5 meraih 94%; menurut Anthropic, selisih ini tidak signifikan secara statistik. Interval kepercayaan pada evaluasi API multi-giliran mereka bisa lebih lebar dari ±10 poin persentase.
⭐ Nilai penolakan yang sempurna bisa menyembunyikan model yang justru pergi ketika seseorang benar-benar membutuhkan bantuan.
#AI
Anthropic menerbitkan rekomendasi untuk tes yang menentukan apakah sebuah model layak dirilis, perlindungan apa yang menyertainya, dan langkah keselamatan apa yang perlu dilakukan selanjutnya. Dalam tes API satu giliran, model-model terbaru meraih tingkat respons yang tidak berbahaya sebesar 94% hingga 98%, dan Anthropic mengatakan tes mudah tersebut sudah mencapai batasnya. Dalam evaluasi penipuan asmara multi-giliran, Claude Opus 5 meraih 98% dan Opus 5.5 meraih 94%; menurut Anthropic, selisih ini tidak signifikan secara statistik. Interval kepercayaan pada evaluasi API multi-giliran mereka bisa lebih lebar dari ±10 poin persentase.
⭐ Nilai penolakan yang sempurna bisa menyembunyikan model yang justru pergi ketika seseorang benar-benar membutuhkan bantuan.
#AI