
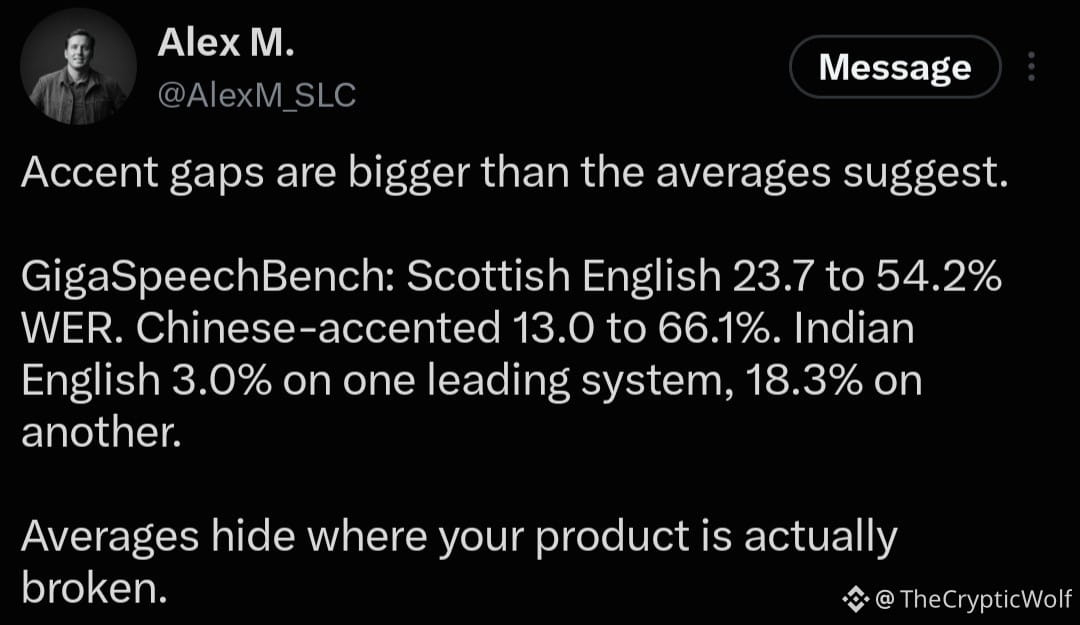
Inilah alasan mengapa apa yang sedang dibangun $SLC itu penting. Kita banyak membicarakan betapa canggihnya teknologi suara AI, tetapi ada masalah yang belum mendapat cukup perhatian: teknologi ini tidak memahami semua orang secara setara. Ketika bahasa Inggris Skotlandia menghasilkan rentang WER 23,7–54,2%, atau bahasa Inggris beraksen Tionghoa melonjak dari 13% menjadi 66,1%, itu bukan sekadar kesenjangan kinerja. Itu adalah masalah aksesibilitas. Bayangkan dampaknya bagi seseorang yang mencoba menggunakan AI suara di tempat kerja, mengakses layanan, berkomunikasi dengan perangkat, atau sekadar ingin dipahami. AI seharusnya tidak bekerja dengan sangat baik untuk satu suara, tetapi kesulitan memahami suara lainnya. Di sinilah @silencionetwork menjadi penting. Membangun AI suara yang lebih baik dimulai dengan data ucapan yang lebih baik. Aksen, dialek, bahasa yang beragam, serta suara-suara yang selama ini kurang terwakili dalam kumpulan data harus menjadi bagian dari fondasi, bukan sekadar tambahan belakangan. Silencio tengah membangun masa depan ketika teknologi suara dapat lebih mencerminkan keberagaman orang-orang yang benar-benar menggunakannya. Sebab, generasi AI suara berikutnya seharusnya tidak hanya mengenali lebih banyak kata. AI juga harus memahami lebih banyak orang. Masa depan AI suara membutuhkan suara semua orang, dan itulah alasan saya optimistis dengan apa yang sedang dibangun $SLC.
Bergabunglah dengan pengguna kripto global di Binance Square
⚡️ Dapatkan informasi terbaru dan berguna tentang kripto.
💬 Dipercayai oleh bursa kripto terbesar di dunia.
👍 Temukan wawasan nyata dari kreator terverifikasi.
Email/Nomor Ponsel