Peringkat evaluasi AI mengalami perombakan besar-besaran minggu ini, sampai-sampai agak sulit dipahami.
Pada 23 Oktober, Artificial Analysis masih memberi Kimi K3.1 Pro skor 55 dan menempatkannya di peringkat keempat dunia. Namun, begitu daftar V5 diperbarui pada 27 Oktober, skor Kimi langsung turun menjadi 46, sementara DeepSeek dan GLM hanya mendapat 32. Posisi teratas kini ditempati Gemini 4 Carbon dengan skor 59.
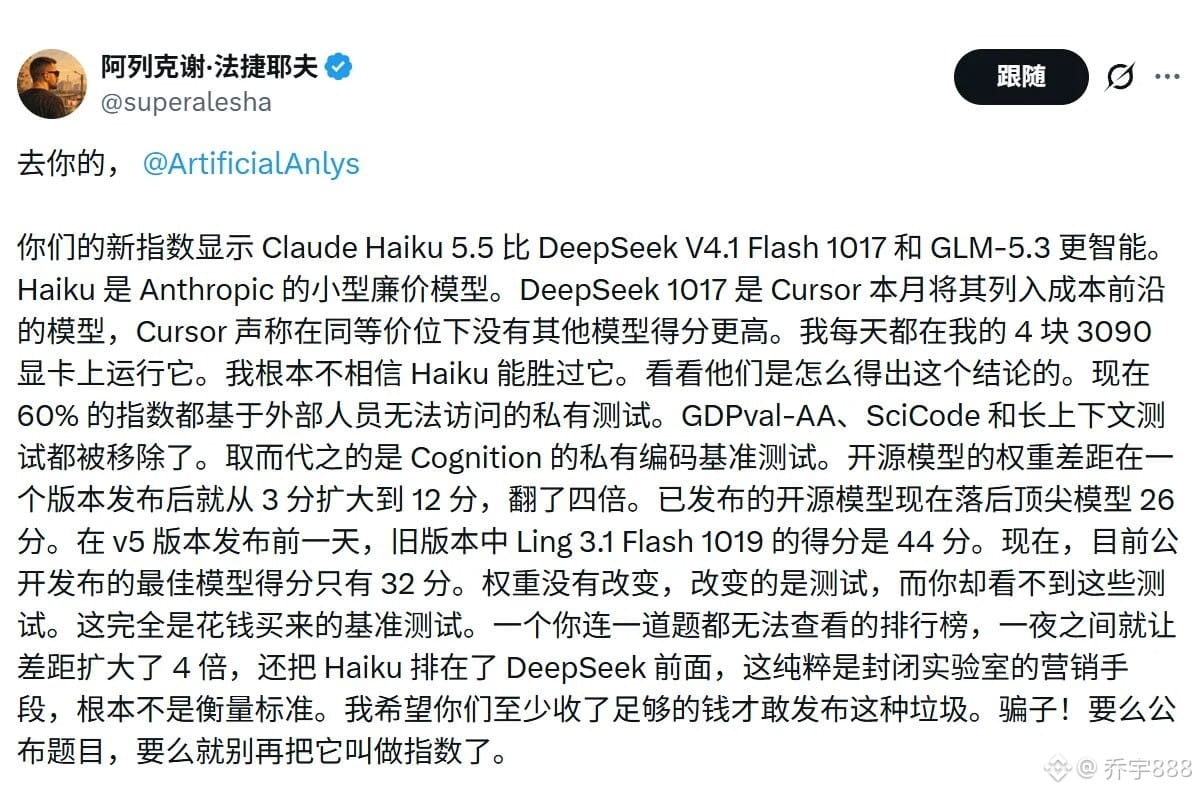
Perubahan utamanya ada pada algoritma: kali ini beberapa tolok ukur evaluasi diganti dan bobotnya dibagikan ulang. Sebanyak 60% bobot berasal dari kumpulan tes privat atau jawaban tersembunyi. Artinya, lebih dari separuh skor di daftar tersebut berasal dari tes yang tidak bisa dilihat pihak luar maupun diverifikasi secara independen.
Menurut saya, daftar peringkat seharusnya menjadi tolok ukur bagi pengembang untuk memilih model. Namun, jika skala pada tolok ukurnya sendiri diubah, hasil pengukurannya pun ikut berubah total. Penurunan skor Kimi dari 55 menjadi 46 dan DeepSeek menjadi 32 belum tentu berarti modelnya memburuk; lebih mungkin cara pengukuran dengan tolok ukur baru yang berubah. Saya cenderung berpendapat bahwa saat melihat daftar peringkat, kita perlu memperhatikan cara penghitungannya, bukan hanya urutannya—terutama ketika 60% skor berasal dari tes kotak hitam. Dalam kondisi seperti ini, nilai referensi daftar tersebut perlu dipertimbangkan dengan hati-hati.
#GarisDepanAI
$BTC
Pada 23 Oktober, Artificial Analysis masih memberi Kimi K3.1 Pro skor 55 dan menempatkannya di peringkat keempat dunia. Namun, begitu daftar V5 diperbarui pada 27 Oktober, skor Kimi langsung turun menjadi 46, sementara DeepSeek dan GLM hanya mendapat 32. Posisi teratas kini ditempati Gemini 4 Carbon dengan skor 59.
Perubahan utamanya ada pada algoritma: kali ini beberapa tolok ukur evaluasi diganti dan bobotnya dibagikan ulang. Sebanyak 60% bobot berasal dari kumpulan tes privat atau jawaban tersembunyi. Artinya, lebih dari separuh skor di daftar tersebut berasal dari tes yang tidak bisa dilihat pihak luar maupun diverifikasi secara independen.
Menurut saya, daftar peringkat seharusnya menjadi tolok ukur bagi pengembang untuk memilih model. Namun, jika skala pada tolok ukurnya sendiri diubah, hasil pengukurannya pun ikut berubah total. Penurunan skor Kimi dari 55 menjadi 46 dan DeepSeek menjadi 32 belum tentu berarti modelnya memburuk; lebih mungkin cara pengukuran dengan tolok ukur baru yang berubah. Saya cenderung berpendapat bahwa saat melihat daftar peringkat, kita perlu memperhatikan cara penghitungannya, bukan hanya urutannya—terutama ketika 60% skor berasal dari tes kotak hitam. Dalam kondisi seperti ini, nilai referensi daftar tersebut perlu dipertimbangkan dengan hati-hati.
#GarisDepanAI
$BTC