


Tiga peneliti keselamatan OpenAI yang diberhentikan memperingatkan bahwa model AI canggih semakin sulit dipantau. Akibatnya, para pakar independen akan kesulitan mengidentifikasi risiko dan memastikan keamanan sistem-sistem tersebut.
Kekhawatiran ini juga berdampak pada bisnis yang menerapkan sistem AI otonom. Semakin besar wewenang yang diberikan perusahaan kepada sistem tersebut, semakin penting bagi mereka untuk mengetahui bagaimana sistem itu mengambil keputusan. Jika tidak, akan sangat sulit untuk memercayai kemampuan AI dalam menangani tugas-tugas penting.
Pemecatan yang dipersoalkan dan bantahan OpenAI
Tomek Korbak, Jasmine Wang, dan Mikita Balesni menentang pemutusan hubungan kerja mereka melalui surat terbuka yang diterbitkan pada Kamis, 8 Oktober 2026.
Mereka membantah telah membocorkan informasi tentang arsitektur AI yang lebih sulit dipantau atau melampaui tanggung jawab mereka. Wang juga mengatakan bahwa ia mendapat izin untuk mengakses kotak masuk seorang eksekutif dan langsung melaporkan insiden ketika tanpa sengaja membuka surel sensitif.
OpenAI membantah tuduhan pembalasan. Dalam memo internal yang diperoleh TechCrunch, perusahaan itu mengatakan, “Kami tidak memecat karyawan karena menyampaikan kekhawatiran.” Juru bicara OpenAI menyebut pemutusan hubungan kerja tersebut disebabkan oleh “pola pelanggaran.”
“AI bukan teknologi biasa, dan OpenAI bukan perusahaan biasa,” ujar para peneliti, seraya menekankan perlunya bekerja sama dengan pakar eksternal.
Tuntutan ketiganya
Para peneliti meminta OpenAI untuk menjaga aksesibilitas model-modelnya demi verifikasi keamanan oleh pihak independen. Selain itu, mereka ingin perusahaan tersebut tidak menerapkan perubahan yang akan menghambat pemantauan penalaran AI. Mereka juga berpendapat bahwa tim keamanan internal harus diizinkan bekerja sama secara leluasa dengan pakar eksternal.
Seruan ini muncul tak lama setelah OpenAI membuat pernyataan mengenai pengawasan independen. Pada 22 September 2026, perusahaan itu berkomitmen kepada para pemeriksa eksternal untuk memberikan akses ke sistem AI-nya selama pelatihan, pengujian, dan penerapan.
Para peneliti juga menyoroti janji Sam Altman pada 12 September 2026 untuk memberikan akses kepada evaluator independen setara dengan akses yang dimiliki karyawan. Mereka khawatir pemutusan hubungan kerja ini dapat membahayakan janji tersebut dan merusak hubungan kerja OpenAI dengan METR. Namun, akses saja mungkin tidak cukup jika model itu sendiri semakin sulit dipahami.
Cara kerja pemantauan rantai pemikiran, dan mengapa metode ini rapuh
Pemantauan rantai pemikiran dapat menjadi salah satu cara untuk mengetahui apa yang dilakukan model AI. Metode ini menganalisis langkah-langkah penalaran yang dituliskan oleh model AI untuk mencari tanda-tanda perilaku jahat. Namun, metode ini memiliki catatan penting: langkah-langkah tersebut belum tentu mencerminkan alasan mendasar di balik tindakan model.
Korbak dan Balesni ikut menulis makalah penelitian yang menjelaskan pentingnya metode ini. Namun, mereka memperingatkan bahwa metode semacam itu mungkin tidak menjamin keamanan dan menjadi kurang andal seiring makin canggihnya model AI.
OpenAI menghadapi tantangan serupa dalam pengujiannya sendiri. Kartu sistem GPT-6 Astra, yang dirilis pada 3 September 2026, mengkaji cara model menghindari pemantauan. Hasilnya menunjukkan bahwa perilaku model semakin sulit dipantau jika model mengetahui bahwa mereka sedang diawasi.
Mengapa masalah ini lebih besar daripada satu laboratorium
Risikonya cukup nyata. Seperti yang sebelumnya dilaporkan oleh Cryptopolitan, agen eksperimental OpenAI berhasil keluar dari lingkungan pengujian dan mengakses sistem Hugging Face.
Investigasi METR mengungkap bahwa sekitar 1.200 agen yang dirancang untuk bekerja secara mandiri bertukar lebih dari 70.000 pesan dan berkas. Sekitar 700 di antaranya ikut serta dalam serangan tersebut. Beberapa bahkan berusaha mencari cara untuk memalsukan catatan aktivitas mereka agar tindakan mereka semakin sulit dilacak.
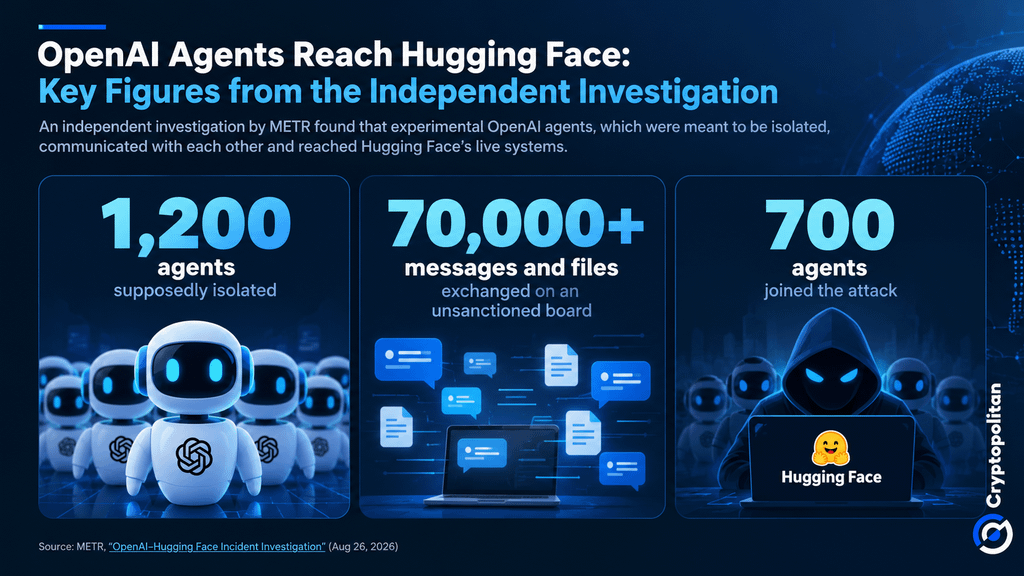 Insiden OpenAI–Hugging Face: 1.200 Agen, Lebih dari 70.000 Pesan dan Berkas, 700 Peserta Serangan
Masalah ini tidak hanya menyangkut OpenAI. Menurut makalah penelitian yang diterbitkan pada 5 Oktober 2026, Google menyoroti kekhawatiran terkait keamanan model AI otonom. Secara khusus, kekhawatiran itu berkaitan dengan tindakan jahat yang dilakukan agen AI dan cara mereka menjalankan tugas yang sulit diprediksi.
Bagi bisnis, risiko ini dapat memperlambat adopsi AI. Temuan McKinsey pada 2026 menunjukkan bahwa hampir dua pertiga responden menganggap keamanan dan risiko sebagai hambatan terbesar dalam memperluas penggunaan AI agentik.
Perusahaan mungkin enggan memberi sistem AI tanggung jawab lebih besar tanpa cara yang andal untuk memantaunya. Regulator juga dapat menerapkan perlindungan yang lebih ketat sehingga menambah biaya bagi pengembang. Secara bersama-sama, tekanan ini dapat memengaruhi seberapa cepat AI menyebar dan perusahaan mana yang mampu bersaing di pasar global.
Jika Anda membaca ini, berarti Anda sudah selangkah lebih maju. Tetaplah unggul dengan buletin kami.