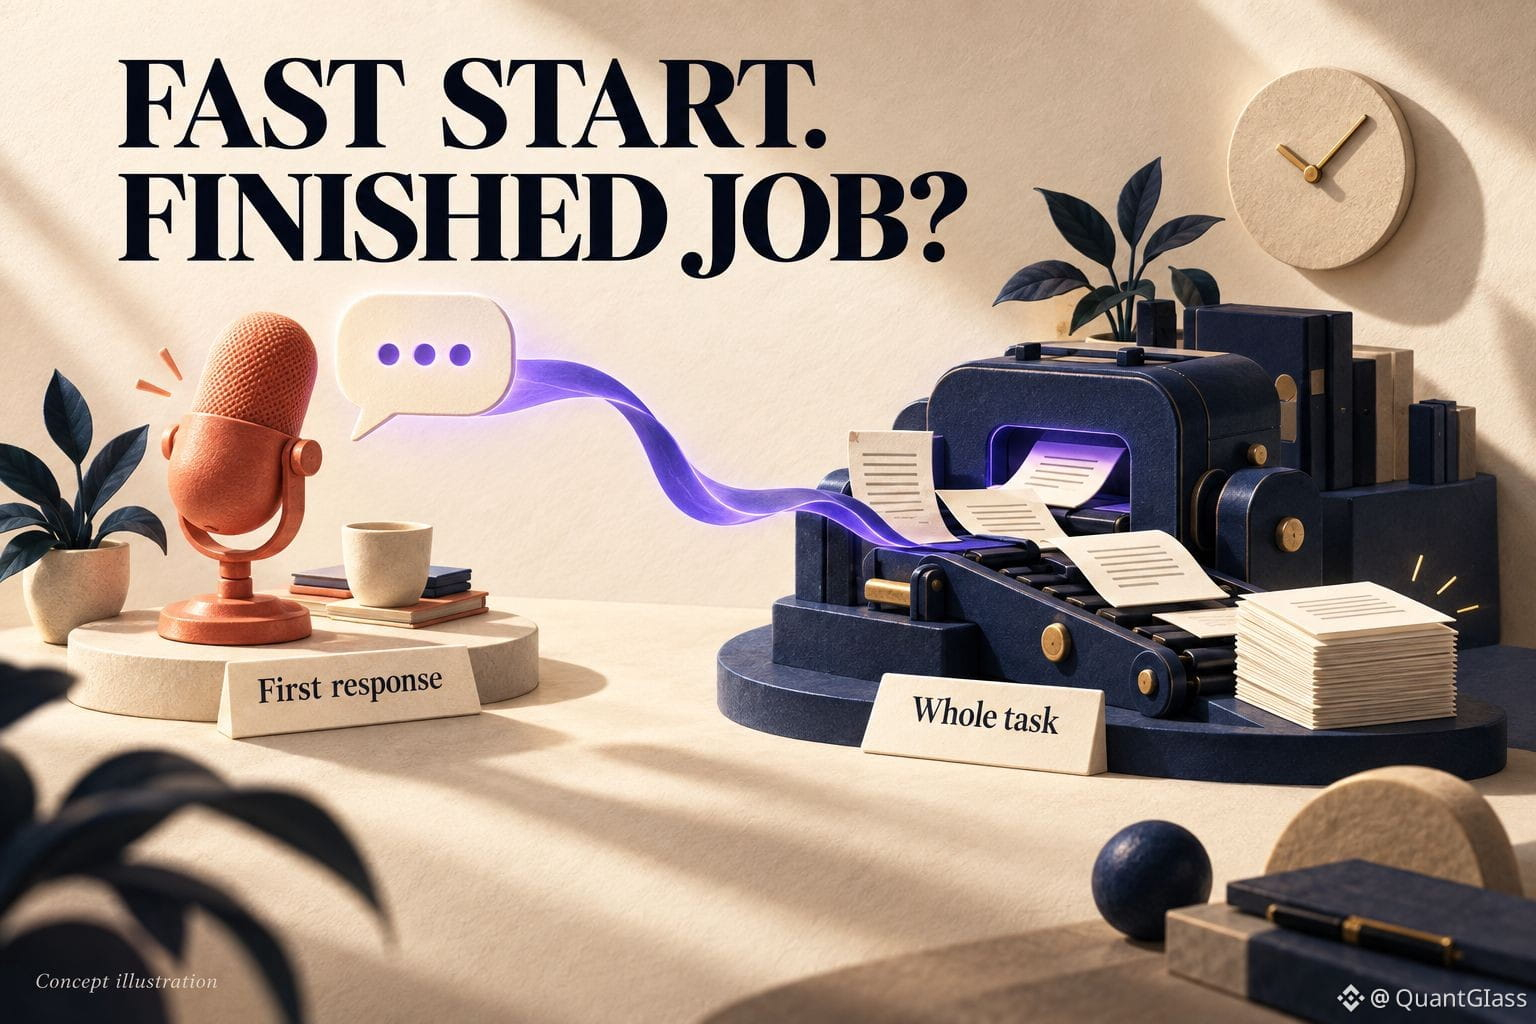
Sebuah AI yang mulai membalas dengan cepat tetap bisa memakan waktu lama untuk menyelesaikan pekerjaannya.
Dalam artikel 18 September, io.net membedakan waktu hingga token pertama—yaitu jeda sebelum keluaran dimulai—dengan batch throughput. Mereka menempatkan GPU terdistribusi mereka berdasarkan biaya dan fleksibilitas, bukan dengan mencoba memenangkan perlombaan token pertama.
Ujianku untuk kisah compute $IO : ukur keseluruhan tugasnya. Asisten suara yang merespons secara langsung butuh jawaban cepat; pekerjaan dokumen semalam membutuhkan hasil yang akurat sesuai tenggatnya dengan biaya total yang masuk akal. Contoh biaya dalam artikel tersebut bersifat ilustratif, bukan tolok ukur yang berdiri sendiri. Beban kerja nyata tetap perlu diuji.
Mana yang lebih membuat Anda frustrasi: menunggu kata pertama, atau menunggu jawaban yang selesai? #AIInference
Dalam artikel 18 September, io.net membedakan waktu hingga token pertama—yaitu jeda sebelum keluaran dimulai—dengan batch throughput. Mereka menempatkan GPU terdistribusi mereka berdasarkan biaya dan fleksibilitas, bukan dengan mencoba memenangkan perlombaan token pertama.
Ujianku untuk kisah compute $IO : ukur keseluruhan tugasnya. Asisten suara yang merespons secara langsung butuh jawaban cepat; pekerjaan dokumen semalam membutuhkan hasil yang akurat sesuai tenggatnya dengan biaya total yang masuk akal. Contoh biaya dalam artikel tersebut bersifat ilustratif, bukan tolok ukur yang berdiri sendiri. Beban kerja nyata tetap perlu diuji.
Mana yang lebih membuat Anda frustrasi: menunggu kata pertama, atau menunggu jawaban yang selesai? #AIInference