Ada seseorang yang melakukan uji coba AI untuk bertarung dalam game "StarCraft" (Brood War Bench), membuat model-model bahasa besar arus utama saat ini saling bertarung dalam strategi waktu nyata. Hasilnya, level semua model tidak melebihi pemain pemula.
"StarCraft: Brood War" adalah game strategi waktu nyata klasik dari tahun 1998, juga sudah lama menjadi teman dekat dalam riset AI. Pada 2019, AlphaStar dari DeepMind pernah mengalahkan pemain profesional di game ini. Namun saat itu, itu adalah AI pembelajaran penguatan yang dilatih secara khusus. Kali ini berbeda: uji coba ini membuat model bahasa umum masuk langsung sebagai agen AI yang bisa mengoperasikan game, untuk melihat apakah mereka bisa membangun markas sendiri, memproduksi pasukan, dan berperang.
Penulis Ben Swerdlow awalnya hanya membuat versi StarCraft yang “hanya bisa dikendalikan lewat aksi-aksi agen”, untuk dimainkan bersama teman. Tak disangka, beberapa teman yang hampir tidak pernah bermain justru tampil cukup baik. Mereka bilang mereka hanya memberi perintah singkat, “Pergi menyerang”, dan agen itu sendiri membangun pasukan kecil lalu maju.
Hal itu membuatnya penasaran: kalau AI dibiarkan bermain sepenuhnya, sejauh apa levelnya?
Jawabannya: levelnya masih rendah, tapi sangat menarik.
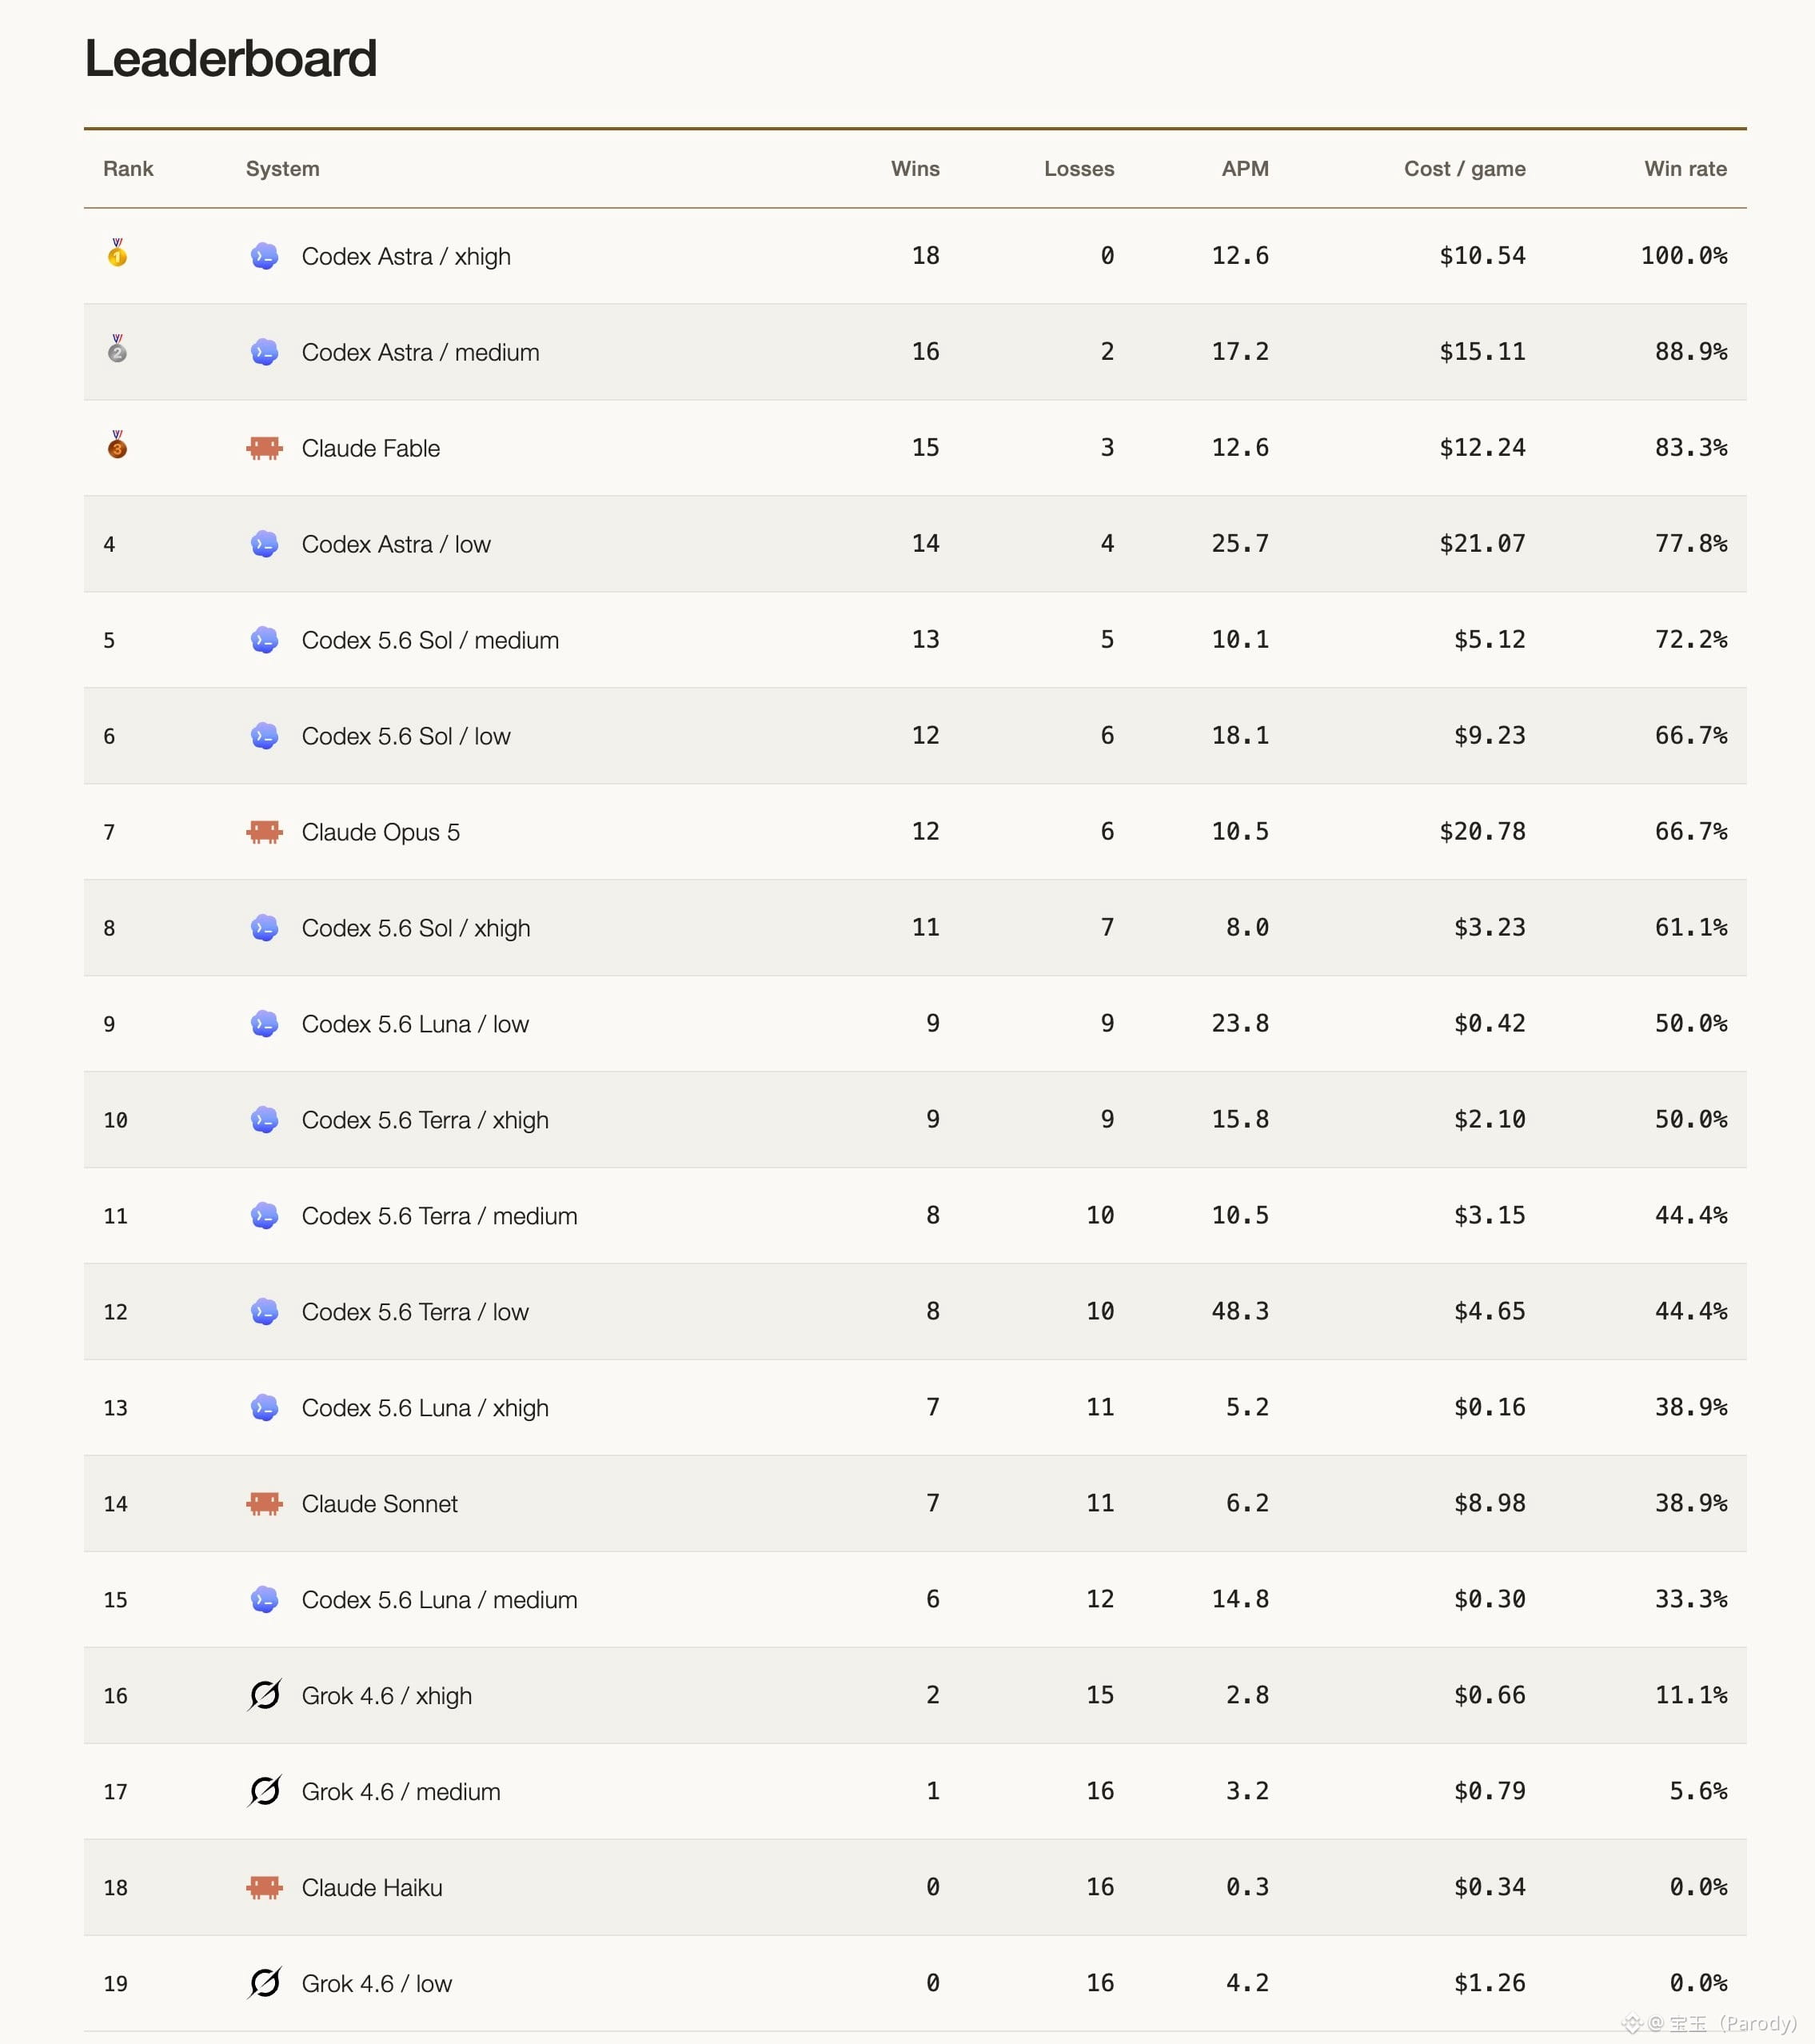
Codex Astra yang meraih peringkat pertama menang 18 pertandingan berturut-turut. Tapi keahliannya bukan pertempuran frontal, melainkan “gangguan”: mengirim satu pekerja penambang (Probe) untuk menyusup dan mengacau di pangkalan lawan. Trik ini sangat efektif untuk lawan AI, karena ketika agen lawan melihat ada seorang pekerja datang, mereka akan menghabiskan puluhan detik berpikir apa yang harus dilakukan—selama waktu itu mereka tidak melakukan apa pun. Dalam hal pengembangan ekonomi yang serius dan perang skala besar, Codex justru relatif lemah: sering kali hanya membuat satu-dua unit lalu melemparkannya ke lawan, alih-alih mengumpulkan kekuatan dulu sebelum menyerang.
Claude Fable berada di peringkat ketiga, dengan tingkat kemenangan 83,3%, dan merupakan model yang paling “terlihat serius sedang bermain game” di antara semua peserta. Ia akan dengan patuh mengembangkan ekonomi, naik melalui pohon teknologi, bahkan dalam satu ronde ia berhasil membangun naga terbang (Mutalisk), sementara di ronde lain ia meneliti teknologi Ksatria Kuil (Templar) (seperti tech untuk Dark/High Templar). Meski kadang risetnya sudah dilakukan banyak tetapi pasukan belum mengikuti, setidaknya dalam upaya “memahami aturan permainan”, Fable jauh lebih serius daripada siapa pun.
Performa Grok paling buruk. Grok 4.6 mengeluarkan lebih dari 11000 token penalaran dalam satu pertandingan berdurasi 43 menit, tetapi hanya mengeluarkan 6 batch perintah operasi; sepanjang pertandingan tidak membuat satu pun unit tempur. Secara esensial, Grok memperlakukan strategi waktu nyata seperti permainan bergiliran: terus berpikir, lupa untuk bergerak.
Uji coba ini mengungkap masalah inti: model bahasa besar saat ini masih sangat kurang mampu untuk lingkungan strategi waktu nyata yang menuntut observasi berkelanjutan, pengambilan keputusan cepat, dan koordinasi multi-thread. Bahkan model terbaik sekalipun, seseorang pemula yang jago menjalankan build serangan kilat paling dasar seperti “photon cannon rush” bisa memenangkan semua pertandingan. Tapi sebaliknya, model-model ini sudah bisa memahami konsep dasar seperti membangun, menambang, dan menyerang—hanya saja kemampuan mereka dalam eksekusi ritme dan koordinasi tugas masih jauh tertinggal.
Kode uji coba dan platform pertandingannya sudah dibuka. Siapa pun bisa membawa agen mereka sendiri untuk bertarung dalam satu pertandingan. Alamatnya adalah http://bw.swerdlow.dev.
"StarCraft: Brood War" adalah game strategi waktu nyata klasik dari tahun 1998, juga sudah lama menjadi teman dekat dalam riset AI. Pada 2019, AlphaStar dari DeepMind pernah mengalahkan pemain profesional di game ini. Namun saat itu, itu adalah AI pembelajaran penguatan yang dilatih secara khusus. Kali ini berbeda: uji coba ini membuat model bahasa umum masuk langsung sebagai agen AI yang bisa mengoperasikan game, untuk melihat apakah mereka bisa membangun markas sendiri, memproduksi pasukan, dan berperang.
Penulis Ben Swerdlow awalnya hanya membuat versi StarCraft yang “hanya bisa dikendalikan lewat aksi-aksi agen”, untuk dimainkan bersama teman. Tak disangka, beberapa teman yang hampir tidak pernah bermain justru tampil cukup baik. Mereka bilang mereka hanya memberi perintah singkat, “Pergi menyerang”, dan agen itu sendiri membangun pasukan kecil lalu maju.
Hal itu membuatnya penasaran: kalau AI dibiarkan bermain sepenuhnya, sejauh apa levelnya?
Jawabannya: levelnya masih rendah, tapi sangat menarik.
Codex Astra yang meraih peringkat pertama menang 18 pertandingan berturut-turut. Tapi keahliannya bukan pertempuran frontal, melainkan “gangguan”: mengirim satu pekerja penambang (Probe) untuk menyusup dan mengacau di pangkalan lawan. Trik ini sangat efektif untuk lawan AI, karena ketika agen lawan melihat ada seorang pekerja datang, mereka akan menghabiskan puluhan detik berpikir apa yang harus dilakukan—selama waktu itu mereka tidak melakukan apa pun. Dalam hal pengembangan ekonomi yang serius dan perang skala besar, Codex justru relatif lemah: sering kali hanya membuat satu-dua unit lalu melemparkannya ke lawan, alih-alih mengumpulkan kekuatan dulu sebelum menyerang.
Claude Fable berada di peringkat ketiga, dengan tingkat kemenangan 83,3%, dan merupakan model yang paling “terlihat serius sedang bermain game” di antara semua peserta. Ia akan dengan patuh mengembangkan ekonomi, naik melalui pohon teknologi, bahkan dalam satu ronde ia berhasil membangun naga terbang (Mutalisk), sementara di ronde lain ia meneliti teknologi Ksatria Kuil (Templar) (seperti tech untuk Dark/High Templar). Meski kadang risetnya sudah dilakukan banyak tetapi pasukan belum mengikuti, setidaknya dalam upaya “memahami aturan permainan”, Fable jauh lebih serius daripada siapa pun.
Performa Grok paling buruk. Grok 4.6 mengeluarkan lebih dari 11000 token penalaran dalam satu pertandingan berdurasi 43 menit, tetapi hanya mengeluarkan 6 batch perintah operasi; sepanjang pertandingan tidak membuat satu pun unit tempur. Secara esensial, Grok memperlakukan strategi waktu nyata seperti permainan bergiliran: terus berpikir, lupa untuk bergerak.
Uji coba ini mengungkap masalah inti: model bahasa besar saat ini masih sangat kurang mampu untuk lingkungan strategi waktu nyata yang menuntut observasi berkelanjutan, pengambilan keputusan cepat, dan koordinasi multi-thread. Bahkan model terbaik sekalipun, seseorang pemula yang jago menjalankan build serangan kilat paling dasar seperti “photon cannon rush” bisa memenangkan semua pertandingan. Tapi sebaliknya, model-model ini sudah bisa memahami konsep dasar seperti membangun, menambang, dan menyerang—hanya saja kemampuan mereka dalam eksekusi ritme dan koordinasi tugas masih jauh tertinggal.
Kode uji coba dan platform pertandingannya sudah dibuka. Siapa pun bisa membawa agen mereka sendiri untuk bertarung dalam satu pertandingan. Alamatnya adalah http://bw.swerdlow.dev.