最近研究 KGeN,有一个变化挺明显。
以前看到这种项目,我会先看:
币价。
现在会先问:
它到底在解决什么问题?
KGeN 给我的答案比较简单:
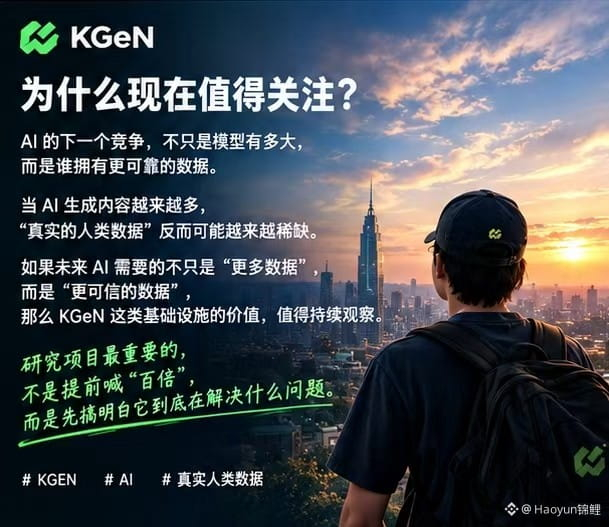
AI需要数据,但未来可能更需要“可信的人类数据”。
这个逻辑其实不难理解。
假设你让 AI 学习 1 亿条互联网内容。
听起来非常多。
但如果里面大量内容本身就是机器人生成的、AI生成的、重复的、低质量的……
数量再大也没什么意义。
反过来,如果数据来自不同国家、不同语言、不同生活环境,而且背后确实是经过验证的真人,那价值可能完全不一样。
KGeN 现在就是在往这个方向走。
官方目前把网络定位为 Verified Human Network,并进一步延伸到多模态数据、Physical AI 和 LLM。
我个人比较喜欢这种项目的一点是:
它至少不是在告诉你“AI很性感,所以我们也要AI”。
而是从一个比较具体的问题出发:
AI越来越强以后,哪里还能找到真实的人类?
这个问题有没有价值,我觉得不用急着下结论。
看看未来的数据需求、商业合作和真实使用情况,自然会给答案。
研究项目最重要的不是提前喊“百倍”,而是先搞明白它到底在解决什么问题。
这也是我最近看 KGeN 最大的感受。
#KGEN 🟩
以前看到这种项目,我会先看:
币价。
现在会先问:
它到底在解决什么问题?
KGeN 给我的答案比较简单:
AI需要数据,但未来可能更需要“可信的人类数据”。
这个逻辑其实不难理解。
假设你让 AI 学习 1 亿条互联网内容。
听起来非常多。
但如果里面大量内容本身就是机器人生成的、AI生成的、重复的、低质量的……
数量再大也没什么意义。
反过来,如果数据来自不同国家、不同语言、不同生活环境,而且背后确实是经过验证的真人,那价值可能完全不一样。
KGeN 现在就是在往这个方向走。
官方目前把网络定位为 Verified Human Network,并进一步延伸到多模态数据、Physical AI 和 LLM。
我个人比较喜欢这种项目的一点是:
它至少不是在告诉你“AI很性感,所以我们也要AI”。
而是从一个比较具体的问题出发:
AI越来越强以后,哪里还能找到真实的人类?
这个问题有没有价值,我觉得不用急着下结论。
看看未来的数据需求、商业合作和真实使用情况,自然会给答案。
研究项目最重要的不是提前喊“百倍”,而是先搞明白它到底在解决什么问题。
这也是我最近看 KGeN 最大的感受。
#KGEN 🟩