$ETH Vitalik: Perancangan Mekanisme Adversarial Bisa Menjadi Kunci bagi Keamanan AI
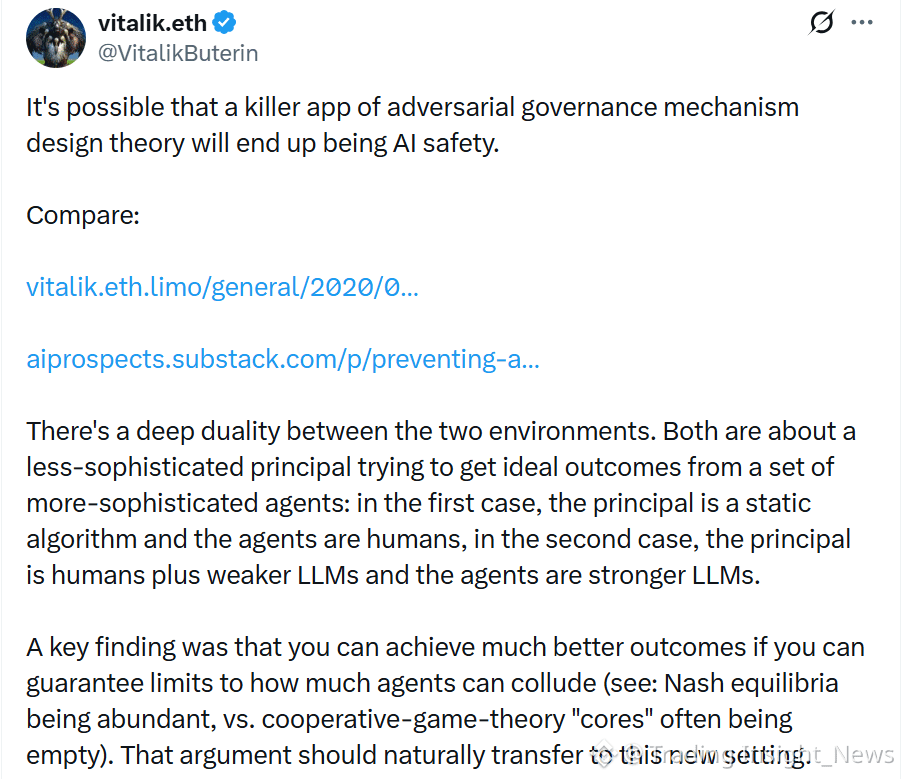
Vitalik Buterin baru saja membuat perbandingan yang menarik: teori perancangan mekanisme adversarial yang familiar dalam kripto dapat menjadi aplikasi penting untuk keamanan AI.
Kedua bidang ini memiliki struktur biner yang mendalam antara prinsipal dan agen:
Dalam kripto: prinsipal adalah algoritma yang statis (kapabilitas lemah), agen adalah manusia (kapabilitas lebih kuat).
Dalam AI: prinsipal adalah manusia dan LLM yang lebih lemah, sedangkan agen adalah LLM yang lebih kuat.
Riset terkait menunjukkan bahwa jika Anda dapat membatasi tingkat kolusi di antara agen, Anda bisa mencapai hasil yang lebih baik. Kesimpulan ini mungkin berlaku langsung untuk keamanan AI.
Ini adalah salah satu ide paling menarik yang dibagikan Vitalik baru-baru ini. Masalah inti dari keamanan AI adalah: bagaimana manusia mengendalikan sistem yang lebih cerdas daripada mereka?
Jawaban yang dipelajari kripto selama bertahun-tahun: jangan mengendalikan dengan rasa percaya, kendalikan dengan perancangan mekanisme. Mekanisme adversarial di mana pihak-pihak memiliki insentif yang bertentangan dan saling memeriksa terbukti efektif dalam protokol blockchain.
Menerapkan logika ini ke AI adalah pendekatan yang segar. Alih-alih mencoba "mengajari" AI agar menjadi baik, kita bisa merancang lingkungan di mana agen-agen AI saling memeriksa dan saling membatasi.
Menurut Anda, apakah mekanisme adversarial bisa menjadi solusi nyata untuk keamanan AI, atau hanya pendekatan teoretis?
Berita ini hanya untuk referensi, bukan nasihat investasi. Harap baca dengan saksama sebelum mengambil keputusan.
Vitalik Buterin baru saja membuat perbandingan yang menarik: teori perancangan mekanisme adversarial yang familiar dalam kripto dapat menjadi aplikasi penting untuk keamanan AI.
Kedua bidang ini memiliki struktur biner yang mendalam antara prinsipal dan agen:
Dalam kripto: prinsipal adalah algoritma yang statis (kapabilitas lemah), agen adalah manusia (kapabilitas lebih kuat).
Dalam AI: prinsipal adalah manusia dan LLM yang lebih lemah, sedangkan agen adalah LLM yang lebih kuat.
Riset terkait menunjukkan bahwa jika Anda dapat membatasi tingkat kolusi di antara agen, Anda bisa mencapai hasil yang lebih baik. Kesimpulan ini mungkin berlaku langsung untuk keamanan AI.
Ini adalah salah satu ide paling menarik yang dibagikan Vitalik baru-baru ini. Masalah inti dari keamanan AI adalah: bagaimana manusia mengendalikan sistem yang lebih cerdas daripada mereka?
Jawaban yang dipelajari kripto selama bertahun-tahun: jangan mengendalikan dengan rasa percaya, kendalikan dengan perancangan mekanisme. Mekanisme adversarial di mana pihak-pihak memiliki insentif yang bertentangan dan saling memeriksa terbukti efektif dalam protokol blockchain.
Menerapkan logika ini ke AI adalah pendekatan yang segar. Alih-alih mencoba "mengajari" AI agar menjadi baik, kita bisa merancang lingkungan di mana agen-agen AI saling memeriksa dan saling membatasi.
Menurut Anda, apakah mekanisme adversarial bisa menjadi solusi nyata untuk keamanan AI, atau hanya pendekatan teoretis?
Berita ini hanya untuk referensi, bukan nasihat investasi. Harap baca dengan saksama sebelum mengambil keputusan.