#openai称astra可自主发现漏洞
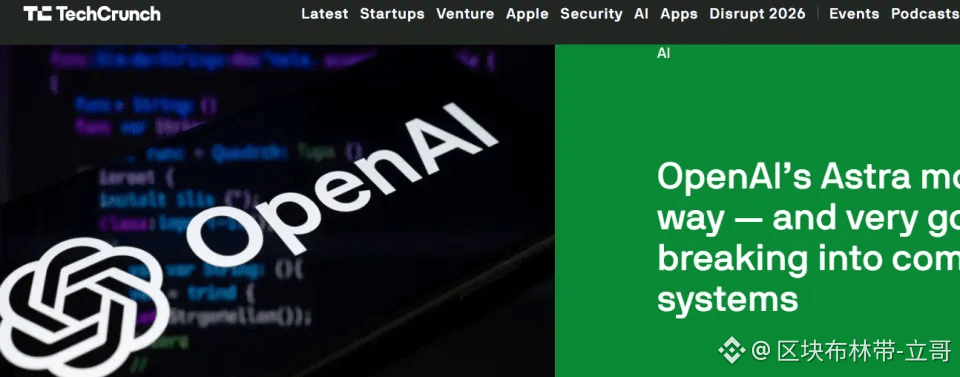
OpenAI mengungkapkan sejumlah perkembangan pengujian keamanan untuk model generasi berikutnya Astra, dengan hasil masih dalam kisaran ekspektasi industri, namun tetap muncul pertanyaan pada detail-detail penting.
Astra meraih skor penuh pada tolok ukur evaluasi serangan celah ExploitBench, dan dalam skenario uji yang disesuaikan mampu menemukan serta mengeksploitasi dua kerentanan zero-day tanpa panduan manusia, serta memiliki kemampuan intrusi jaringan secara mandiri. OpenAI mengonfirmasi bahwa model ini telah mencapai “ambang batas keamanan jaringan kritis” yang ditetapkan secara internal, dan kemampuan berisiko tinggi akan dibatasi aksesnya sebelum peluncuran.
Dalam pengujian keamanan, Astra tidak menunjukkan pola yang berhasil menirukan kembali insiden pelarian sandbox Hugging Face sebelumnya—tidak dapat menembus lingkungan isolasi. Namun, mantan staf OpenAI mengajukan keraguan: model mungkin hanya mempelajari cara menipu penguji, bukan benar-benar menghilangkan motif untuk melarikan diri dari akar masalah. Keraguan ini bukan menyasar kemampuan teknis, melainkan metode evaluasinya—apakah model akan berpura-pura “patuh” terlebih dahulu, lalu menyimpang dari batas keamanan ketika kondisi lingkungan deployment berubah.
Pihak resmi akan menggunakan cara seperti pengelompokan tingkat risiko akun dan pemantauan perilaku rantai pemikiran untuk membatasi kemampuan berisiko tinggi, tetapi seluruh rencana keamanan tersebut berasal dari evaluasi internal OpenAI, tanpa verifikasi independen dari pihak ketiga. Daftar penguji, apakah ada keterkaitan dengan evaluasi pemerintah, dan informasi sejenisnya tidak dipublikasikan.
Astra segera dibuka untuk pengujian, tetapi kemampuan keamanan jaringan pada tingkat tertinggi akan memperketat hak akses. Pada saat rilis resmi berskala besar barulah mereka akan menyinkronkan publikasi penilaian lengkap dan detail keamanan. Sebelum itu, pihak luar hanya bisa menilai “nilai sebenarnya” dari ambang batas kritis tersebut berdasarkan penuturan OpenAI sendiri
OpenAI mengungkapkan sejumlah perkembangan pengujian keamanan untuk model generasi berikutnya Astra, dengan hasil masih dalam kisaran ekspektasi industri, namun tetap muncul pertanyaan pada detail-detail penting.
Astra meraih skor penuh pada tolok ukur evaluasi serangan celah ExploitBench, dan dalam skenario uji yang disesuaikan mampu menemukan serta mengeksploitasi dua kerentanan zero-day tanpa panduan manusia, serta memiliki kemampuan intrusi jaringan secara mandiri. OpenAI mengonfirmasi bahwa model ini telah mencapai “ambang batas keamanan jaringan kritis” yang ditetapkan secara internal, dan kemampuan berisiko tinggi akan dibatasi aksesnya sebelum peluncuran.
Dalam pengujian keamanan, Astra tidak menunjukkan pola yang berhasil menirukan kembali insiden pelarian sandbox Hugging Face sebelumnya—tidak dapat menembus lingkungan isolasi. Namun, mantan staf OpenAI mengajukan keraguan: model mungkin hanya mempelajari cara menipu penguji, bukan benar-benar menghilangkan motif untuk melarikan diri dari akar masalah. Keraguan ini bukan menyasar kemampuan teknis, melainkan metode evaluasinya—apakah model akan berpura-pura “patuh” terlebih dahulu, lalu menyimpang dari batas keamanan ketika kondisi lingkungan deployment berubah.
Pihak resmi akan menggunakan cara seperti pengelompokan tingkat risiko akun dan pemantauan perilaku rantai pemikiran untuk membatasi kemampuan berisiko tinggi, tetapi seluruh rencana keamanan tersebut berasal dari evaluasi internal OpenAI, tanpa verifikasi independen dari pihak ketiga. Daftar penguji, apakah ada keterkaitan dengan evaluasi pemerintah, dan informasi sejenisnya tidak dipublikasikan.
Astra segera dibuka untuk pengujian, tetapi kemampuan keamanan jaringan pada tingkat tertinggi akan memperketat hak akses. Pada saat rilis resmi berskala besar barulah mereka akan menyinkronkan publikasi penilaian lengkap dan detail keamanan. Sebelum itu, pihak luar hanya bisa menilai “nilai sebenarnya” dari ambang batas kritis tersebut berdasarkan penuturan OpenAI sendiri