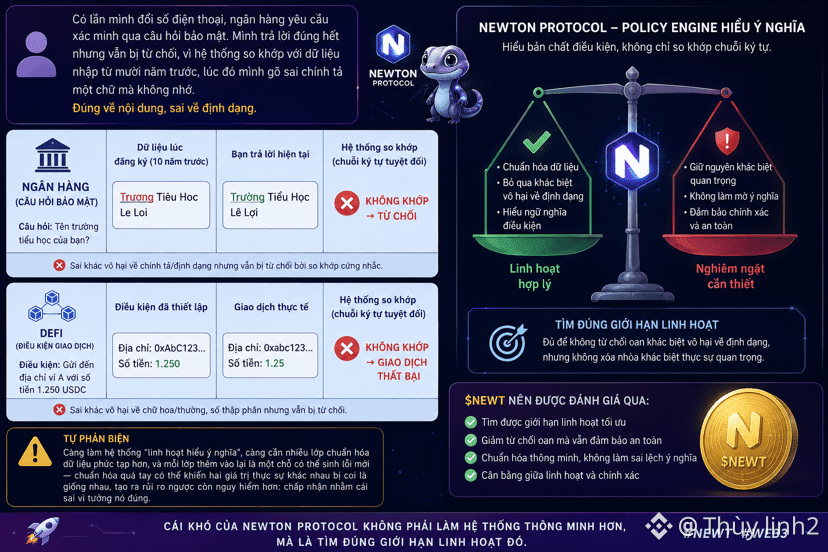
Suatu kali aku mengganti nomor telepon, bank meminta verifikasi lewat pertanyaan keamanan. Aku menjawab semuanya dengan benar, tapi tetap ditolak, karena sistem mencocokkan dengan data yang dimasukkan dari sepuluh tahun lalu; pada saat itu aku salah mengetik satu huruf dan tidak mengingatnya. Benar dalam isi, salah dalam format, dan sistem tidak bisa membedakan dua jenis kesalahan itu.
DeFi juga punya pola kekeliruan yang mirip—perbedaan antara huruf kapital dan huruf kecil pada sebuah alamat, perbedaan pembulatan angka dengan angka desimal, semuanya bisa membuat kondisi yang secara substansi benar dianggap tidak cocok, hanya karena pencocokan string secara absolut, bukan karena memahami maknanya.
@NewtonProtocol Jika engine policy bisa memahami makna kondisi, bukan sekadar pencocokan yang kaku, akan berkurang banyak kasus penolakan yang tidak semestinya seperti ini.
Sanggahan diri: tapi semakin sistem “fleksibel memahami makna”, semakin dibutuhkan banyak lapisan standardisasi data yang rumit, dan setiap lapisan yang ditambahkan justru bisa menjadi sumber kesalahan baru—standardisasi yang berlebihan bisa membuat dua nilai yang sebenarnya berbeda dianggap sama, sehingga justru menimbulkan risiko yang terbalik dan bahkan lebih berbahaya: menerima kesalahan karena mengira itu benar.
Ke-sulitannya pada @NewtonProtocol bukan membuat sistem jadi lebih pintar, melainkan menemukan batas fleksibilitas yang tepat—cukup untuk tidak menolak perbedaan yang tidak berbahaya akibat format, tapi tidak sampai mengaburkan juga perbedaan yang benar-benar penting.
$NEWT nOleh karena itu, seharusnya dinilai berdasarkan kemampuan menemukan batas itu di mana, bukan hanya berdasarkan apakah teknologi memahami makna bahasa diterapkan atau tidak.
#newt $LAB $SAROS