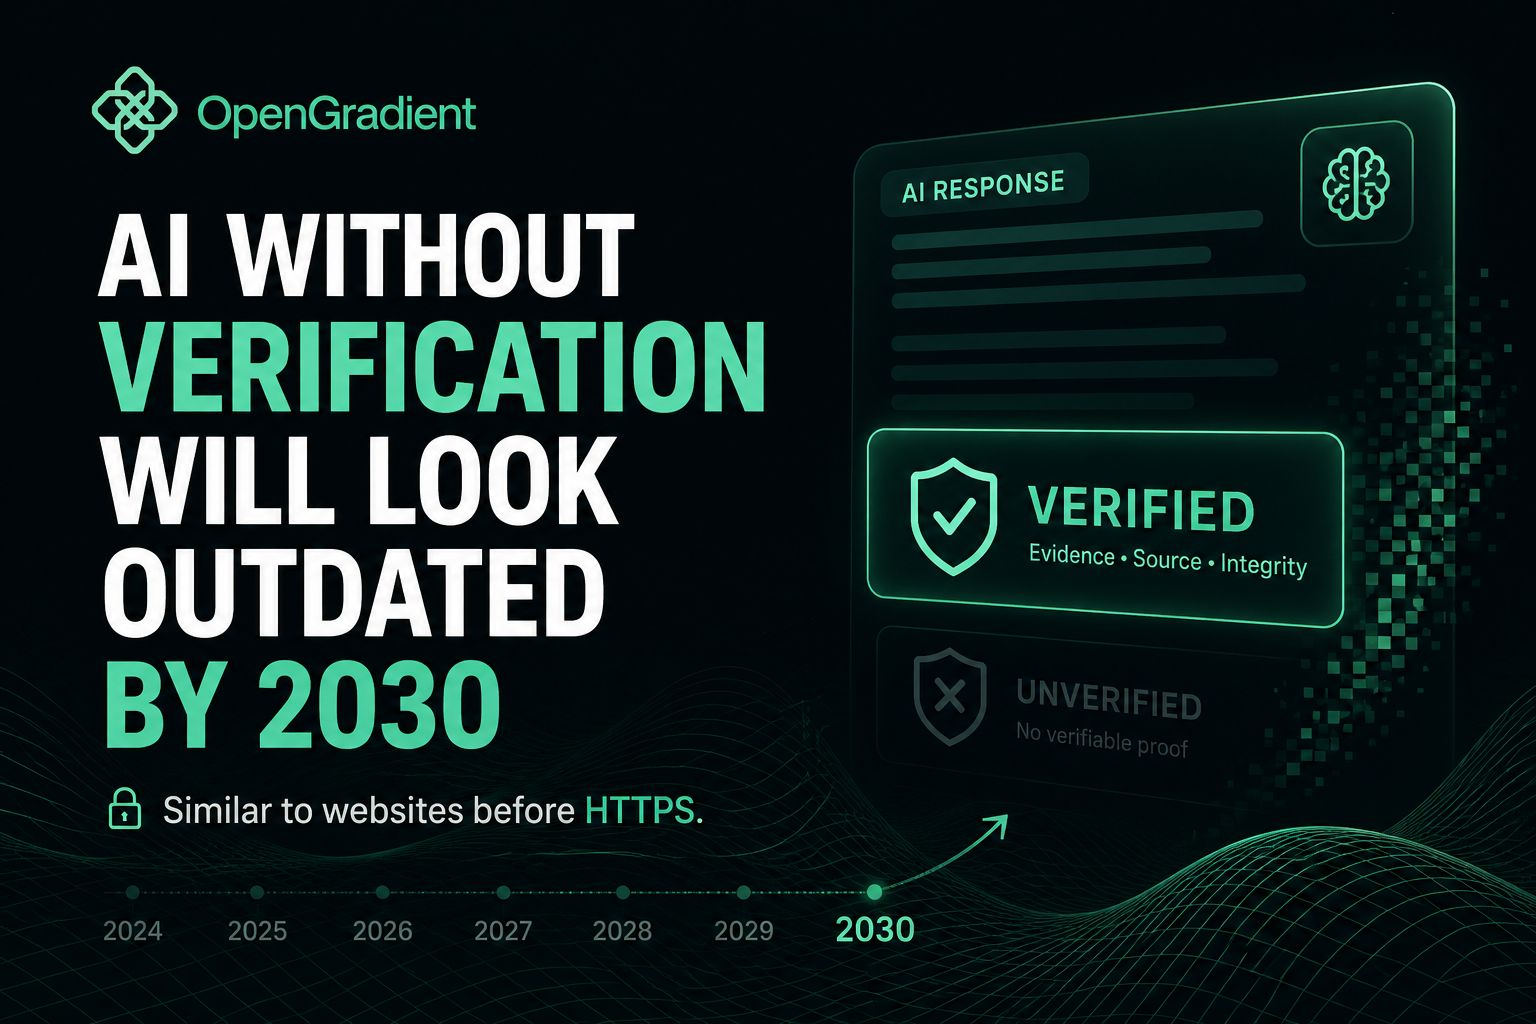

opAI tanpa verifikasi mulai terasa seperti situs web sebelum HTTPS.
Tidak rusak. Tidak tidak dapat digunakan. Hanya kurang sesuatu yang pada akhirnya berhenti diterima orang.
Saya baru-baru ini melihat OpenGradient dan satu angka terus menarik perhatian saya kembali: 156.461 inferensi privat diproses dalam satu bulan. Volume itu sendiri bukan bagian yang menarik. Yang menarik adalah pertanyaan yang menyusul.
Berapa banyak dari output itu yang bisa seseorang verifikasi secara independen?
Saya terus memikirkan bagaimana kita saat ini berinteraksi dengan sebagian besar sistem AI. Kita mendapat jawaban, mungkin skor kepercayaan, mungkin sumber jika kita beruntung. Lalu kita memutuskan apakah akan mempercayainya. Banyak kepercayaan itu masih berasal dari reputasi, bukan dari bukti.
Itu terasa sementara.
Semakin sering saya menggunakan sistem yang menampilkan bukti tentang apa yang terjadi selama inferensi, semakin aneh model lama itu terasa. Bukan karena setiap hasil tiba-tiba menjadi sempurna. Beberapa respons masih rata-rata. Beberapa kemungkinan salah.
Perbedaannya adalah visibilitas.
Beberapa tahun lalu, sebuah situs web yang meminta informasi pribadi tanpa HTTPS terasa normal. Lalu itu menjadi tanda peringatan. Browser melatih semua orang untuk memperhatikan ketiadaan verifikasi.
Saya menduga AI akan mengikuti jalur yang mirip.
Bukan tahun ini. Mungkin bukan tahun depan.
Tapi pada tahun 2030, mendapatkan hasil penting yang dihasilkan AI tanpa cara untuk memverifikasi dari mana asalnya, bagaimana diproduksi, atau apakah telah diubah, mungkin akan terasa sangat ketinggalan.
Bagian yang masih belum pasti bagi saya adalah apakah pengguna akan menuntut perubahan itu lebih dulu, atau apakah infrastrukturnya sampai lebih dulu sebelum siapa pun mulai memintanya.
@OpenGradient $OPG #OPG
Pada tahun 2030, apa yang paling penting saat mengevaluasi respons AI?
Tidak rusak. Tidak tidak dapat digunakan. Hanya kurang sesuatu yang pada akhirnya berhenti diterima orang.
Saya baru-baru ini melihat OpenGradient dan satu angka terus menarik perhatian saya kembali: 156.461 inferensi privat diproses dalam satu bulan. Volume itu sendiri bukan bagian yang menarik. Yang menarik adalah pertanyaan yang menyusul.
Berapa banyak dari output itu yang bisa seseorang verifikasi secara independen?
Saya terus memikirkan bagaimana kita saat ini berinteraksi dengan sebagian besar sistem AI. Kita mendapat jawaban, mungkin skor kepercayaan, mungkin sumber jika kita beruntung. Lalu kita memutuskan apakah akan mempercayainya. Banyak kepercayaan itu masih berasal dari reputasi, bukan dari bukti.
Itu terasa sementara.
Semakin sering saya menggunakan sistem yang menampilkan bukti tentang apa yang terjadi selama inferensi, semakin aneh model lama itu terasa. Bukan karena setiap hasil tiba-tiba menjadi sempurna. Beberapa respons masih rata-rata. Beberapa kemungkinan salah.
Perbedaannya adalah visibilitas.
Beberapa tahun lalu, sebuah situs web yang meminta informasi pribadi tanpa HTTPS terasa normal. Lalu itu menjadi tanda peringatan. Browser melatih semua orang untuk memperhatikan ketiadaan verifikasi.
Saya menduga AI akan mengikuti jalur yang mirip.
Bukan tahun ini. Mungkin bukan tahun depan.
Tapi pada tahun 2030, mendapatkan hasil penting yang dihasilkan AI tanpa cara untuk memverifikasi dari mana asalnya, bagaimana diproduksi, atau apakah telah diubah, mungkin akan terasa sangat ketinggalan.
Bagian yang masih belum pasti bagi saya adalah apakah pengguna akan menuntut perubahan itu lebih dulu, atau apakah infrastrukturnya sampai lebih dulu sebelum siapa pun mulai memintanya.
@OpenGradient $OPG #OPG
Pada tahun 2030, apa yang paling penting saat mengevaluasi respons AI?
🟢 Smarter models
80%
⚪ Privacy and ownership
7%
⚪ Speed and convenience
7%
⚪ Verifiable proof of output
6%
15 Voting • Voting ditutup