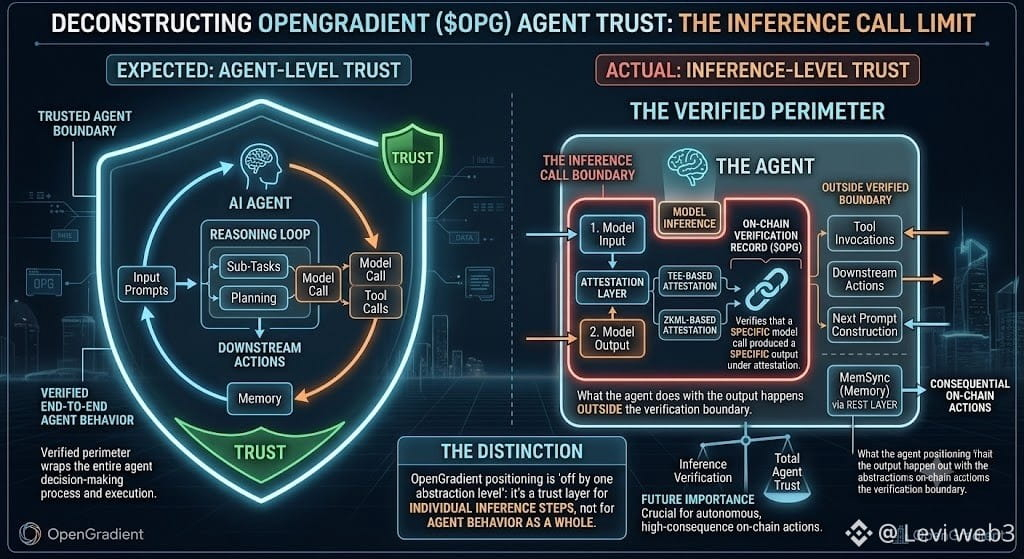
Ketika saya mulai membaca posisi OpenGradient tentang kepercayaan agen, saya berharap menemukan sistem verifikasi yang membungkus loop keputusan agen. Namun, yang saya temukan ternyata lebih sempit: infrastruktur @OpenGradient 's $OPG memverifikasi bahwa panggilan model tertentu menghasilkan output tertentu di bawah attestasi — berbasis TEE atau berbasis ZKML — tetapi agen itu sendiri bukan unit kepercayaan. Perimeter yang terverifikasi dimulai dan diakhiri pada panggilan inferensi. Apa yang dilakukan agen dengan output itu — tindakan downstream, pemanggilan alat, konstruksi prompt berikutnya — terjadi di luar batas verifikasi. Memori, melalui MemSync, beroperasi sebagai lapisan REST terpisah dan tidak masuk ke dalam catatan verifikasi on-chain. Jadi ketika #OPG mendeskripsikan "lapisan kepercayaan untuk agen AI," ketepatan berada satu tingkat abstraksi salah: ini adalah lapisan kepercayaan untuk langkah inferensi individu yang mungkin dimiliki agen, bukan untuk perilaku agen secara keseluruhan. Perbedaan itu mungkin tidak terlalu penting saat ini dibandingkan dengan saat agen mulai melakukan tindakan on-chain yang konsekuensial secara otonom. Apa yang akan diakui saat itu — dan apa yang tidak — akan menentukan apa yang sebenarnya berarti "terpercaya."