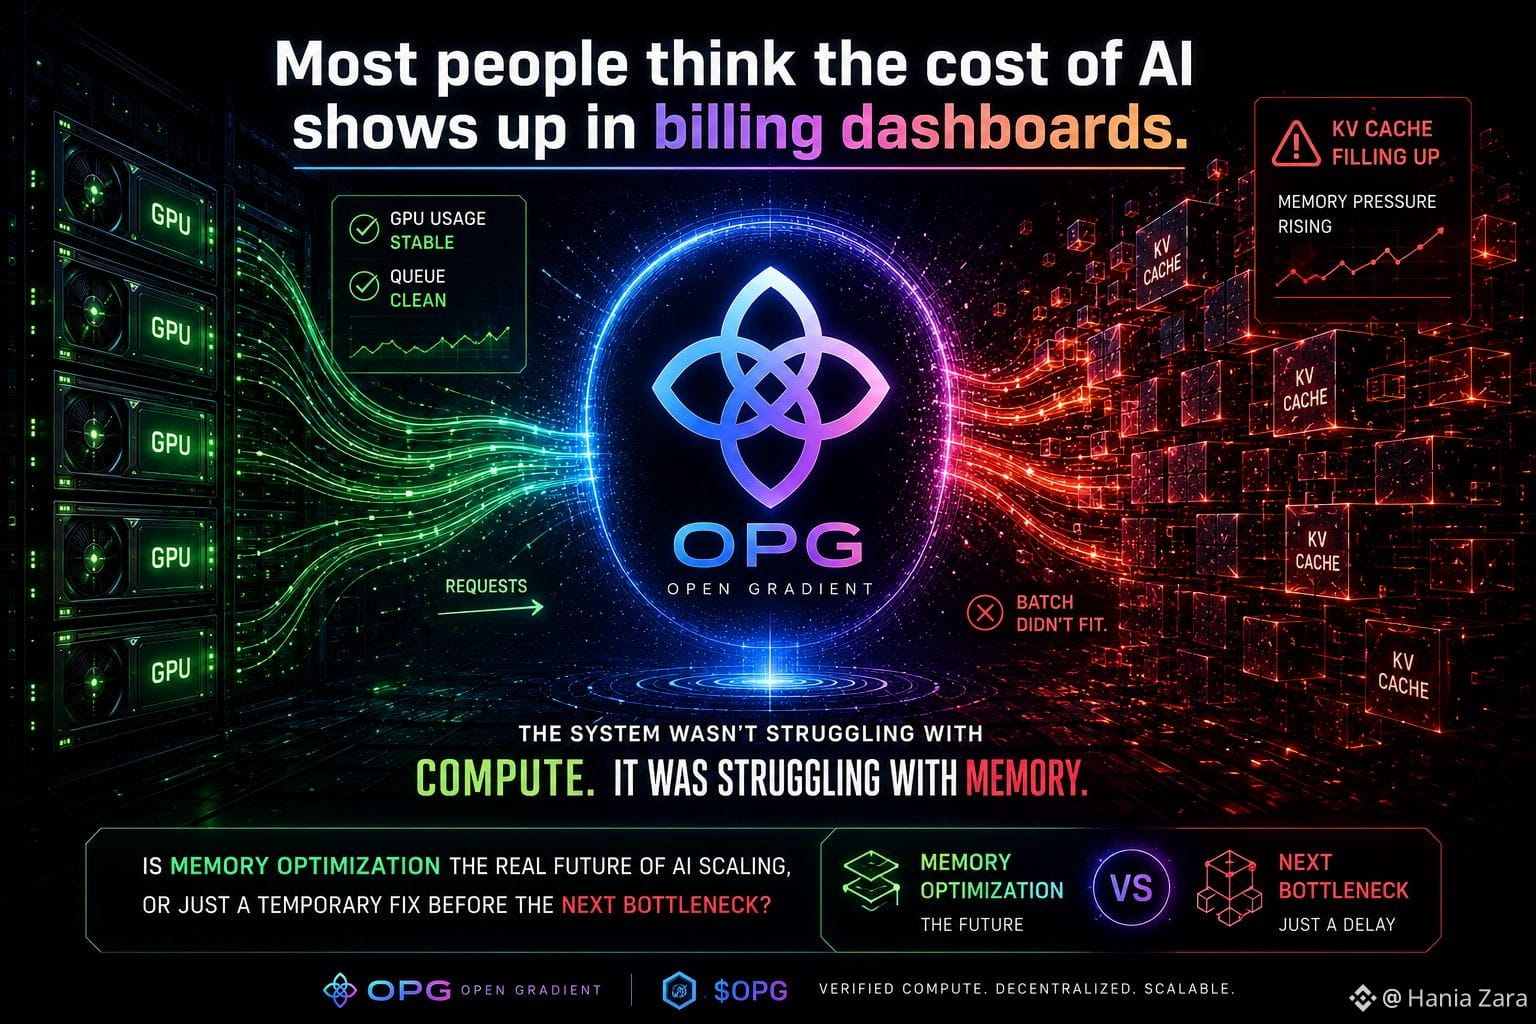
Kebanyakan orang berpikir bahwa biaya AI muncul di dashboard tagihan.
Tapi jujur saja… itu bukan tempat di mana kamu benar-benar merasakannya.
Pertama kali saya menyadarinya, semuanya terlihat baik-baik saja — penggunaan GPU stabil, antrean bersih, tidak ada yang mencolok sama sekali.
Tapi satu batch masih tidak cocok.
Dan saat itulah saya menyadari… sistem tidak kesulitan dalam komputasi.
Sistem kesulitan dengan memori.
Prompt panjang diam-diam menahan cache KV seperti ruang sementara yang tidak pernah sepenuhnya dilepaskan — perlahan-lahan mengurangi seberapa banyak yang sebenarnya dapat ditangani oleh sistem.
Manajemen cache KV berbasis paging mencoba memperbaiki ini dengan membagi memori menjadi halaman yang lebih kecil dan dapat digunakan kembali. Lebih banyak permintaan masuk, percakapan panjang tidak langsung menjadi kendala.
Tapi inilah debat sebenarnya:
Apakah ini cukup untuk masa depan sistem AI seperti OpenGradient Chat (https://chat.opengradient.ai)?
Atau kita hanya menunda kendala berikutnya?
Karena menskalakan komputasi yang terverifikasi dengan $OPG bukan hanya masalah performa lagi… ini adalah masalah arsitektur.
Jadi, menurutmu:
👉 Apakah optimisasi memori adalah masa depan nyata dari penskalaan AI, atau hanya perbaikan sementara?
@OpenGradient
#opengradientchat
#OPG
$OPG
Tapi jujur saja… itu bukan tempat di mana kamu benar-benar merasakannya.
Pertama kali saya menyadarinya, semuanya terlihat baik-baik saja — penggunaan GPU stabil, antrean bersih, tidak ada yang mencolok sama sekali.
Tapi satu batch masih tidak cocok.
Dan saat itulah saya menyadari… sistem tidak kesulitan dalam komputasi.
Sistem kesulitan dengan memori.
Prompt panjang diam-diam menahan cache KV seperti ruang sementara yang tidak pernah sepenuhnya dilepaskan — perlahan-lahan mengurangi seberapa banyak yang sebenarnya dapat ditangani oleh sistem.
Manajemen cache KV berbasis paging mencoba memperbaiki ini dengan membagi memori menjadi halaman yang lebih kecil dan dapat digunakan kembali. Lebih banyak permintaan masuk, percakapan panjang tidak langsung menjadi kendala.
Tapi inilah debat sebenarnya:
Apakah ini cukup untuk masa depan sistem AI seperti OpenGradient Chat (https://chat.opengradient.ai)?
Atau kita hanya menunda kendala berikutnya?
Karena menskalakan komputasi yang terverifikasi dengan $OPG bukan hanya masalah performa lagi… ini adalah masalah arsitektur.
Jadi, menurutmu:
👉 Apakah optimisasi memori adalah masa depan nyata dari penskalaan AI, atau hanya perbaikan sementara?
@OpenGradient
#opengradientchat
#OPG
$OPG