Selesai dengan tugasnya. Tuang sedikit air. Satu hal masih mengganjal di pikiranku.
@OpenGradient $OPG #OPG berfungsi sebagai pondasi untuk intelijen yang terpercaya — setiap inferensi bisa diverifikasi, setiap model bisa diaudit, seluruh tumpukan dirancang untuk membangun AI yang benar-benar bisa kamu andalkan. Pitch itu terasa berbeda setelah aku menggali dokumen Model Hub.
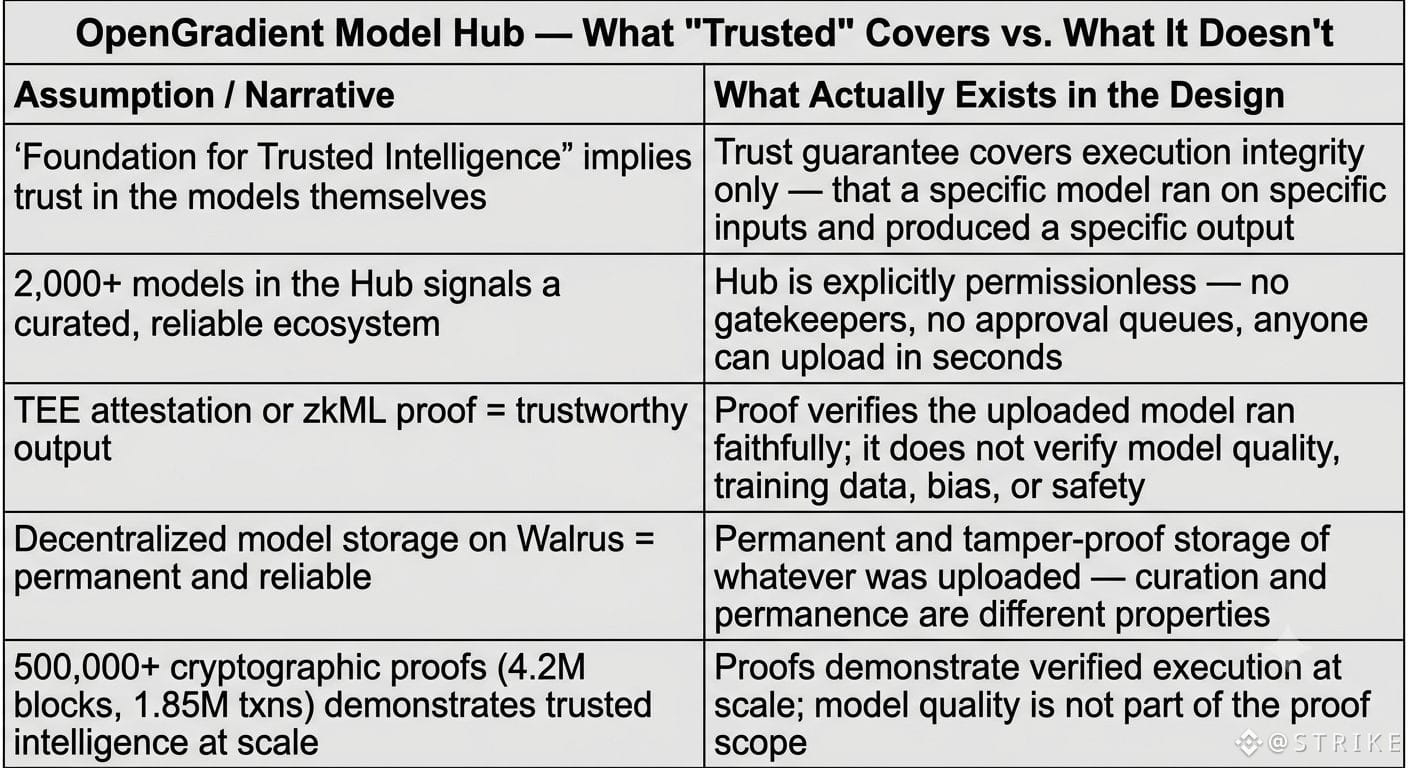
Hub ini secara eksplisit tanpa izin. Dokumennya menyatakan secara langsung: siapa pun bisa mengupload model tanpa penjaga gerbang dan tanpa antrean persetujuan, langsung tersedia untuk inferensi di seluruh jaringan. 2.000+ model dari 100+ pengembang sudah live. Dan bagian integritas eksekusi benar-benar berfungsi — TEE attestation atau zkML mengonfirmasi bahwa model yang diupload tertentu dijalankan pada input tertentu dan menghasilkan output tertentu, semua diverifikasi di konsensus sebelum penyelesaian. Jaringan telah menyelesaikan 4,2 juta blok dan 1,85 juta transaksi dengan 500.000+ bukti kriptografi yang mendukung itu.
Tunggu sebentar — tetapi. Bukti itu mengesahkan bahwa model dijalankan dengan setia. Itu tidak mengatakan apa-apa tentang apakah model itu sendiri dibangun dengan baik, tidak bias, aman, atau layak untuk dipercaya sejak awal. Model yang dilatih dengan buruk yang diupload tanpa izin, dijalankan di dalam TEE, menghasilkan output yang sepenuhnya terverifikasi tetapi mungkin berkualitas rendah. Eksekusinya terverifikasi. Intelijensinya tidak.
Aku terus membaca halaman Model Hub berharap menemukan lapisan kurasi yang terlewat. Tidak ada, memang dirancang seperti itu.
Jadi apa arti sebenarnya dari "intelijen terpercaya" ketika jaminan kepercayaan berlaku untuk eksekusi dari apa pun yang diupload oleh siapa pun, bukan pada kualitas atau asal-usul dari apa yang diupload?
@OpenGradient $OPG #OPG berfungsi sebagai pondasi untuk intelijen yang terpercaya — setiap inferensi bisa diverifikasi, setiap model bisa diaudit, seluruh tumpukan dirancang untuk membangun AI yang benar-benar bisa kamu andalkan. Pitch itu terasa berbeda setelah aku menggali dokumen Model Hub.
Hub ini secara eksplisit tanpa izin. Dokumennya menyatakan secara langsung: siapa pun bisa mengupload model tanpa penjaga gerbang dan tanpa antrean persetujuan, langsung tersedia untuk inferensi di seluruh jaringan. 2.000+ model dari 100+ pengembang sudah live. Dan bagian integritas eksekusi benar-benar berfungsi — TEE attestation atau zkML mengonfirmasi bahwa model yang diupload tertentu dijalankan pada input tertentu dan menghasilkan output tertentu, semua diverifikasi di konsensus sebelum penyelesaian. Jaringan telah menyelesaikan 4,2 juta blok dan 1,85 juta transaksi dengan 500.000+ bukti kriptografi yang mendukung itu.
Tunggu sebentar — tetapi. Bukti itu mengesahkan bahwa model dijalankan dengan setia. Itu tidak mengatakan apa-apa tentang apakah model itu sendiri dibangun dengan baik, tidak bias, aman, atau layak untuk dipercaya sejak awal. Model yang dilatih dengan buruk yang diupload tanpa izin, dijalankan di dalam TEE, menghasilkan output yang sepenuhnya terverifikasi tetapi mungkin berkualitas rendah. Eksekusinya terverifikasi. Intelijensinya tidak.
Aku terus membaca halaman Model Hub berharap menemukan lapisan kurasi yang terlewat. Tidak ada, memang dirancang seperti itu.
Jadi apa arti sebenarnya dari "intelijen terpercaya" ketika jaminan kepercayaan berlaku untuk eksekusi dari apa pun yang diupload oleh siapa pun, bukan pada kualitas atau asal-usul dari apa yang diupload?