
Juni di timur laut sedang musim hujan, udara lembab dan hujan yang tak henti-hentinya di luar membuat orang merasa gelisah tanpa alasan. Kebetulan hari ini adalah saat terakhir untuk misi $OPEN #CreatorPad , udara di sekitar dipenuhi dengan seruan untuk segera naik dan teriakan besar 'kesetaraan data di era AI'. Saya menyeduh secangkir kopi yang pahit dan pekat, menatap layar komputer di mana berita lama tentang kolaborasi OpenLedger dan Story Protocol yang meluncurkan 'AI otomatisasi hak royalti' yang sempat menggemparkan, terjebak dalam rollercoaster emosi yang panjang dan menyakitkan.
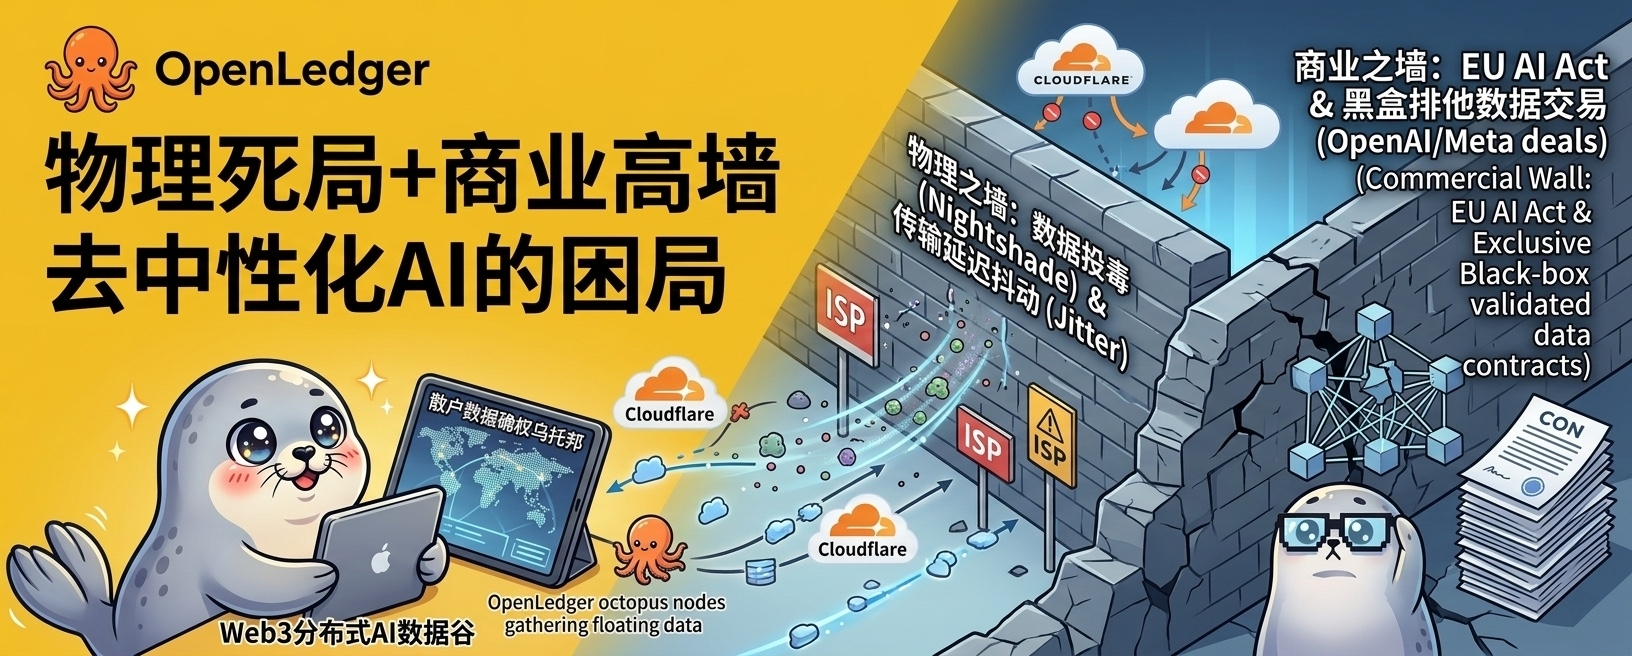
Hari ini, saat saya memaksa diri untuk keluar dari perspektif hukum yang sempit, ditambah dengan pandangan berbasis rekayasa jaringan dan logika machine learning, saya mulai meninjau keseluruhan blueprint teknologi dan siklus bisnisnya, rasa kagum yang awalnya saya rasakan hancur seperti gelembung yang pecah, hanya menyisakan rasa dingin di hati—saya menyadari bahwa narasi besar ini, di hadapan hukum fisika dasar, keamanan data, dan tembok tinggi hukum komersial yang nyata, rapuh seperti kertas yang basah.
Titik awal yang menakjubkan: Dahulu saya juga berdiri dan bertepuk tangan.
Harus diakui, \u003cm-33/\u003e dan Story Protocol yang bekerja sama menggambarkan rencana yang secara logika sangat menarik. Dalam rantai industri AI tradisional, pencipta, pembersih data, dan node tepi selalu berada di dasar rantai makanan. Raksasa seperti OpenAI dan Google, dengan kekuatan komputasi dan tim hukum yang besar, dengan bebas mengekstraksi data gratis global untuk melatih model. Sementara \u003ct-35/\u003e yang mengusulkan Datanets (dataset kepemilikan komunitas) dan ModelFactory, tepat mengenai titik sakit ini. Kombinasi ini dengan Story Protocol menciptakan lingkaran tertutup yang terdengar hampir sempurna: ritel berkontribusi data melalui node, OpenLedger menggunakan Proof of Attribution untuk mencatat setiap kontribusi Anda terhadap model AI di rantai; setelah model tersebut menghasilkan penerapan dalam komersialisasi, protokol dasar Story Protocol akan secara otomatis mengaktifkan, membayar royalti dalam bentuk mikro-transaksi melalui token OPEN kepada kontributor data awal.
Bukankah ini adalah utopia AI terdistribusi yang absolut adil dalam Web3 yang kita idam-idamkan? Jujur, ketika saya melihat desain ini untuk pertama kalinya, saya hampir berdiri dan bertepuk tangan. Tetapi justru konsistensi logika ini yang membuat saya semakin merasakan setiap lapisan risiko ketika saya menyelidiki lebih dalam dalam beberapa hari berikutnya.
Kelemahan fatal di bawah bayang-bayang 'Nightshade': konsensus desentralisasi tidak dapat menghindari 'serangan data beracun'.
OpenLedger selalu menekankan bahwa Datanets-nya bisa menghasilkan materi pelatihan berkualitas tinggi. Namun, ada sebuah paradoks logika yang sangat besar dan hampir tak terpecahkan: mekanisme konsensus jaringan desentralisasi hanya bisa memverifikasi apakah data telah 'mencapai kesepakatan', tetapi sama sekali tidak bisa memverifikasi 'kebenaran absolut' data di dunia fisik.
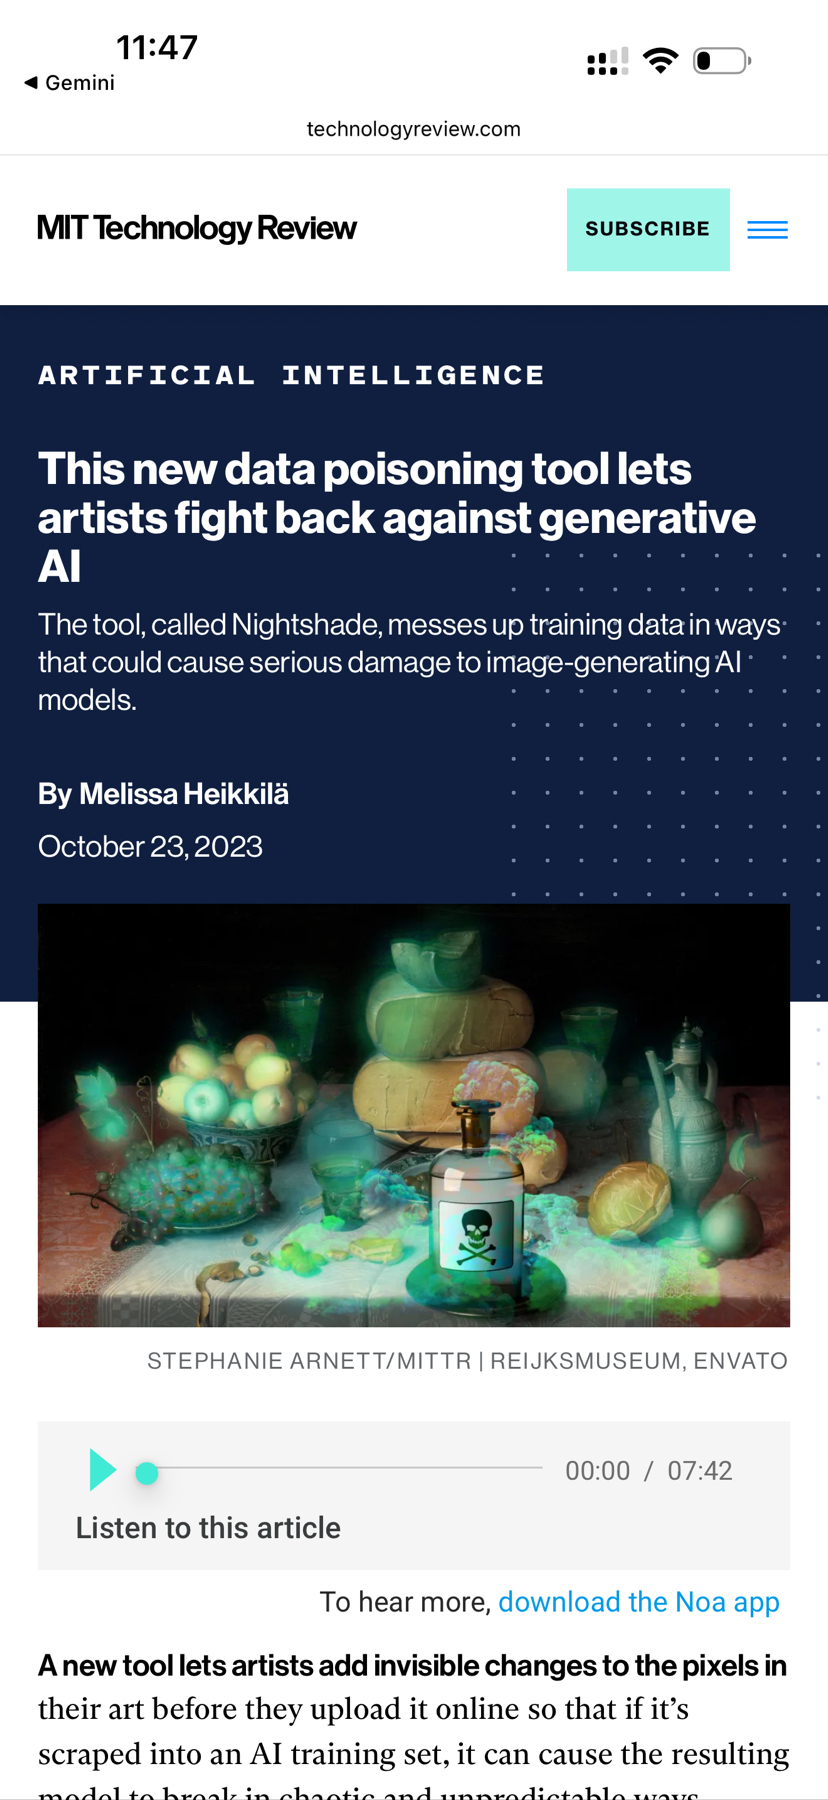
Sejak 2023, alat AI beracun bernama Nightshade yang dirilis oleh Universitas Chicago telah menggemparkan komunitas geek. Lihat gambar di bawah. Yang menakutkan dari alat ini adalah kemampuannya untuk memodifikasi gambar atau teks pada tingkat piksel yang tidak dapat terdeteksi oleh mata telanjang. Anda melihatnya sebagai seekor kucing, tetapi model AI mengenalinya sebagai anjing.
Sekarang, apa yang akan terjadi jika alat menakutkan ini dibawa ke jaringan terdistribusi OpenLedger?
Dalam jaringan tanpa izin yang terdesentralisasi, setiap node dapat mengirimkan data. Jika sekelompok peretas jahat, atau pesaing, menggunakan alat seperti Nightshade untuk melakukan 'serangan beracun yang tidak terlihat' pada sejumlah besar data, lalu menyebarkannya melalui puluhan ribu node anonim ke jaringan OpenLedger, algoritma konsensus jaringan hanya akan membandingkan hash atau format data tersebut apakah sesuai. Node antara bahkan bisa memberikan suara untuk data 'beracun' ini karena kepentingan yang sama. Apa hasilnya? Begitu model AI B-side mengakuisisi data terdesentralisasi yang terkontaminasi ini, bobot jaringan saraf model tersebut akan mengalami kerusakan yang menghancurkan, yang dalam pembelajaran mesin disebut 'model collapse'.
Di perusahaan besar yang terpusat, pembersihan data memiliki mekanisme pemisahan dan akuntabilitas yang ketat; tetapi dalam jaringan yang sepenuhnya terdistribusi ini, siapa yang bertanggung jawab atas 'serangan beracun'? Jika bahkan 'kemurnian' data tidak bisa dijamin 100% secara teknik, perusahaan AI dengan valuasi miliaran mana yang berani mempercayakan nyawa model besar mereka kepada jaringan anonim yang bisa saja diserang dengan data beracun? Memikirkan ini, saya benar-benar terkejut. 'Kepastian data' yang disebutkan, syaratnya adalah data harus 'data baik'. Tidak mampu menghindari serangan beracun, produk yang dihasilkan oleh jaringan ini hanyalah tumpukan sampah digital yang mahal.
Kutukan fisik dari latensi jitter: mimpi buruk saluran AI perusahaan.
Titik kedua yang menghancurkan pertahanan mental saya adalah dinding fisik perangkat keras yang sangat nyata. Jika Anda baru-baru ini mengikuti dinamika Silicon Valley, Anda akan tahu bahwa LPU (Language Processing Unit) seperti Groq yang dirancang khusus untuk inferensi AI, atau arsitektur terbaru dari Nvidia, Blackwell, semuanya sedang bersaing keras dalam satu indikator: latensi super rendah dan konsistensi throughput data yang sangat tinggi. Saluran pengolahan data AI komersial modern meminta latensi transmisi data antara database vektor dan unit komputasi mencapai level mikrodetik. Sementara OpenLedger mencoba membangun jaringan seperti apa? Mereka ingin mengandalkan terminal yang tersebar di seluruh dunia dengan kondisi jaringan yang sangat berbeda untuk melakukan pembersihan dan pemrosesan vektorisasi data secara terdistribusi.
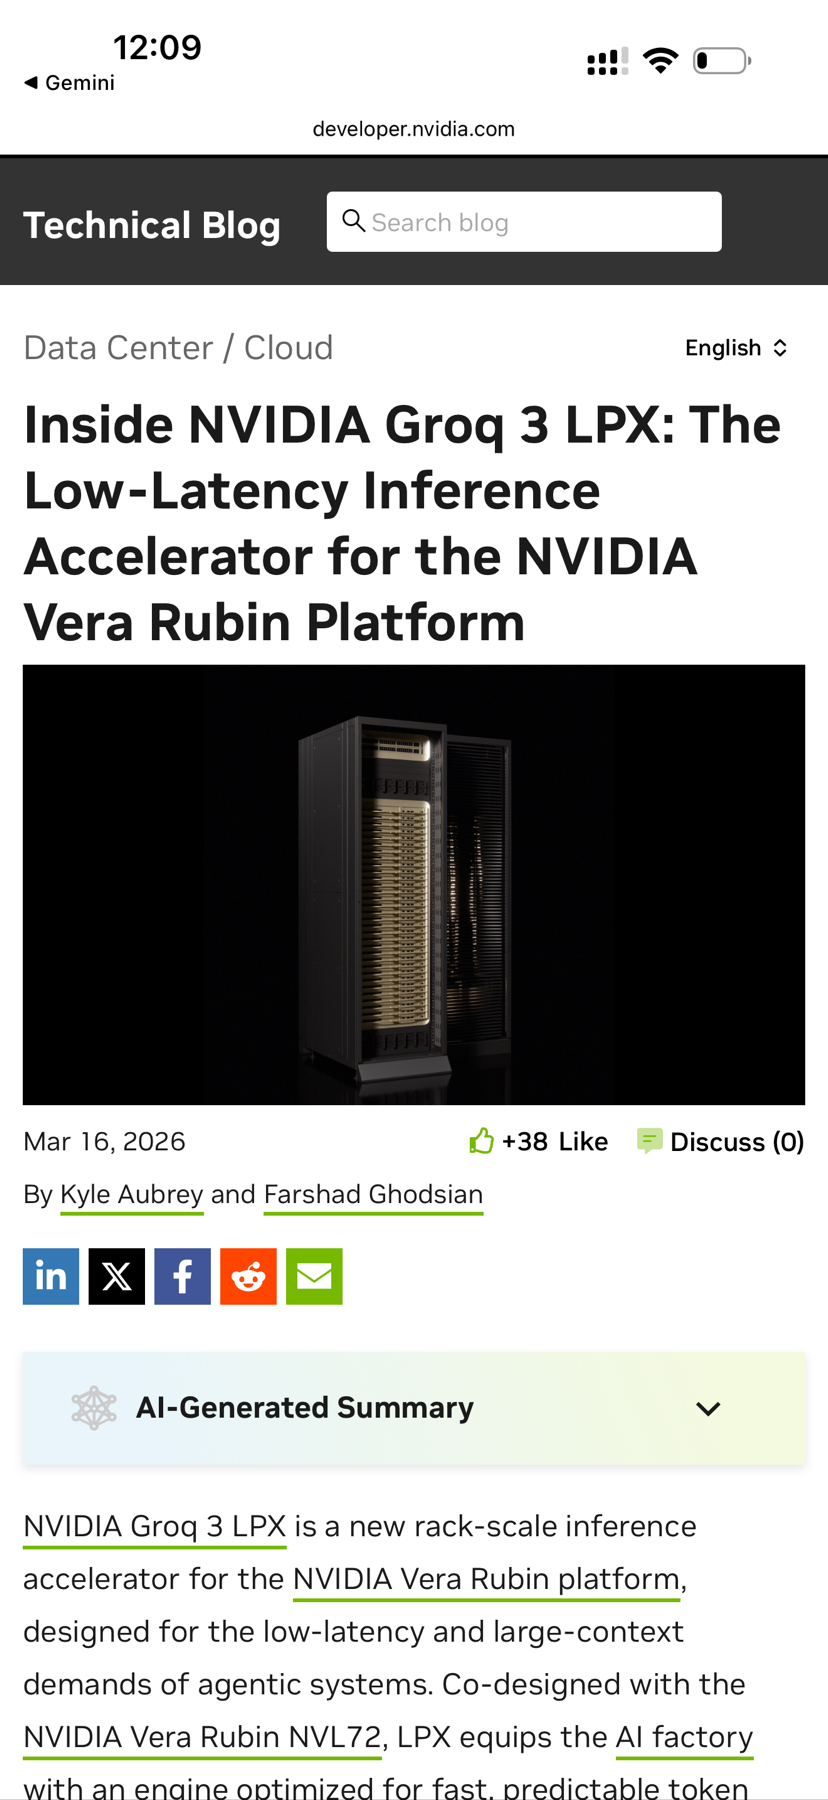
Saya telah mendalami bidang ini dengan seorang rekan yang memiliki pengalaman nyata dalam penggelaran cloud-natif, dan melihat arsitektur ini sungguh terasa absurd. Node Anda di Jepang kebetulan mengalami kemacetan jaringan, atau node di Timur Tengah kecepatan bandwidth-nya menurun hari ini, seluruh rantai pengolahan data akan mengalami lonjakan 'latensi jitter' dalam sekejap. Untuk aplikasi AI level perusahaan B-side yang membutuhkan stabilitas absolut dan umpan balik waktu nyata, latensi transmisi yang bisa mencapai ratusan milidetik bahkan beberapa detik dan tingkat kehilangan paket ini adalah bencana yang tidak bisa diterima secara teknik. Mereka mencoba menantang hukum fisika dari kecepatan cahaya dan teori topologi jaringan dengan 'political correctness' desentralisasi. Ini seperti mencoba menarik mesin jet Boeing 747 yang membutuhkan sinkronisasi tinggi dengan seribu traktor tangan yang dirakit. Konsepnya sangat menarik, tetapi praktiknya sangat mengecewakan.
Ketika saya menggabungkan dua kebuntuan fisika ini, keajaiban awal telah sepenuhnya digantikan oleh rasionalitas yang hampir dingin.
Biaya tersembunyi dari IP ritel.
Dalam proses emosi yang semakin tenang, ada satu dimensi lain yang membuat saya merasa merinding, yaitu pengepungan fisik yang telah terjadi di dunia nyata terhadap pengumpulan data desentralisasi.
\u003ca-63\u003eTentang fitur 'satu klik untuk membunuh crawler AI' yang diluncurkan Cloudflare pada 2024, saya telah membahasnya secara lengkap dalam artikel pendek sebelumnya.\u003c/a-63\u003e
Singkatnya, ketika node broadband rumah tangga tanpa sepengetahuan menyentuh firewall situs target, IP rumah akan segera ditandai sebagai 'sumber serangan berbahaya' oleh CDN internasional. Pukulan berat ini langsung mengenai kapiler di mana OpenLedger bergantung untuk bertahan, dan membuat narasi 'semua orang berkontribusi, semua orang mendapat manfaat' menjadi memiliki bayangan yang sangat tebal.
Kekurangan siklus bisnis: di bawah bayang-bayang Undang-Undang AI Uni Eropa, siapa yang akan membayar untuk 'self-hype di rantai'?
Lebih membuat putus asa adalah ketidakberdayaan sepenuhnya dari mekanisme royalti otomatis ini di depan logika hukum dan pengadaan bisnis yang nyata. Kita harus mengakui satu kenyataan yang sangat kejam: 'hak cipta' dan 'royalti' yang didefinisikan oleh jaringan desentralisasi tidak memiliki kemampuan untuk dipaksa kembali dan disesuaikan dalam ranah hukum raksasa Web2 tradisional. Pada tahun 2026, strategi hukum inti perusahaan seperti OpenAI, Meta, dan lainnya telah berevolusi untuk mengangkat bendera 'penggunaan yang wajar', atau langsung menandatangani perjanjian izin data kotak hitam eksklusif dengan grup media besar. Raksasa B-side yang menguasai kekuasaan absolut di industri tidak menemukan insentif bisnis untuk terhubung dengan sebuah perjanjian penyelesaian royalti desentralisasi yang berada di zona abu-abu dalam kerangka hukum yang terdiri dari ritel anonim di seluruh dunia. Tanpa akses dari pembeli terbesar ini, mekanisme pembayaran royalti otomatis OpenLedger hanya akan menjadi 'self-hype' di mana pengembang dalam ekosistem bermain game dengan diri mereka sendiri.
\u003ca-21\u003eDalam laporan Wall Street Journal, OpenAI menghabiskan lebih dari 250 juta dolar untuk membeli hak cipta eksklusif News Corp, sebuah kasus yang telah saya bahas dalam artikel pendek sebelumnya.\u003c/a-21\u003e
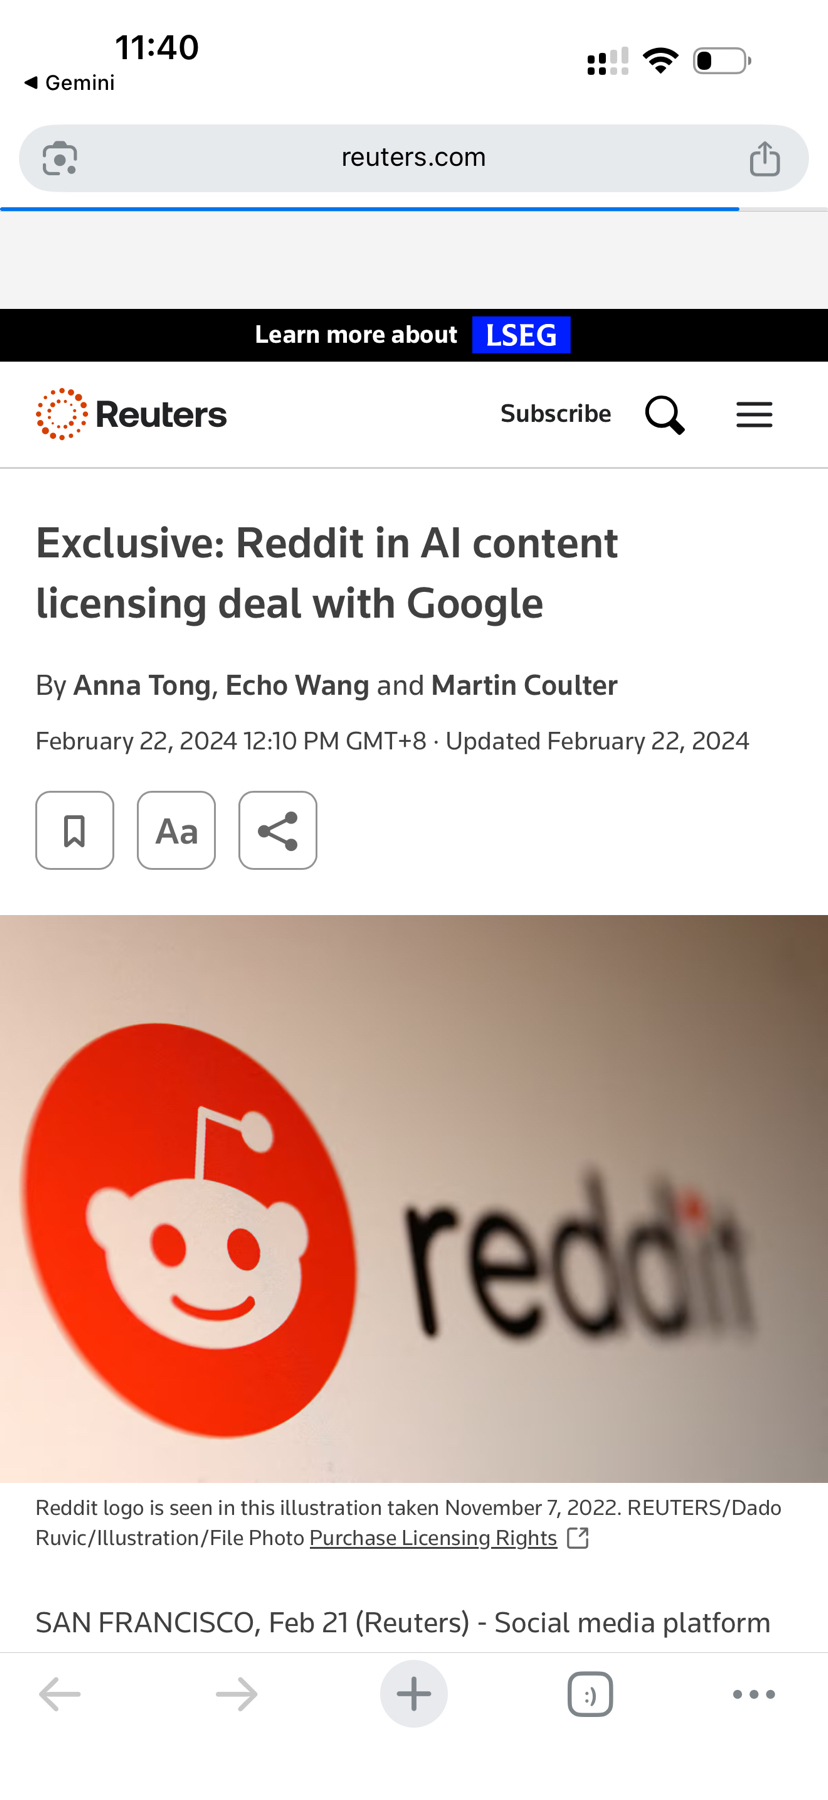
Misalnya, menurut laporan Reuters, pada 2024 Google dan Reddit telah mencapai kesepakatan data AI senilai 60 juta dolar per tahun.
Dan tirai besi regulasi Uni Eropa semakin membuat jalan yang sudah sempit ini hampir sepenuhnya tertutup. Dengan bertahannya Undang-Undang AI Uni Eropa, 'kebersihan' data pelatihan model besar telah dinaikkan ke tingkat politik dan hukum yang belum pernah terjadi sebelumnya. Berdasarkan persyaratan implementasi bertahap undang-undang, mulai Agustus 2025, penyedia model AI umum harus mempublikasikan ringkasan 'yang cukup detail' tentang konten data pelatihan, dan secara ketat menjalankan strategi kepatuhan pengelolaan data dan hak cipta; input data untuk sistem AI berisiko tinggi juga diharuskan untuk dapat dilacak, tidak bias, dan tanpa pelanggaran. Baru-baru ini, Komisi Uni Eropa telah secara jelas meminta semua penyedia model dasar yang beroperasi di dalam negeri untuk memberikan laporan audit tentang sumber pengumpulan data dan proses pembersihan, setiap data yang tidak jelas asalnya atau berpotensi melanggar hak dapat menyebabkan model keseluruhan diperintahkan untuk ditarik.
Di bawah tuntutan yang hampir ketat dari lineage data, Datanets OpenLedger hampir menginjak setiap ranjau. Saluran terdistribusinya bergantung pada ribuan node yang tidak terverifikasi KYC di seluruh dunia untuk meng-upload dan membersihkan data secara awal, bahkan jika hanya satu node yang dengan sengaja mencampurkan sedikit data beracun yang dilindungi, kepatuhan dataset seluruh rantai akan segera runtuh. Tidak ada perusahaan AI komersial yang akan mempertaruhkan model besar yang telah mereka investasikan miliaran untuk dilatih dan mendukung bisnis inti mereka pada kebersihan data dari jaringan anonim. Tidak peduli seberapa tinggi idealisme desentralisasi, di depan laporan audit kepatuhan yang dingin, setiap 'konsensus komunitas' tidak dapat menggantikan kekuatan hukum dari kepemilikan whitelist.
Penutup|Menjaga api tetap menyala, tetapi tidak lagi membayar untuk kebuntuan fisik dan ilusi bisnis.
Hujan di luar masih turun, kopi di cangkir sudah dingin. Saya tidak membenci tim OpenLedger; sebaliknya, saya adalah pendukung DeAI yang fanatik. Saya juga mengakui terobosan teknik dari arsitektur OpenLoRA dalam efisiensi penggelaran GPU tunggal, bahkan visi pendirinya, Pryce Adade-Yebesi, sangat futuristik. Namun, setelah membongkar semua kemewahan ini, yang saya lihat adalah konsensus yang rapuh dan tidak berdaya dalam menghadapi serangan data beracun, arsitektur dasar yang tidak tahan terhadap tuntutan latensi tinggi di AI level perusahaan, dan model bisnis yang tidak menemukan pijakan dalam celah hukum hak cipta dan strategi pengadaan raksasa. Ini bukan karena keputusasaan saya terhadap jalur DeAI+DePIN; sebaliknya, saya sangat berharap jalur ini bisa bertahan, sehingga saya tidak bisa lagi mentolerir proyek yang kekurangan pembeli komersial, kekurangan pengecualian hukum, dan perlindungan IP yang nyata, membiarkan node rumah tangga dan aset IP ritel berdiri di garis depan menghadapi kemarahan raksasa.
Sebelum pihak resmi dapat memberikan laporan 'uji tekanan anti-data beracun' yang nyata, yang telah diaudit oleh lembaga keamanan pihak ketiga, yang membuktikan bahwa latensi jaringan mereka dapat memenuhi kebutuhan pencarian vektor tingkat industri, dan menunjukkan laporan keuangan nyata dengan pesanan pengadaan yang sesuai dengan perusahaan AI level Web2 kelas dunia, saya akan menurunkan ekspektasi saya ke titik beku. Setiap rencana tentang 'royalti otomatis triliunan' di mata saya harus dikurangi dengan premi risiko yang sesuai. Pertahankan partisipasi minimum, jaga api tetap menyala, tetapi jangan pernah memperluas eksposur risiko aset secara buta - di bulan Juni yang dipenuhi dengan jebakan narasi ini, menjaga sedikit ketajaman dan rasionalitas seorang pria teknik mungkin adalah satu-satunya kehormatan yang bisa kita berikan kepada diri kita sendiri.
Saya mematikan layar, tetapi rasa dingin itu masih bertahan lama.
\u003cc-59/\u003e