
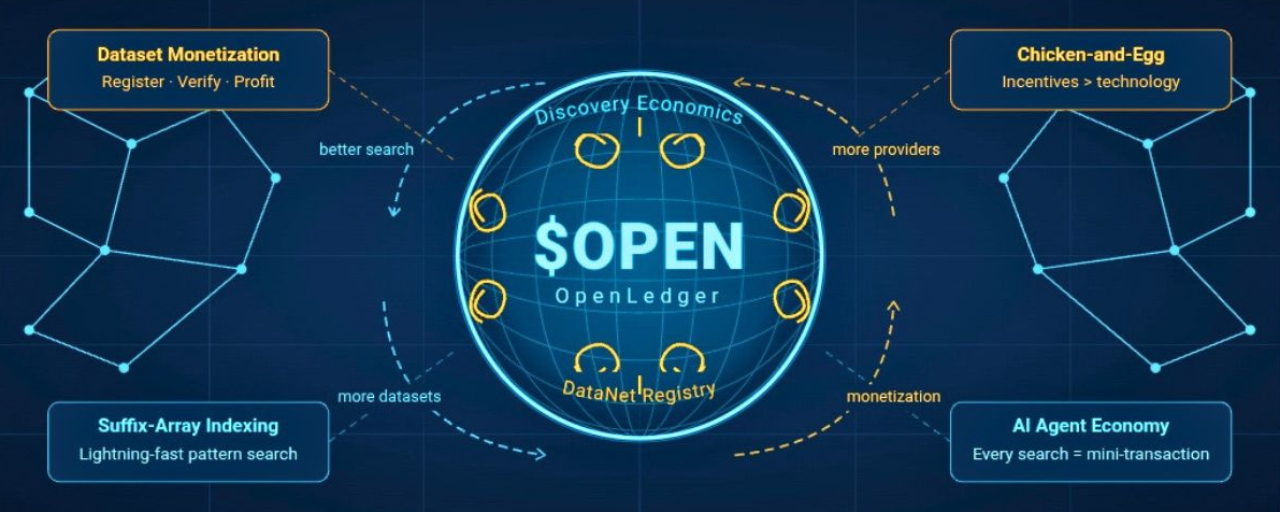


Pertama kali saya membuka DataNet Registry milik OpenLedger, saya mengharapkan cerita infrastruktur AI lainnya. Sebaliknya, itu membuat saya berpikir tentang basis data.
Biasanya, saat orang membahas infrastruktur AI, kamu akan mendengar tentang model-modelnya. Model yang lebih besar. Inferensi yang lebih cepat. Hasil yang lebih canggih. Tapi yang sebenarnya membuat atau menghancurkan sistem AI itu bukanlah modelnya; melainkan bagaimana kamu mengorganisir data di balik layar.
Perbedaannya, setidaknya dari apa yang saya lihat, adalah fokus OpenLedger pada penemuan—bukan hanya penyimpanan.
Bukan data sebenarnya. Hanya... bagaimana kamu menemukannya.
Perbedaan itu terasa lebih tajam daripada yang dipahami kebanyakan orang.
Semakin saya melihatnya, semakin terasa seperti Ekonomi Penemuan—gagasan bahwa menemukan data mungkin menjadi lebih berharga daripada menyimpannya.
Apa yang benar-benar menarik perhatian saya adalah melihat pengindeksan gaya suffix-array bekerja langsung ke dalam arsitektur mereka. Jika kamu belum pernah mendalami array suffix sebelumnya, saya menemukannya bertahun-tahun lalu saat mengutak-atik optimisasi pencarian. Premisnya sederhana, tapi agak liar—itu membiarkan kamu mengorganisir info sehingga pencarian pola langsung terpasang, cepat sekali.
Kedengarannya teknis, tentu saja, tapi dampak yang sebenarnya adalah ekonomi.
Karena ketika agen AI ini mulai bergerak sendiri, setiap pencarian menjadi transaksi mini. Setiap detik tambahan untuk mencari adalah gesekan. Setiap pencarian yang buntu? Komputasi kosong, energi terbuang. Ketika agen mulai membuat keputusan dalam skala besar, ketidakefisienan kecil itu mulai menumpuk seperti gila.
Itu saat DataNet Registry menjadi menarik bagi saya.
Alih-alih hanya membuang dataset ke internet sebagai file statis, sistem ini memperlakukannya lebih seperti aset yang bisa kamu temukan dan bahkan monetisasi. Sistem ini tidak hanya menyimpannya di laci—ia memberikan jalur terstruktur untuk mendaftar, memverifikasi, menemukan, dan mungkin menghasilkan profit dari dataset. Semua di bawah satu atap.
Efisiensi pencarian yang lebih baik meningkatkan produktivitas agen. Agen yang lebih produktif mengkonsumsi lebih banyak dataset. Lebih banyak penggunaan dataset menciptakan peluang monetisasi, yang menarik penyedia tambahan dan memperkuat jaringan. Itulah logika dasar di balik apa yang mulai saya sebut sebagai Ekonomi Penemuan.
Sejujurnya, jika kamu melihat kembali, lapisan penemuan memiliki cara untuk menutupi konten sebenarnya. Mesin pencari menjadi lebih besar daripada situs web. Toko aplikasi melampaui sebagian besar aplikasi individu. Marketplace menang karena mereka mengurangi kerepotan mencocokkan apa yang dibutuhkan orang dengan apa yang ditawarkan orang.
Saya terus berpikir—apakah itu juga bisa terjadi dengan dataset AI? Terutama dengan bagaimana semua ini berubah sekarang.
Kamu merasakan pasar kembali meluncur ke pembicaraan infrastruktur. AI mendapat sorotan, tanpa diragukan lagi, tetapi investor tampaknya lebih terfokus pada pipa dan saluran yang mendukungnya, bukan hanya model-model mencolok. Crypto sudah mengalami rotasi itu: pertama, kegembiraan yang liar tentang aplikasi… lalu semua orang mengejar jalur di bawahnya.
Kadang-kadang? Fase kedua ini menyerap lebih banyak nilai daripada yang pertama.
Tapi jaringan data menghadapi masalah bootstrap yang mengganggu ini. Registri hanya berfungsi ketika cukup banyak dataset menggoda berada di dalamnya. Dan dataset menggoda hanya muncul jika penemuan dan cara untuk menghasilkan uang dari mereka sudah berjalan dengan baik.
Total ayam-dan-telur.
Crypto terus tersandung di sini. Apakah itu pool likuiditas, jaringan oracle, penyimpanan terdesentralisasi—semua menghadapi variasi dari sakit kepala yang sama.
Incentif itu lebih penting dibandingkan teknologinya.
Registri yang indah? Tidak berarti orang akan berbondong-bondong masuk. Orang-orang ingin alasan nyata untuk berbagi data, menjaga kebersihan, dan mempercayai sistem. Jika tidak, kamu terjebak dengan rak mewah untuk informasi sampah—sebuah kota hantu digital.
Itu sejujurnya bagian yang masih saya perjuangkan.
Arsitekturnya keren—menggabungkan ilmu komputer lama dengan resep insentif blockchain baru. Tapi sejarah terus mengingatkan saya: kecemerlangan teknis dan keberlanjutan dunia nyata tidak selalu muncul bersamaan.
Mungkin percikan sebenarnya bukan sihir pengindeksan, tapi membuat kemampuan ditemukan itu sendiri menjadi penggerak ekonomi asli untuk AI.
Atau mungkin—ini sebenarnya hanya asap dan cermin.
Sepertinya kita masih di hari-hari awal, sejujurnya. Sulit untuk membedakan mana infrastruktur yang nyata dan mana yang hanya cerita yang mengenakan pakaian infrastruktur.
Ekonomi hanya berjalan jika kualitas dataset meningkat seiring dengan jumlah dataset. Pertumbuhan saja tidak cukup.
Mungkin itu yang sebenarnya sedang diuji oleh Ekonomi Penemuan—bukan apakah data memiliki nilai, tetapi apakah kemampuan untuk ditemukan bisa menjadi pasar tersendiri.
Jika kemampuan ditemukan menjadi lapisan ekonomi tersendiri, DataNet Registry bisa jadi lebih penting daripada dataset itu sendiri. Jika tidak, itu hanya registri lain yang tidak ada yang gunakan.
