Kemarin saya menjalankan sebuah model fine-tuning lokal dengan VRAM 16G. Awalnya sih baik-baik saja, tapi setelah 20 epoch langsung OOM dan crash. Saya cek monitoring, fragmentasi cache bikin VRAM habis. Harus restart, repot deh selama satu jam.
Masalah ini bikin saya lebih memperhatikan manajemen KV Cache dari OpenLedger yang OpenLoRA. Mereka merancang mekanisme migrasi dinamis. Ketika cache di GPU tertentu mendekati batas, secara otomatis beberapa permintaan akan dipindahkan ke GPU lain, dan selama proses migrasi, status inferensi tetap terjaga tanpa perlu dihitung ulang.
Saya cek, mereka menggunakan Segmentasi Matriks-Gather untuk Perkalian Vektor, dalam bahasa sederhana, itu menyimpan vektor K dan V dari permintaan yang berbeda secara tersegmentasi. Saat dibutuhkan, ambil per blok, bukan memindahkan seluruh tabel sekaligus. Dengan cara ini, jumlah data yang dipindahkan jauh lebih kecil.
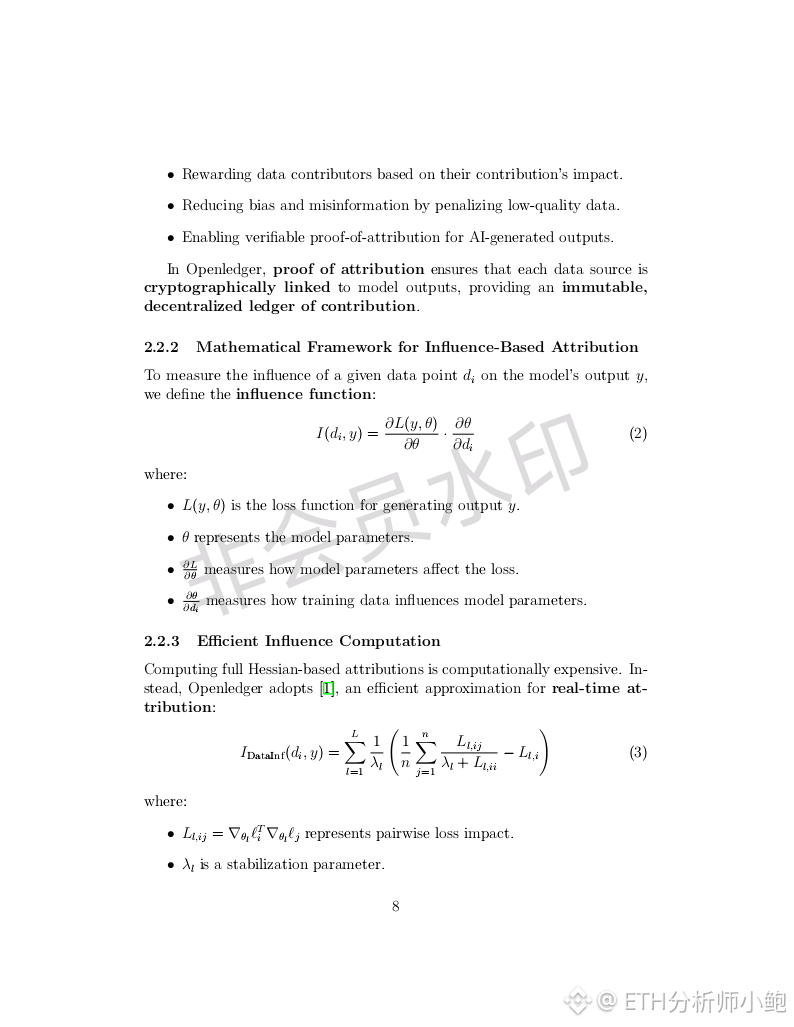
Di whitepaper, mereka memberikan sebuah formula. Permintaan baru R_new akan dialokasikan ke GPU yang memenuhi batas ukuran batch dan persyaratan memori, memilih yang paling optimal. Ini lebih pintar dibandingkan alokasi acak atau round-robin. Round-robin mudah membuat satu GPU overload sementara yang lain kosong $OPEN .
Saya sendiri pernah mengalami masalah serupa. Yang paling menyebalkan saat menjalankan layanan inferensi bukan kekuatan komputasi yang kurang, tapi fragmentasi VRAM. GPU lain seharusnya punya ruang kosong, tapi karena fragmentasi, tidak bisa masuk permintaan baru. Harus tambah mesin, bakar uang. OpenLoRA dengan penyimpanan tersegmentasi dan migrasi dinamis ini, secara teori bisa memanfaatkan fragmentasi, menghemat GPU berarti menghemat uang.
Tapi saya juga harus bilang, logika migrasi bekerja baik di makalah, belum tentu di lingkungan produksi. Migrasi yang sering bisa menambah latensi tambahan, dan scheduler itu sendiri bisa jadi bottleneck di bawah beban tinggi. Ruang blok Bitcoin terbatas, biaya gas Ethereum melonjak saat beban tinggi, semua itu karena masalah penjadwalan yang belum teratasi. Apakah OpenLoRA ini bisa bertahan dengan traffic nyata, kita harus tunggu beberapa bulan lagi untuk melihat update lanjutan dari whitepaper mereka.
Saya akan memantau panel monitoring mainnet mereka. Jika latensi migrasi dapat dikendalikan di bawah 5 milidetik, saya akan mencoba menjalankan beberapa model kecil di sana @OpenLedger #OpenLedger .
Masalah ini bikin saya lebih memperhatikan manajemen KV Cache dari OpenLedger yang OpenLoRA. Mereka merancang mekanisme migrasi dinamis. Ketika cache di GPU tertentu mendekati batas, secara otomatis beberapa permintaan akan dipindahkan ke GPU lain, dan selama proses migrasi, status inferensi tetap terjaga tanpa perlu dihitung ulang.
Saya cek, mereka menggunakan Segmentasi Matriks-Gather untuk Perkalian Vektor, dalam bahasa sederhana, itu menyimpan vektor K dan V dari permintaan yang berbeda secara tersegmentasi. Saat dibutuhkan, ambil per blok, bukan memindahkan seluruh tabel sekaligus. Dengan cara ini, jumlah data yang dipindahkan jauh lebih kecil.
Di whitepaper, mereka memberikan sebuah formula. Permintaan baru R_new akan dialokasikan ke GPU yang memenuhi batas ukuran batch dan persyaratan memori, memilih yang paling optimal. Ini lebih pintar dibandingkan alokasi acak atau round-robin. Round-robin mudah membuat satu GPU overload sementara yang lain kosong $OPEN .
Saya sendiri pernah mengalami masalah serupa. Yang paling menyebalkan saat menjalankan layanan inferensi bukan kekuatan komputasi yang kurang, tapi fragmentasi VRAM. GPU lain seharusnya punya ruang kosong, tapi karena fragmentasi, tidak bisa masuk permintaan baru. Harus tambah mesin, bakar uang. OpenLoRA dengan penyimpanan tersegmentasi dan migrasi dinamis ini, secara teori bisa memanfaatkan fragmentasi, menghemat GPU berarti menghemat uang.
Tapi saya juga harus bilang, logika migrasi bekerja baik di makalah, belum tentu di lingkungan produksi. Migrasi yang sering bisa menambah latensi tambahan, dan scheduler itu sendiri bisa jadi bottleneck di bawah beban tinggi. Ruang blok Bitcoin terbatas, biaya gas Ethereum melonjak saat beban tinggi, semua itu karena masalah penjadwalan yang belum teratasi. Apakah OpenLoRA ini bisa bertahan dengan traffic nyata, kita harus tunggu beberapa bulan lagi untuk melihat update lanjutan dari whitepaper mereka.
Saya akan memantau panel monitoring mainnet mereka. Jika latensi migrasi dapat dikendalikan di bawah 5 milidetik, saya akan mencoba menjalankan beberapa model kecil di sana @OpenLedger #OpenLedger .