Saudara-saudaraku, kali ini aku tidak melihat catatan kontribusi—aku fokus khusus pada log inferensi OpenLoRA dari @OpenLedger . Itu yang katanya bisa menjalankan ribuan model hanya dengan satu GPU. Aku tarik data permintaan selama seminggu, dan menemukan fenomena yang cukup menarik. Dalam satu GPU yang sama, ada lebih dari 300 model LoRA yang dipasang, tapi lebih dari 70% permintaan inferensi hanya terkonsentrasi ke lima model saja. Sisanya, lebih dari 300 model itu pada dasarnya tidak dilirik siapa pun. Kenapa? Karena meskipun OpenLoRA secara teknis bisa memuat banyak model sekaligus, aturan pembagian arus tetap mengikuti bobot node. Arus diprioritaskan untuk memberi makan model-model yang berada di bawah beberapa node yang menyetor $OPEN paling banyak. Seberapa pun bagus modelmu, kalau dipasang di bawah node kecil, permintaan pengguna benar-benar tidak akan sampai ke kamu.
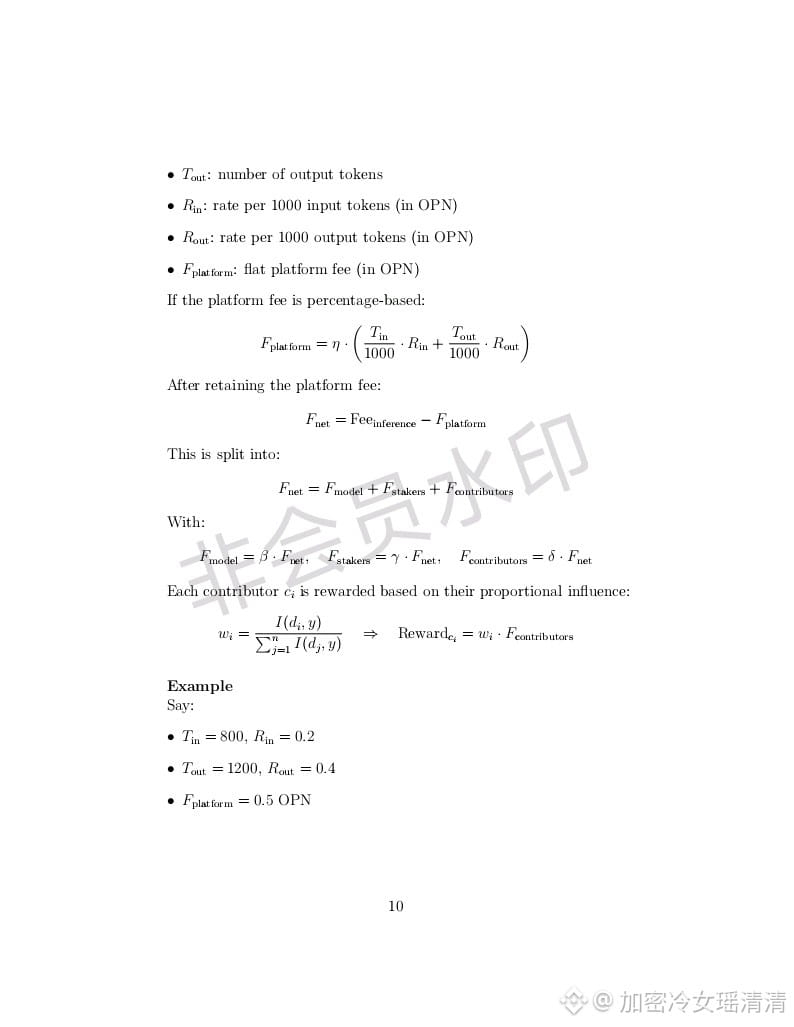
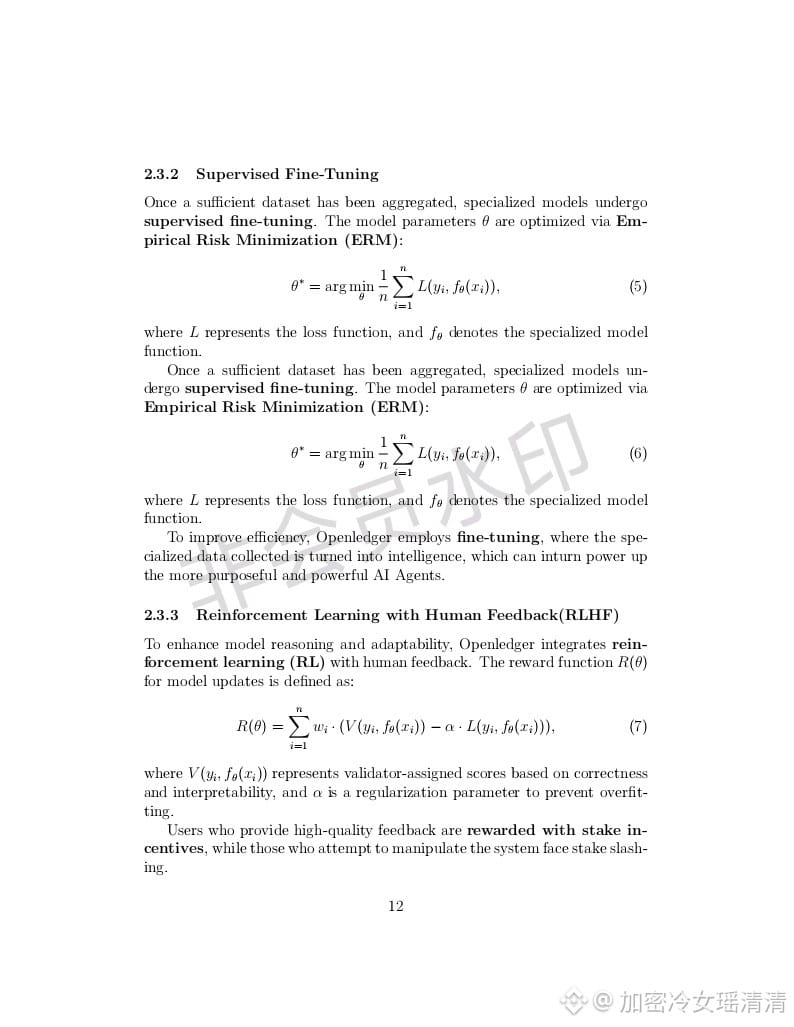
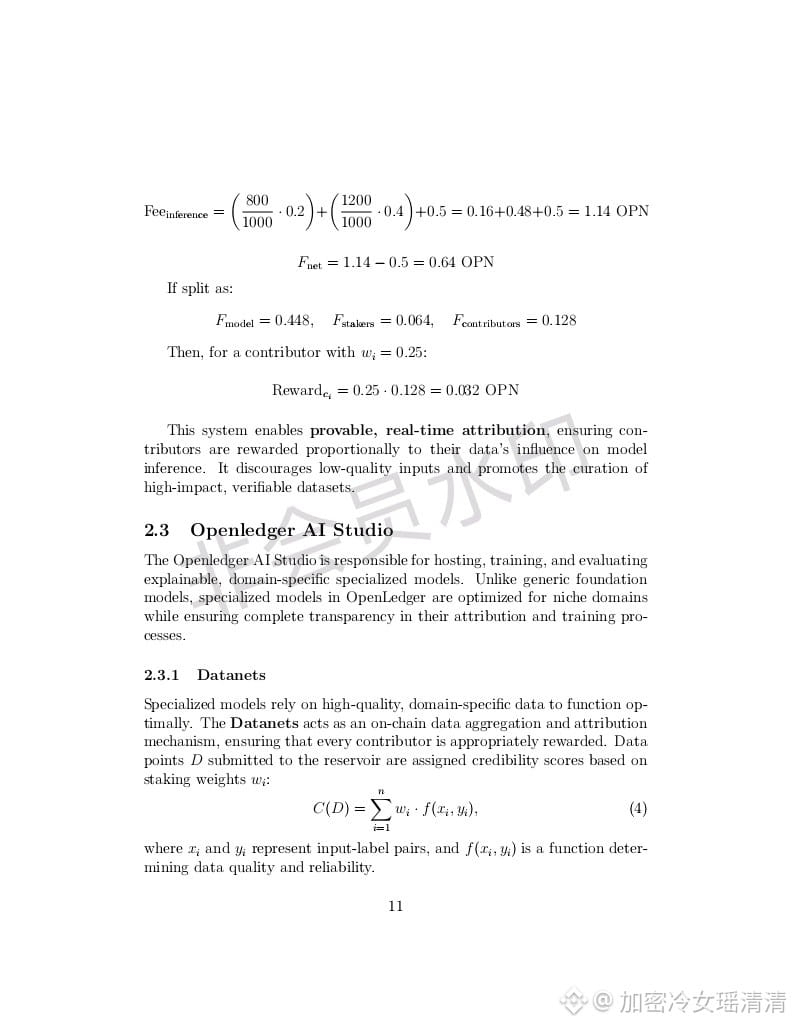
Arsitektur #OpenLedger memang punya keunggulan teknis—satu kartu bisa menjalankan ratusan model tanpa ambyar, dan pengendalian latensinya juga cukup baik. Tapi model ekonomi dari sistem ini mengirim semua manfaat teknologi itu kepada para pemegang modal besar. Model yang dipasang di bawah node kecil ibarat toko kecil yang tersembunyi di gang sempit; nomor alamatnya saja tidak terlihat. Yang lebih menyakitkan lagi: saat pengguna memanggil model, biaya inferensi yang mereka bayar—proporsi yang diberikan ke pihak model itu nilainya tetap. Tidak peduli kualitas modelmu tinggi atau tidak, selama dipanggil tetap dapat jatah proporsi yang sama. Akibatnya, tidak ada yang mau menghabiskan tenaga untuk mengoptimasi model-model niche, karena jumlah pemanggilannya terlalu kecil; walaupun pembagiannya tinggi, uang yang didapat cuma sedikit.
Sementara itu, model-model papan atas—meskipun kualitasnya biasa saja—karena lalu lintasnya besar justru menghasilkan keuntungan yang melimpah. Aku sengaja mengejar data dari sebuah model yang kurang dikenal. Model ini, di bidang yang lebih spesifik, akurasinya 15% lebih tinggi daripada model papan atas. Tapi selama seminggu model itu cuma dipanggil kurang dari 10 kali. Pembuat model menghabiskan waktu dan komputasi untuk fine-tuning, dan pada akhirnya yang ia dapatkan, $OPEN , bahkan belum cukup menutup biaya Gas yang harus ia bakar. Sedangkan pembuat model papan atas itu tidak melakukan apa-apa—karena cukup dipasang di bawah node para pemegang modal besar, tiap minggu tinggal “rebahan” dan uang masuk.
Pada dasarnya aturan ini bukan untuk memberi hadiah inovasi teknologi, melainkan memberi hadiah pada konsolidasi modal. Tim mungkin tidak tidak tahu masalah ini, tapi begitu aturan pembagian arus diubah agar mengikuti kualitas model, para pemegang modal besar itu pasti tidak akan mau. Jadi lihat saja perubahan bobot node—tinggal “klik” dan semua jalan. Kalau memang uang mau ditanam untuk pengembangan model, saudaraku, aku lebih rela nongkrong di big bet dan Ethereum untuk menunggu bull market.
Arsitektur #OpenLedger memang punya keunggulan teknis—satu kartu bisa menjalankan ratusan model tanpa ambyar, dan pengendalian latensinya juga cukup baik. Tapi model ekonomi dari sistem ini mengirim semua manfaat teknologi itu kepada para pemegang modal besar. Model yang dipasang di bawah node kecil ibarat toko kecil yang tersembunyi di gang sempit; nomor alamatnya saja tidak terlihat. Yang lebih menyakitkan lagi: saat pengguna memanggil model, biaya inferensi yang mereka bayar—proporsi yang diberikan ke pihak model itu nilainya tetap. Tidak peduli kualitas modelmu tinggi atau tidak, selama dipanggil tetap dapat jatah proporsi yang sama. Akibatnya, tidak ada yang mau menghabiskan tenaga untuk mengoptimasi model-model niche, karena jumlah pemanggilannya terlalu kecil; walaupun pembagiannya tinggi, uang yang didapat cuma sedikit.
Sementara itu, model-model papan atas—meskipun kualitasnya biasa saja—karena lalu lintasnya besar justru menghasilkan keuntungan yang melimpah. Aku sengaja mengejar data dari sebuah model yang kurang dikenal. Model ini, di bidang yang lebih spesifik, akurasinya 15% lebih tinggi daripada model papan atas. Tapi selama seminggu model itu cuma dipanggil kurang dari 10 kali. Pembuat model menghabiskan waktu dan komputasi untuk fine-tuning, dan pada akhirnya yang ia dapatkan, $OPEN , bahkan belum cukup menutup biaya Gas yang harus ia bakar. Sedangkan pembuat model papan atas itu tidak melakukan apa-apa—karena cukup dipasang di bawah node para pemegang modal besar, tiap minggu tinggal “rebahan” dan uang masuk.
Pada dasarnya aturan ini bukan untuk memberi hadiah inovasi teknologi, melainkan memberi hadiah pada konsolidasi modal. Tim mungkin tidak tidak tahu masalah ini, tapi begitu aturan pembagian arus diubah agar mengikuti kualitas model, para pemegang modal besar itu pasti tidak akan mau. Jadi lihat saja perubahan bobot node—tinggal “klik” dan semua jalan. Kalau memang uang mau ditanam untuk pengembangan model, saudaraku, aku lebih rela nongkrong di big bet dan Ethereum untuk menunggu bull market.