

Yang bikin perhatian saya terus tertarik ke OpenLedger bukanlah kualitas modelnya. Tapi, pertanyaannya adalah dimana sebenarnya gesekan alignment itu muncul setelah sebuah sistem bergerak melewati pelatihan satu model dan mulai mengkoordinasikan kontributor, validator, dataset, dan loop umpan balik secara besar-besaran.
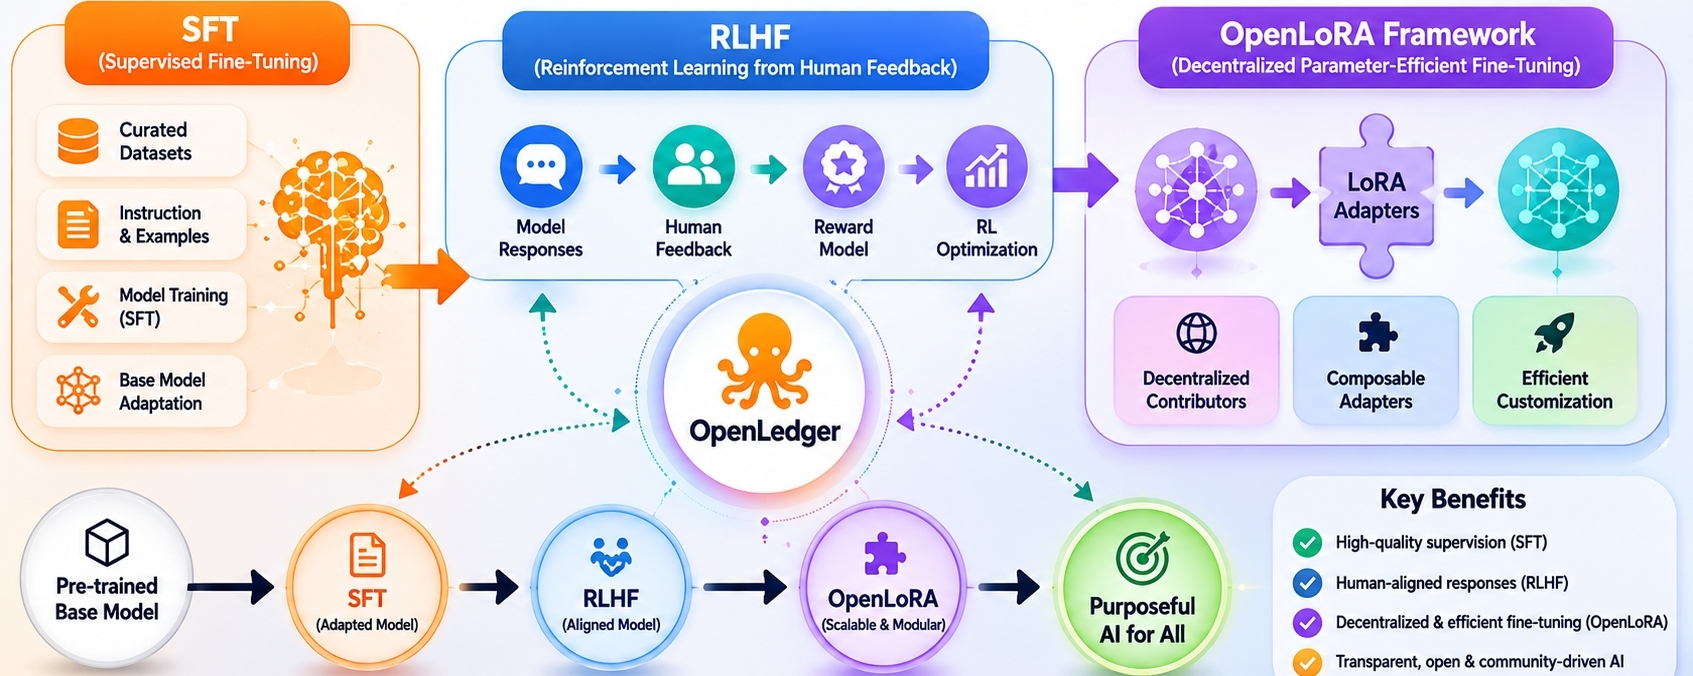
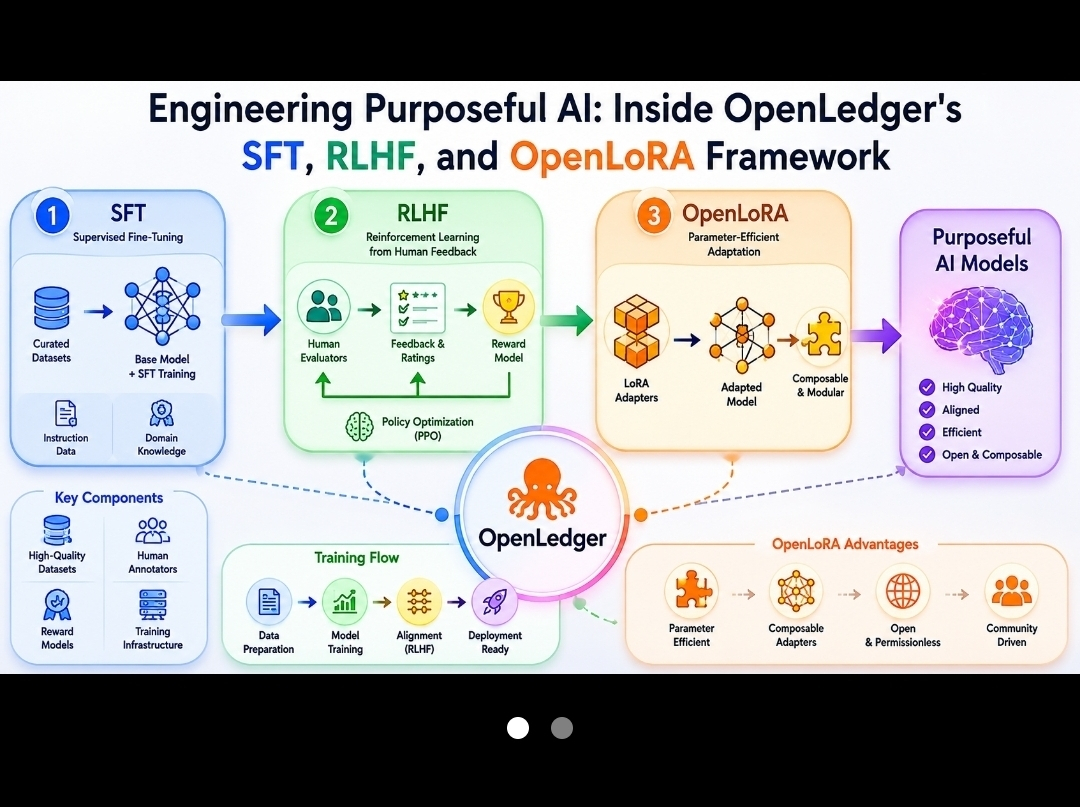
Di dalam OpenLedger, masalah menariknya bukan apakah SFT, RLHF, atau OpenLoRA bekerja secara individu. Kebanyakan orang sudah menerima bahwa mereka memang bekerja. Pertanyaan yang lebih sulit adalah apa yang terjadi ketika mekanisme ini menjadi bagian dari lingkungan produksi bersama di mana banyak aktor terus-menerus membentuk perilaku model.
Di situlah ketegangan operasional dimulai.
Sebuah model bisa terlihat andal selama evaluasi dan tetap menjadi tidak stabil secara mengejutkan setelah jalur penyesuaian bertambah. Setiap dataset baru memperkenalkan preferensi. Setiap kontributor memperkenalkan asumsi. Setiap optimisasi dengan tenang mendorong model menuju versi kegunaan yang berbeda.
Tantangannya bukan menciptakan kecerdasan.
Tantangannya adalah mempertahankan niat saat kecerdasan sedang dimodifikasi.
Saya terus memperhatikan ini saat melihat bagaimana OpenLedger menggabungkan fine-tuning terawasi, pembelajaran penguatan dari umpan balik manusia, dan adaptasi modular melalui OpenLoRA. Di atas kertas, komponen ini tampak saling melengkapi. Dalam praktiknya, mereka menciptakan tekanan bersaing yang harus dikelola di suatu tempat.
Ambil SFT terlebih dahulu.
Kebanyakan orang menganggap fine-tuning terawasi sebagai tahap yang langsung. Contoh yang dikurasi masuk. Perilaku yang lebih baik keluar. Kenyataannya lebih berantakan. Setelah beberapa kontributor mulai menyediakan data pelatihan, masalah beralih dari kualitas ke konsistensi.
Bayangkan dua kontributor menyelesaikan tugas dukungan pelanggan yang sama. Satu memberi penghargaan pada kepadatan. Yang lain memberi penghargaan pada penjelasan yang mendetail.
Tidak ada dataset yang secara inheren salah.
Tapi ketika keduanya memasuki jalur pelatihan, model mulai belajar definisi sukses yang bertentangan.
Mode kegagalan itu halus. Output tetap secara teknis benar sambil menjadi tidak dapat diprediksi secara operasional.
Seorang pengguna mengajukan pertanyaan yang sama dua kali dan menerima gaya respons yang sangat berbeda.
Tidak ada yang tampak rusak.
Namun kepercayaan mulai terkikis.
Di sinilah penekanan OpenLedger pada atribusi menjadi lebih menarik daripada pelatihan itu sendiri. Jika pergeseran perilaku tertentu muncul setelah dataset spesifik diperkenalkan, melacak pengaruh menjadi mungkin alih-alih spekulatif.
Risiko yang dikurangi bukanlah halusinasi.
Ini adalah ketidakjelasan tentang dari mana penyimpangan perilaku berasal.
Itu terdengar kecil sampai debugging dimulai.
Tanpa atribusi, setiap respons model yang tidak terduga menjadi sebuah cerita detektif.
Dengan atribusi, penyelidikan menjadi lebih sempit dan lebih murah.
Namun, atribusi memperkenalkan biayanya sendiri. Kontributor menjadi peserta yang terlihat dalam perilaku model. Visibilitas menciptakan akuntabilitas, tetapi juga menciptakan keraguan. Beberapa kontributor menjadi lebih konservatif karena pengaruh mereka dapat diukur.
Tradeoff itu terasa nyata.
Traceability yang lebih baik sering berarti eksperimen yang lebih lambat.
Kemudian RLHF masuk ke dalam gambar dan segalanya menjadi semakin tidak bersih.
Umpan balik manusia biasanya disajikan sebagai lapisan penyesuaian. Tahap di mana model belajar apa yang sebenarnya disukai orang.
Saya tidak sepenuhnya yakin itu sesederhana itu.
Umpan balik manusia sering menangkap kepuasan langsung lebih efektif daripada kegunaan jangka panjang.
Perbedaan itu penting.
Pertimbangkan skenario di mana dua respons menjawab pertanyaan yang sama.
Kepercayaan menjadi jalan pintas.
Seiring waktu, tekanan optimisasi dapat mendorong model ke arah respons yang terasa lebih baik sebelum menjadi lebih jujur.
OpenLedger tidak dapat sepenuhnya menghilangkan ketegangan itu karena tidak ada kerangka kerja yang bisa. Apa yang bisa dilakukannya adalah mengekspos lebih banyak proses penyesuaian alih-alih menyembunyikannya di balik jalur sentralisasi.
Itu menciptakan tes yang menarik.
Jika dua kelompok umpan balik secara konsisten tidak setuju tentang output yang diinginkan, preferensi siapa yang harus mendominasi?
Tidak ada jawaban yang jelas.
Saya curiga banyak orang menganggap desentralisasi secara otomatis menyelesaikan masalah ini.
Saya tidak yakin itu dilakukan.
Itu hanya membuat ketidaksepakatan terlihat.
Dan visibilitas berbeda dari resolusi.
Satu contoh mekanis menggambarkan ini dengan jelas.
Misalkan sebuah model menerima 1.000 peristiwa umpan balik tentang tugas penalaran keuangan.
Tujuh ratus memberi penghargaan pada respons singkat.
Tiga ratus memberi penghargaan pada analisis risiko yang mendetail.
Jalur optimisasi bergantung sepenuhnya pada bagaimana sinyal tersebut diberi bobot.
Mekanisme teknis menjadi kurang penting daripada asumsi pemerintahan yang tersemat di dalamnya.
Akhirnya seseorang memutuskan apa yang dimaksud dengan "lebih baik".
Bahkan jika keputusan itu muncul secara kolektif.
Bagian yang paling menarik bagi saya adalah OpenLoRA karena di sinilah friksi penyesuaian menjadi nyata.
Fine-tuning tradisional sering berperilaku seperti mengganti bagian dari mesin saat sedang berjalan. Setiap modifikasi membawa kemungkinan konsekuensi yang tidak diinginkan di tempat lain.
OpenLoRA mengubah unit adaptasi.
Alih-alih terus-menerus memodifikasi model dasar yang besar, kontributor dapat membangun adaptasi khusus yang tetap lebih modular.
Itu terdengar seperti peningkatan murni sampai realitas operasional muncul.
Sistem modular mengurangi satu kategori kegagalan sambil menciptakan yang lain.
Sekarang tantangannya menjadi seleksi.
Adaptasi mana yang harus digunakan?
Versi mana yang harus diprioritaskan?
Friction tidak menghilang.
Ia bergerak.
Saya pikir gerakan itu adalah salah satu dinamika yang paling diabaikan dalam infrastruktur AI.
Sistem jarang menghilangkan kompleksitas.
Mereka memindahkannya.
OpenLoRA tampaknya memindahkan kompleksitas jauh dari pelatihan model dan menuju koordinasi model.
Itu sering merupakan trade yang baik.
Tapi itu tetap sebuah trade.
Bayangkan dua LoRA spesifik domain.
Satu berspesialisasi dalam penalaran hukum.
Yang lain berspesialisasi dalam dukungan pelanggan.
Secara individu keduanya berkinerja baik.
Alur kerja campuran tiba-tiba membutuhkan keputusan tentang pengalihan, prioritas, kompatibilitas, dan evaluasi.
Lapisan model menjadi lebih mudah diperbarui.
Lapisan koordinasi menjadi lebih sulit untuk dikelola.
Beban mana yang lebih ingin kamu bawa?
Saya benar-benar berpikir orang yang wajar bisa menjawab dengan cara yang berbeda.
Ini juga menjelaskan mengapa lapisan ekonomi OpenLedger akhirnya menjadi relevan.
Tidak segera.
Tidak sebagai spekulasi.
Sebagai infrastruktur.
Setelah atribusi, umpan balik, dan adaptasi menjadi aktivitas yang dapat diukur, insentif tidak dapat dihindari masuk ke dalam percakapan. Kontributor perlu alasan untuk mempertahankan dataset. Validator perlu alasan untuk mengevaluasi kualitas. Penyedia umpan balik perlu alasan untuk berpartisipasi dengan jujur.
Akhirnya peran token OPEN muncul hampir karena kebutuhan karena koordinasi tanpa insentif cenderung memburuk di bawah skala.
Pertanyaan menarik bukan apakah insentif ada.
Pertanyaan menarik adalah apakah insentif terus memberi penghargaan pada kegunaan setelah pertumbuhan tiba.
Sejarah menunjukkan bahwa di sinilah banyak sistem menghadapi kesulitan.
Apa yang membuat saya kembali ke OpenLedger bukanlah janji pengembangan AI terbuka. Banyak proyek menjanjikan keterbukaan.
Ini adalah kesediaan untuk mengungkapkan di mana biaya penyesuaian sebenarnya terakumulasi.
Tidak dalam arsitektur model.
Tidak dalam skor benchmark.
Di ruang berantakan antara kontributor yang mencoba membentuk kecerdasan yang sama menuju tujuan yang sedikit berbeda.
Mungkin ujian yang sebenarnya ternyata cukup sederhana.
Jika dua kontributor yang sama-sama terampil melatih sistem menuju definisi kualitas yang berbeda, dapatkah kerangka kerja mengungkapkan konflik itu sebelum pengguna mengalami konsekuensinya?
Dan jika bisa, apakah transparansi itu meningkatkan hasil atau hanya membuat ketidaksepakatan lebih mudah untuk diamati?
Saya tidak berpikir jawabannya sudah ditentukan.
Semakin saya melihat SFT, RLHF, dan OpenLoRA bersama-sama, semakin sedikit mereka terasa seperti teknik optimisasi dan semakin mereka terasa seperti mekanisme negosiasi.
Sebuah negosiasi antara dataset.
Sebuah negosiasi antara preferensi.
Sebuah negosiasi antara keterbukaan dan koherensi.
Sebagian besar sistem AI menyembunyikan negosiasi tersebut di balik antarmuka.
OpenLedger tampaknya bertekad untuk mengungkapnya.
Apakah itu pada akhirnya menghasilkan kecerdasan yang lebih baik atau hanya lebih banyak friksi yang terlihat masih merupakan sesuatu yang saya uji.
