
Saat merapikan beberapa log proyek lama di komputer sore ini, saya tidak bisa tidak berhenti sejenak untuk melihat beberapa halaman catatan debugging smart contract yang saya tulis sendiri dulu. Di dalamnya penuh dengan kurva konsumsi gas untuk berbagai edge case dan pemikiran tentang penyelidikan kegagalan sinkronisasi status, yang membuat saya tersenyum sendiri. Selama bertahun-tahun ini, saya telah memasukkan banyak pengalaman praktis dan data ke dalam berbagai alat untuk memvalidasi ide-ide saya, dan ternyata pengalaman dasar yang benar-benar berharga seringkali dengan mudah dipanen di platform terpusat, sementara kontributornya sendiri sulit mendapatkan imbalan yang layak. Perasaan ini membuat saya lebih berhati-hati terhadap proyek-proyek yang mengklaim akan merekonstruksi nilai data.
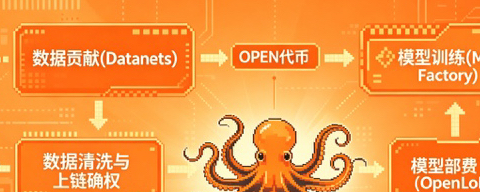
Dalam suasana pikiran seperti itu, belakangan ini si Kaze menaruh perhatian pada OpenLedger, sebuah proyek yang belakangan makin sering disebut di komunitas. Awalnya saya tidak berharap terlalu banyak, karena saya sudah pernah melihat terlalu banyak proposal yang menempel label AI, namun hanya mengurus lapisan permukaan. Namun setelah saya meluangkan beberapa hari untuk membaca dengan serius @OpenLedger kode protokol inti mereka, terutama modul jaringan data terdesentralisasi bernama Datanets, saya melihat bahwa mereka benar-benar mencoba jalur yang cukup pragmatis: menggunakan blockchain agar aliran nilai dari proses inferensi AI bisa benar-benar mendarat pada settlement yang bisa diverifikasi di chain.
Mereka mengusulkan mekanisme payable AI, yang intinya adalah melalui serangkaian identitas terenkripsi dan desain kontrak modular: setiap kali ada pemanggilan model, kontribusi data, atau penyediaan komputasi, semuanya bisa dilacak secara jelas dan mendapatkan kompensasi yang sesuai. Bayangkan seorang pengembang mengunggah modul ekstraksi fitur miliknya yang bersifat proprietary ke jaringan. Selanjutnya, jika ada tim kuantitatif yang memanggil modul tersebut untuk membantu penilaian pergerakan harga, protokol lapisan bawah akan membagi biaya secara otomatis dan mengalirkannya ke alamat-alamat terkait berdasarkan bobot kontribusi yang telah ditetapkan. Dari sisi konsep, desain ini terasa cukup bersih—upaya untuk mendelegasikan kembali model distribusi yang dulu sepenuhnya dimonopoli platform-platform besar, melalui pendekatan desentralisasi kepada pihak yang benar-benar memberi kontribusi.
Dari sudut pandang seorang engineer, #OpenLedger hal arsitektur yang paling saya sukai adalah ide pemecahan modularnya. Datanets menyusun lapisan data, lapisan model, dan lapisan settlement secara relatif independen, sehingga memudahkan iterasi dan upgrade parsial di kemudian hari, dan tidak membuat seluruh sistem lumpuh hanya karena satu komponen bermasalah. Saya sendiri menjalankan beberapa kali alur pemanggilan end-to-end di testnet berdasarkan dokumentasi. Tingkat kesulitan untuk mulai memang tidak rendah, tetapi logikanya masih cukup jelas. Bagi mereka yang punya pengalaman di solidity dan sistem terdistribusi, dalam satu-dua hari mereka bisa menyiapkan interaksi dasar. Setelah benar-benar dijalankan, performa latensi dan biaya ternyata juga lebih stabil daripada perkiraan saya. Tentu saja, ini baru pengujian skala kecil—untuk performa pada skenario konkuren tinggi yang benar-benar nyata, masih perlu observasi lebih lama.$OPEN
Tapi saya juga paham, semua upaya seperti ini pasti tak bisa lepas dari tantangan nyata di dunia rekayasa. Sangat bergantung pada mekanisme settlement real-time di blockchain, saat menghadapi tugas AI multimodal berskala besar dengan konkurensi tinggi, latensi jaringan dan tekanan sinkronisasi node akan cepat membesar. Saya pernah mengalami kerugian pada masa chain publik lain sedang berstatus beban tinggi—saat itu keterlambatan konfirmasi yang sering terjadi dan fluktuasi biaya yang tiba-tiba langsung mengacaukan banyak proses otomatis yang sebelumnya dirancang. Jika Datanets ke depannya tidak terus beriterasi pada ekspansi node dan optimasi sharding, risiko ini bisa membuat sebagian pengguna merasa bahwa layanan terdesentralisasi tidak seandal layanan terpusat tradisional.$BTC
Selain itu, saat ini tipe data yang beredar di jaringan mereka masih cukup terkonsentrasi: terutama berputar pada catatan terstruktur yang terkait keuangan dan sebagian kumpulan data pelatihan yang bersifat publik. Ini memang bisa membuat validasi awal lebih terarah, tetapi juga berarti masih ada jarak yang jelas untuk mendukung lintas industri dan benar-benar mendorong variasi aplikasi AI. Jika ekosistem developer ke depannya tidak mampu berkembang dengan cepat, dan terus menyuntikkan data segar berkualitas tinggi, siklus distribusi nilai keseluruhannya berisiko terjebak pada keadaan aktivitas rendah—akhirnya menjadi lingkaran yang hanya diisi oleh sejumlah node yang saling menghidupi.
Meski ada potensi masalah-masalah itu, saya tetap memberikan pengakuan yang hati-hati terhadap arah ini. Mengambil kembali kewenangan penetapan harga dari sisi supply AI dari tangan segelintir raksasa, dan menurunkan hambatan agar pengembang biasa bisa memonetisasi sumber daya unik mereka dengan teknologi blockchain—hal ini sendiri patut dicoba secara serius. Setidaknya ia menawarkan jalur kemungkinan baru bagi mereka yang memegang dataset khusus yang tidak umum atau model yang sudah dioptimasi.
Dalam beberapa bulan ke depan, saya berencana tetap memantau sebagai pengamat aktivitas aktual mereka di blockchain: volume panggilan sebenarnya dari smart contract, kurva pertumbuhan alamat pengunggahan data independen di jaringan Datanets, serta stabilitas settlement lintas modul. Data-data ini akan lebih jujur daripada dokumen whitepaper mana pun. Setelah masa observasi selesai, barulah saya memutuskan apakah akan menginvestasikan lebih banyak usaha berdasarkan performa nyata. Secara keseluruhan, saya cukup optimistis dan tetap terukur terhadap eksplorasi semacam ini yang mewujudkan niat teknisnya langsung di level kode—bukan karena terdengar se-revolusioner apa pun, melainkan karena ia tidak menghindari kompleksitas dunia nyata dalam detail rekayasanya.