

Oke, biar saya bilang satu hal di awal - ketika kamu lihat sistem-sistem kayak gini, kamu pasti mikir "semuanya terkendali, aturan ketat, pembatasan..." Tapi kalau kamu lihat lebih dalam, ternyata ini bukan benar-benar kekacauan, melainkan usaha untuk menciptakan struktur yang disengaja - itu benar.
Kalau saya jujur dari lubuk hati saya.... Cara saya baca @OpenLedger dokumentasi, dalam satu kalimat - ini bukan hanya AI atau platform data, tapi eksperimen seluruh ide tentang bagaimana data bisa jadi "aset yang menguntungkan". Sekarang mari kita kupas ini karena kalau kamu gabungkan semuanya, itu nggak akan muat di pikiranmu - sama sekali nggak akan muat.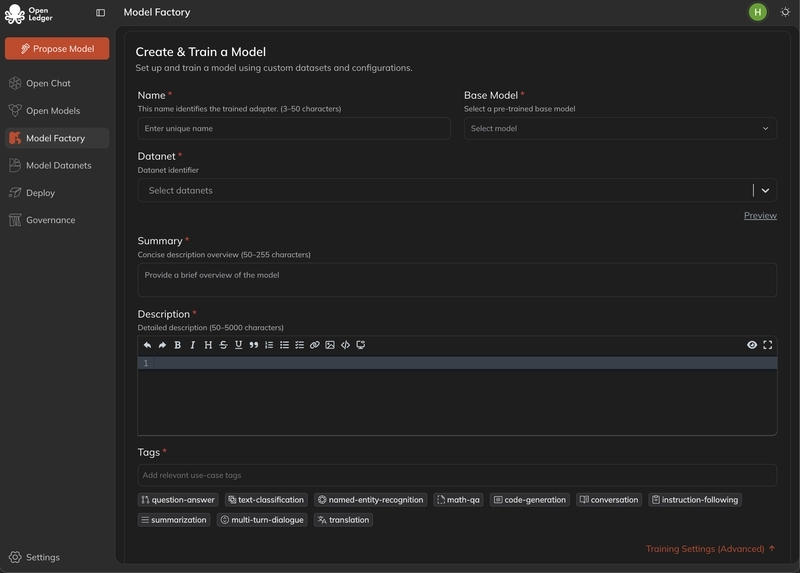
Pertama datang lapisan Kontribusi dari Datanets.
Hal yang paling menarik di sini adalah batasan-batasan. Teks, gambar, audio - kamu tidak bisa mencampur semuanya. Terlihat sedikit aneh, karena ketika kita berbicara tentang Web3, kita biasanya berpikir tentang segala sesuatu tanpa izin. Tetapi di sini kebalikannya - format ketat, validasi ketat. Batas 10 MB per hari, 20 file - ini juga terlihat kecil, tetapi sebenarnya bukan kontrol spam, melainkan upaya untuk menjaga rasio sinyal-kebisingan yang benar. Karena jika tidak terbatas, semua orang akan berkontribusi, tetapi akan sulit menemukan nilai.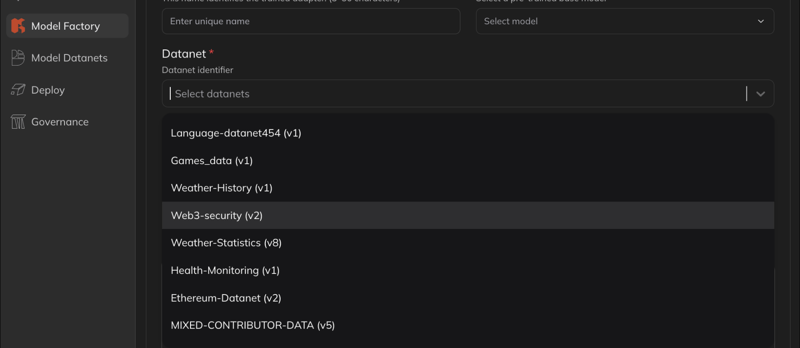
Hal lain yang terlihat sedikit lucu - sistem leaderboard.
Kamu mungkin berpikir "semakin banyak saya mengunggah, semakin tinggi saya" - tetapi tidak, sama sekali tidak. Di sini, bukan kuantitas yang penting, tetapi tingkat penerimaan. Maksud saya, jika kamu memberikan 10 data yang salah, egomu mungkin merasa senang, tetapi sistem tidak akan peduli padamu. Sedikit keras, tetapi adil. Dan bagian menariknya adalah bahwa file yang ditolak tidak mengurangi peringkat. Ini adalah desain yang anehnya sehat. Karena eksperimen didorong di sini, bukan kontribusi yang didorong oleh ketakutan.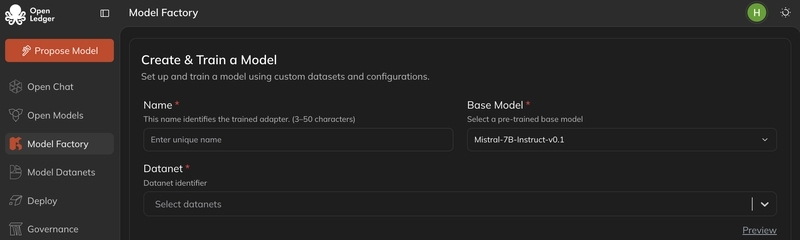
Nah, di sini datang mekanika dari ModelFactory.
Ini sebenarnya adalah bagian yang paling serius dari OpenLedger. Ini mengubah suasana di sini sepenuhnya. Mereka mencoba mengubah fine-tuning LLM menjadi alur kerja yang dipandu oleh antarmuka alih-alih hanya menjadikannya sebagai alat penelitian. Ini berarti kamu tidak perlu menjadi pejuang terminal. Tingkat pembelajaran, ukuran batch, epoch - semuanya dapat disesuaikan secara visual. Sekilas, terlihat - ok, ramah untuk pemula, tetapi sebenarnya ada ide yang lebih dalam di balik ini - mendemokratisasi pengembangan AI tanpa kehilangan kendali.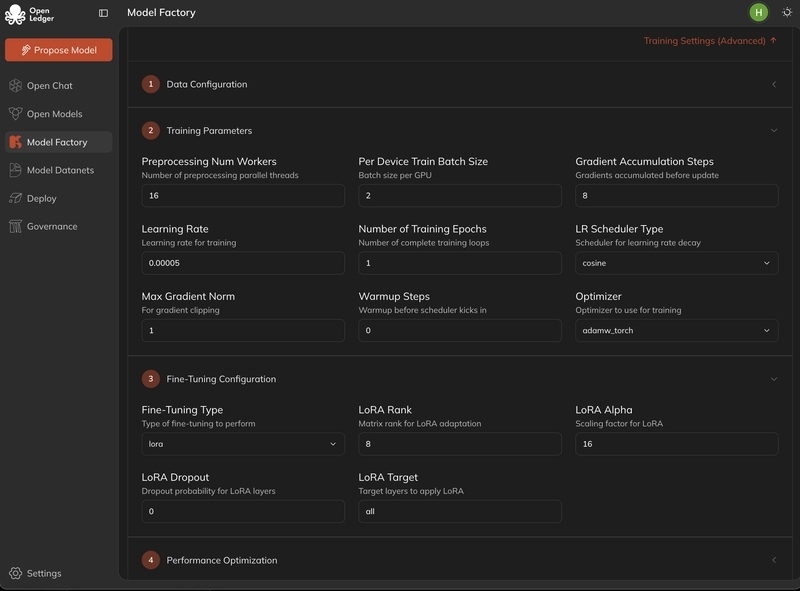
Dukungan untuk LoRA dan QLoRA adalah langkah praktis di sini. Karena fine-tuning penuh itu mahal dalam kenyataan saat ini. Jadi mereka mengikuti jalur adaptasi ringan. Panel waktu nyata dan interaksi pasca-pelatihan - ini cukup menarik, karena mereka ingin membuat pelatihan model menjadi loop terus-menerus tanpa titik akhir. Ini berarti pelatihan ⇨ pengujian ⇨ interaksi ⇨ penyempurnaan.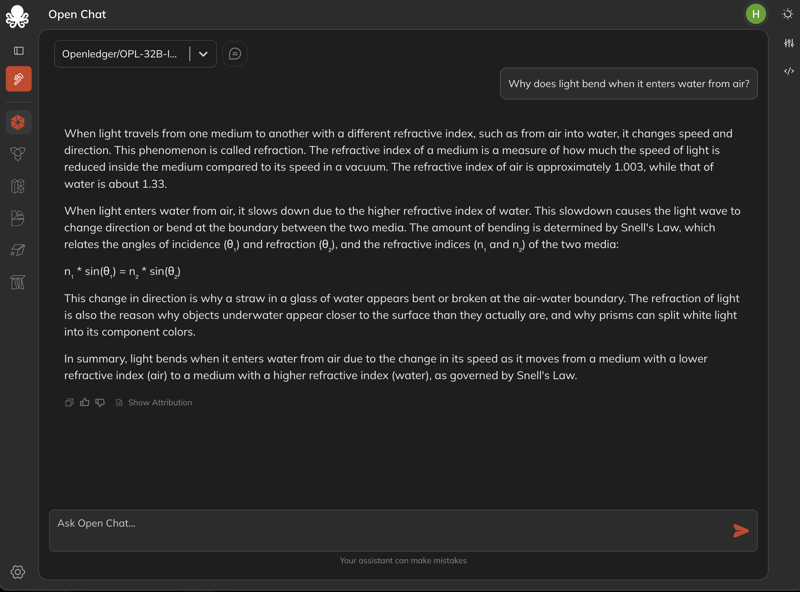
Sekarang mari kita bicarakan tentang LLM yang didukung.
Deepseek, Mistral, Qwen, seri LLaMA - semua ekosistem besar terbuka ada di sini. Bahkan GPT-2, BLOOM, ChatGLM didukung. Pada awalnya, mungkin terlihat bahwa mereka menyertakan semuanya, tetapi sebenarnya ini adalah strategi penutup ekosistem. Karena jika kamu hanya mempertahankan model elit, kamu akan terbatas. Tetapi dukungan yang luas berarti ruang besar untuk eksperimen.
Sekarang biarkan saya memberitahu kamu bagian yang lucu
Sebuah gambar muncul di benak saya ketika melihat seluruh sistem ini - dapur yang sangat disiplin, di mana tidak ada yang bisa melempar bahan secara sembarangan. Tetapi ketika memasak selesai, semua orang bisa mencicipi dan menilai. Ini berarti bahwa kamu tidak bisa bertahan di sini hanya dengan getaran positif, meskipun kamu ingin.
Bagian terakhir dari Instruksi Agen adalah, sebenarnya, yang paling diremehkan.
Karena di sini dikatakan bahwa, untuk permintaan mendalam, jawaban dinamis dapat diperoleh menggunakan URL GitBook. Ini bukan sekadar dokumen statis, tetapi sistem pengetahuan yang dapat dicari.
Sekarang, jika kamu memikirkan ini secara umum, satu hal menjadi jelas..... @OpenLedger kebenaran berada di antara dua ketegangan: di satu sisi, desentralisasi + kontribusi terbuka, di sisi lain, validasi ketat + struktur terkontrol. Tidak mudah untuk mempertahankan kedua hal ini bersama-sama. Tetapi jika keseimbangan tepat, maka bisa menciptakan ekonomi data yang nyata alih-alih kebisingan. Dan, jujur saja, di sinilah pertanyaannya menjadi menarik - apakah data benar-benar akan menjadi aset masa depan, atau kita hanya mencoba menyelesaikan masalah validasi lama dengan nama baru?
Saya tidak yakin apakah ada jawaban akhir sekarang. Tetapi sebagai lapisan eksperimen, tidak ada salahnya untuk diabaikan... Tapi sungguh🚀