
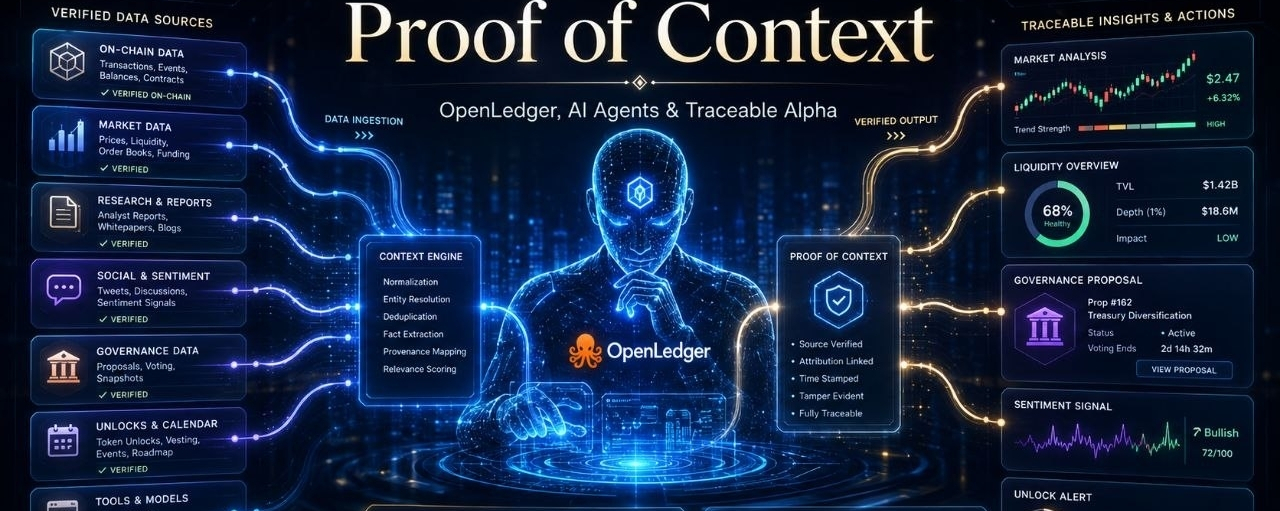
Satu hal yang saya pelajari dari trading crypto adalah bahwa kecerdasan mentah saja tidak cukup. Kecepatan itu penting, tentu saja. Model yang lebih baik juga penting. Tapi konteks adalah yang biasanya memisahkan panggilan yang cukup baik dari trade yang hancur. Sebuah model bisa bilang "token ini terlihat kuat," tapi jika melewatkan unlock, voting pemerintahan, likuiditas yang tipis, data yang buruk, atau perubahan sentimen yang tiba-tiba, sinyal "kuat" itu bisa berubah jadi exit liquidity dengan cepat 😅
Makanya, arah agen AI OpenLedger menarik bagi saya.@OpenLedger menggambarkan dirinya sebagai infrastruktur AI-blockchain untuk melatih dan menerapkan model khusus dengan dataset yang dimiliki komunitas yang disebut Datanets, sementara aksi seperti unggahan dataset, pelatihan model, penghargaan, dan pemerintahan terjadi di on-chain. Itu penting karena agen AI butuh lebih dari sekadar prompt. Mereka butuh konteks yang terpercaya, data yang dapat dilacak, dan alasan bagi orang-orang untuk terus meningkatkan lapisan pengetahuan di belakang mereka.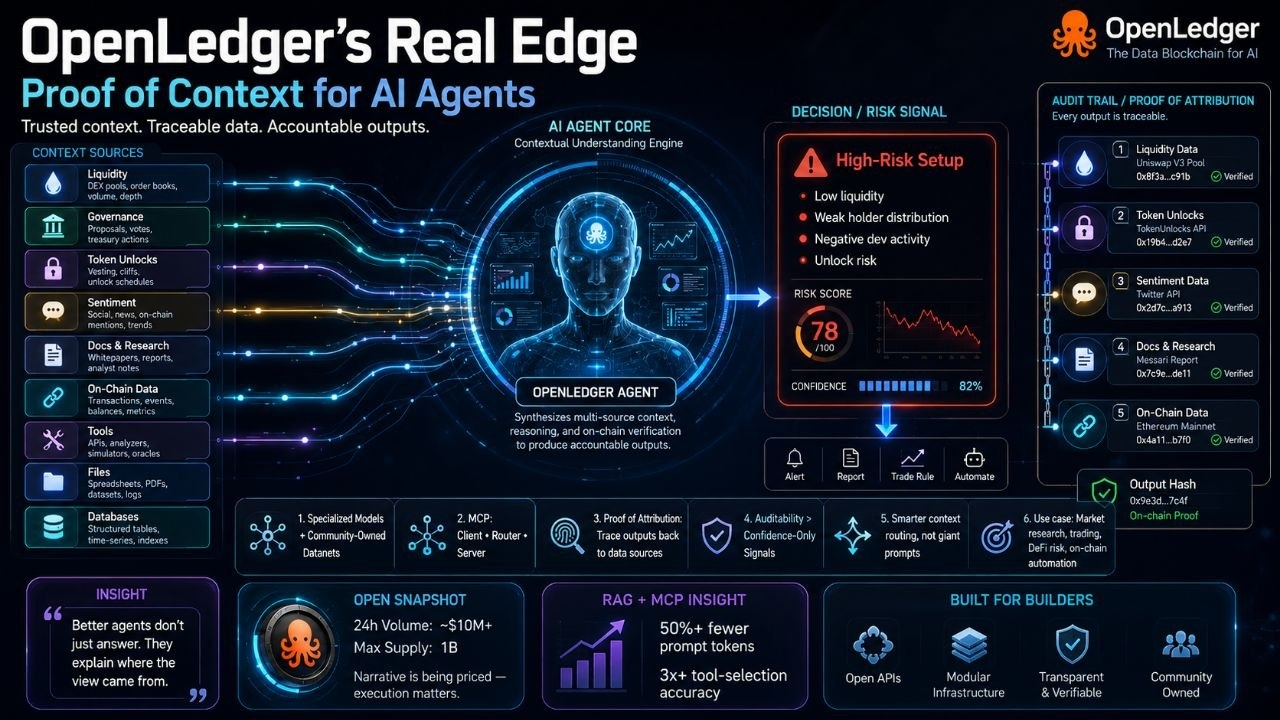
Topik yang sedang saya perhatikan sekarang adalah sudut Model Context Protocol milik OpenLedger. Dalam materi yang berfokus pada agen, OpenLedger menjelaskan MCP sebagai sebuah struktur untuk memberi model akses ke state eksternal, alat, file, database, dan respons yang bisa dieksekusi. Ia menggunakan alur client, server, dan router agar model bisa menerima konteks serta berinteraksi dengan alat dengan cara yang lebih terorganisir.
Bagi para pembangun, itu bukan sekadar infrastruktur yang serba teknis. Itu perbedaan antara chatbot dan agen yang benar-benar berguna.
Bayangkan membangun agen riset pasar di OpenLedger. Bot dasar mungkin merangkum berita token. Bot yang lebih baik mungkin mengambil data likuiditas, membandingkannya dengan momentum sosial, menelusuri dokumen, mengecek proposal tata kelola, dan menandai risiko unlock. Tapi alpha yang sebenarnya muncul ketika agen bisa menjelaskan dari mana pandangannya berasal dan sumber data mana yang membentuk output tersebut. Di sinilah Proof of Attribution dari OpenLedger menjadi kuat. OpenLedger memposisikan Proof of Attribution sebagai cara untuk menelusuri output AI kembali ke sumber data dan kontributor—artinya, kontributor bisa diberi kredit dan imbalan, bukan menghilang ke dalam pipeline pelatihan black-box.
Logika trading saya di sini sederhana: saya tidak ingin agen AI yang hanya memberi saya rasa percaya diri. Saya ingin satu yang memberi saya auditabilitas. Jika sebuah agen berkata, “setup berisiko tinggi,” saya ingin tahu apakah itu berasal dari likuiditas yang rendah, distribusi pemegang yang lemah, aktivitas dev yang negatif, atau pola sebelumnya dalam Datanets yang dikontribusikan. Kepercayaan tanpa jejak hanyalah “feeling.” Kepercayaan yang bisa ditelusuri adalah sebuah alat.
Ada juga poin skalabilitas. Riset terbaru RAG-MCP menemukan bahwa pemilihan alat berbasis retrieval dapat memangkas token prompt lebih dari 50% dan meningkatkan akurasi pemilihan alat lebih dari tiga kali dalam pengujian benchmark, yang mendukung gagasan yang lebih luas bahwa agen membutuhkan routing konteks yang lebih cerdas, bukan prompt raksasa yang terlalu dibebani. Tumpukan agen OpenLedger mengarah ke sana: dataset khusus, model khusus, context routing, dan mekanisme atribusi semuanya bekerja bersama.
Dan dari sisi pasar, OPEN sudah cukup likuid untuk dipantau dengan serius—CoinGecko menunjukkan volume 24 jam sekitar $10M+ dan pasokan maksimum 1B pada saat pengecekan. Itu tidak berarti “beli.” Artinya pasar sedang secara aktif membanderol narasinya, jadi para builder dan trader seharusnya mengevaluasi eksekusi, bukan sekadar hype.
Gambaran besarnya? OpenLedger dapat membuat agen AI terasa lebih seperti operator pasar yang bertanggung jawab, bukan mesin prediksi yang misterius. Untuk trading, riset, risiko DeFi, dan otomasi on-chain, itu adalah perubahan yang besar. Di kripto, semua orang menyukai alpha. Tapi gelombang berikutnya mungkin tentang membuktikan dari mana alpha itu berasal. $OPEN #OpenLedger