
OpenLedger dan Perasaan Aneh Bahwa AI Mungkin Akhirnya Menghadapi Dinding yang Sama.
Saya sudah cukup lama berkecimpung di crypto untuk berhenti bereaksi setiap kali sebuah proyek mengklaim bahwa mereka 'mendefinisikan ulang' sesuatu.
Sebagian besar waktu, kata-kata itu hanya kemasan yang didaur ulang di sekitar insentif yang sama. Token baru, branding baru, kenyataan yang sama di bawahnya: beberapa orang dalam menangkap nilai, kerumunan menyediakan likuiditas, dan akhirnya narasi berpindah ke tempat lain.
Itu mungkin kenapa saya jadi lebih lambat untuk merasa excited tentang apa pun yang berhubungan dengan AI belakangan ini. Ruang ini sudah terasa sesak dengan janji-janji yang berlebihan. Setiap minggu ada protokol baru yang mengklaim akan mendesentralisasi kecerdasan, tokenisasi agen, merevolusi komputasi, atau bahkan menggantikan internet itu sendiri. Setelah beberapa waktu, semua itu jadi terdengar seperti kebisingan latar belakang yang sama.
Tapi kadang-kadang ada sesuatu yang menarik perhatianku—bukan karena aku tiba-tiba percaya padanya, melainkan karena ia tampak berfokus pada masalah yang memang benar-benar ada.
OpenLedger adalah salah satu proyek seperti itu bagiku.
Aku tidak bilang ini bekerja. Aku tidak bilang ini menang. Aku bahkan tidak bilang modelnya berkelanjutan. Jujur saja, aku belum tahu.
Tapi aku terus memperhatikan bahwa pertanyaan mendasar yang diajukan terasa lebih nyata daripada kebanyakan narasi AI yang beredar di kripto saat ini.
Pertanyaannya sederhana: jika model AI menjadi beberapa sistem paling bernilai di dunia, mengapa hampir tidak ada yang tahu dari mana nilai itu benar-benar berasal lagi?
Kedengarannya jelas pada awalnya, tapi semakin dalam kau memikirkannya, semakin aneh seluruh ekonomi AI itu terlihat.
Kebanyakan sistem AI saat ini dibangun di atas lautan data yang dikumpulkan dari orang-orang yang biasanya tidak pernah melihat kompensasi, kepemilikan, atau bahkan pengakuan. Penulis, seniman, peneliti, pengguna forum, pengembang, komunitas khusus, arsip internet acak—semuanya diserap ke dalam model yang pada akhirnya menjadi produk bernilai miliaran.
Dan entah bagaimana semua orang saja menerima bahwa ini adalah hal yang normal.
Mungkin karena sistemnya sudah terlalu besar untuk dipertanyakan. Mungkin karena perusahaan yang membangunnya melaju lebih cepat daripada regulasi. Mungkin karena tak ada yang bisa melacak atribusi secara realistis begitu model mencapai skala tertentu.
Bagian terakhir itu penting.
Selama bertahun-tahun, salah satu masalah terbesar dalam AI adalah atribusi itu sendiri. Setelah sebuah model dilatih pada cukup banyak data, penelusuran pengaruh menjadi kabur. Semuanya berubah menjadi kotak hitam. Kadang kotak hitam yang berguna, tapi tetap saja kotak hitam.
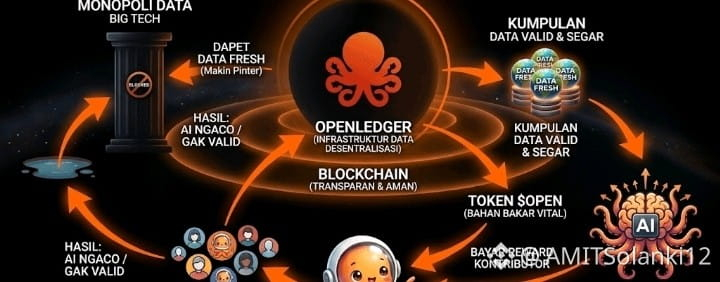
Itu bagian yang terus dilingkari OpenLedger dengan gagasan Proof of Attribution.
Konsepnya terdengar hampir terlalu ambisius ketika pertama kali membacanya. Protokol ini mencoba menghubungkan keluaran model kembali ke data yang memengaruhinya, lalu memberi imbalan kepada para kontributor secara proporsional melalui jaringan.
Aku pernah melihat kripto mencoba hal-hal serupa sebelumnya dalam bentuk yang berbeda. Royalti musik. Ekonomi kreator. Insentif penyimpanan. Pasar perhatian. Marketplace data.
Sebagian besar akhirnya menabrak dinding yang sama: mengukur kontribusi dengan cara yang benar-benar bermakna itu sangat sulit.#OpenAIToConfidentiallyFileForIPO $OPEN
#