1. Data Baru Ibarat Minyak Bumi, Tapi Siapa yang Memasukkan Uang ke Saku?
Tahukah Anda bahwa model-model AI raksasa seperti ChatGPT atau Midjourney sedang “gratis” mengumpulkan data dari postingan, gambar, dan kecerdasan yang Anda miliki setiap hari? AI sedang melakukan pemusatan data secara ekstrem. Para raksasa teknologi meraup keuntungan miliaran dolar, sementara orang-orang yang secara langsung menciptakan data—“baterai” yang memberi makan AI—tidak mendapatkan sepeser pun.
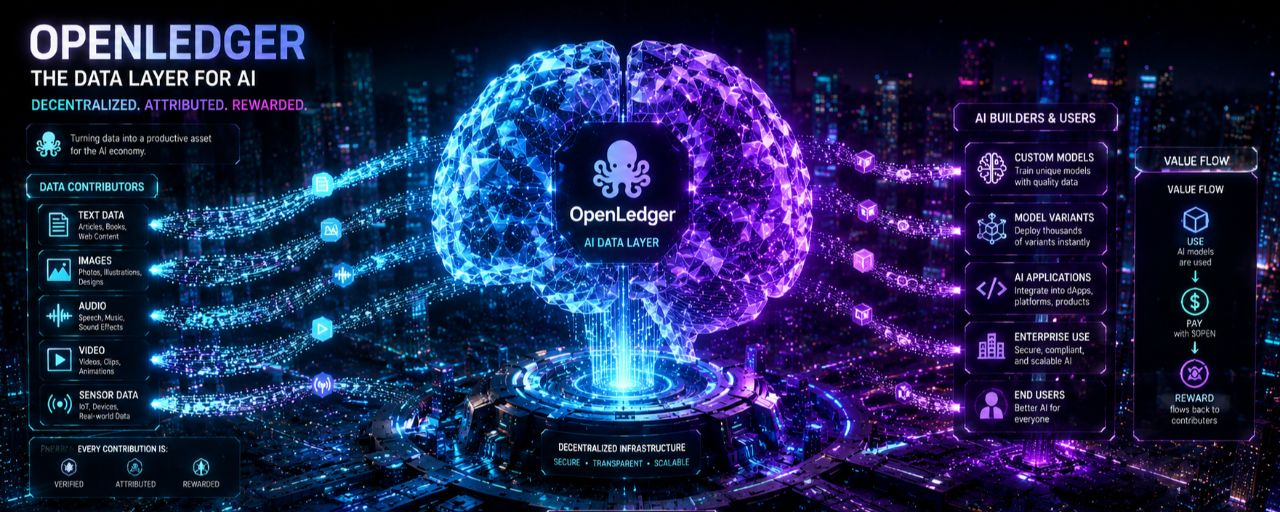
Mengapa data baru adalah minyaknya AI, tetapi kepemilikannya hanya dimiliki oleh segelintir orang? @OpenLedger muncul untuk membalikkan keadaan ini. Tidak berhenti pada janji-janji kosong, proyek ini menghadirkan infrastruktur on-chain yang optimal untuk mengubah permainan data melalui mekanisme penetapan kontribusi (Attribution).
Mari kita bedah arsitektur dan Tokenomics untuk melihat apakah ini benar-benar "bagian puzzle paling unggul" dari narrative AI x Web3 atau tidak.
2. Apa itu OpenLedger? Mendefinisikan Ulang Infrastruktur Data untuk AI
Untuk memahaminya secara sederhana, OpenLedger bukan sekadar token AI yang mengikuti tren hype, melainkan sebuah infrastruktur dasar (Infrastructure Layer) berbentuk Layer 2 yang kompatibel dengan EVM, dibangun khusus untuk penyimpanan, kontribusi, dan komersialisasi data AI secara terdesentralisasi.
┌────────────────────────────────────────────────────────┐ │ Ekonomi AI Terdesentralisasi │ ├────────────────────────────────────────────────────────┤ │ Lapisan Data │ Pabrik Model (OpenLoRA) │ Penjaminan Agen (Agent Staking)│ ├────────────────────────────────────────────────────────┤ │ Rantai OpenLedger (Infrastruktur EVM L2) │ └────────────────────────────────────────────────────────┘
Dalam lanskap Narrative AI x Web3, jika proyek seperti io.net atau Aethir fokus pada lapisan Compute (menyediakan daya komputasi/GPU), maka OpenLedger sepenuhnya fokus pada lapisan Data & Intelligence (Data dan Kecerdasan). Proyek ini menciptakan jaringan blockchain di mana aliran data, pelatihan model (Model Training), dan pengoperasian AI Agent otonom semuanya dijalankan on-chain secara transparan.
Ekosistem ini mengubah aset data yang sebelumnya "statis" dan terisolasi menjadi aset berlikuiditas tinggi (Liquid Assets) melalui Datanets (Jaringan kolaborasi data on-chain). Di sini, komunitas bisa bersama-sama berkontribusi, menyempurnakan, dan mengelola kumpulan data spesifik untuk melayani pelatihan AI.
3. Rasa Sakit AI Saat Ini: Dominasi Monopoli dan Kotak Hitam Opaque
Industri AI tradisional (Centralized AI) sedang mendekati batas berbahaya akibat struktur yang tersentralisasi:
Monopoli dari para Centralized AI Giants: Perusahaan besar mengendalikan seluruh infrastruktur komputasi (Compute Monopoly) dan memonopoli kumpulan data besar. Startup yang lebih kecil hampir tidak punya kesempatan untuk mengakses sumber data berkualitas tinggi ini.
Kotak Hitam AI (Opaque Training Process): Proses pelatihan model sepenuhnya adalah sebuah "kotak hitam". Pengguna tidak mungkin mengetahui apakah model tersebut dilatih menggunakan sumber data apa, apakah ada bias, atau apakah melanggar privasi (Privacy Violation).
Eksploitasi data (Data Exploitation): Para kreator konten, dokter, insinyur, maupun pengguna umum terus-menerus membagikan pengetahuan ke internet. Namun, Model AI mengumpulkannya secara gratis. Hak kepemilikan data (Data Ownership) dirampas secara terang-terangan.
Ketika data menipis dan tuntutan hukum terkait hak cipta terus meledak, AI wajib membutuhkan solusi yang terdesentralisasi. Itulah alasan Web3 hadir untuk memperbaiki AI.
4. Cara OpenLedger Menyelesaikan Masalah Data dari Akar
OpenLedger memutus struktur "kotak hitam" AI tradisional melalui 4 pilar teknologi inti:
4.1. Mekanisme Pembuktian Kontribusi (Proof of Attribution)
Ini adalah senjata paling ampuh dari OpenLedger. Ketika sebuah AI Model dipanggil untuk menjalankan suatu tugas (Inference), sistem memiliki kemampuan untuk menelusuri kembali dengan tepat model mana yang dilatih berdasarkan kumpulan data apa dan siapa yang telah berkontribusi pada kumpulan data tersebut. Transparansi ini memastikan bahwa imbalan ekonomi akan otomatis terdistribusi ke dompet kontributor asli secara real time.
4.2. Arsitektur Modular dan Framework Teknis OpenLoRA
Alih-alih berusaha menjalankan model AI yang berat, OpenLedger mendukung framework OpenLoRA (Low-Rank Adaptation). Teknologi ini memungkinkan ribuan model AI kecil yang sudah dioptimalkan dan disesuaikan secara spesifik, berjalan bersamaan pada satu GPU yang sama. Ini meminimalkan biaya perangkat keras secara maksimal dan meningkatkan fleksibilitas (Composability) yang jauh lebih unggul.
4.3. Ekonomi Data Terbuka melalui Datanets
Siapa pun bisa membuat atau bergabung ke dalam Datanet. Contoh: sekelompok dokter dapat membuat Datanet tentang rekam medis yang aman, mengenkripsinya, lalu menggunakannya untuk melatih AI khusus bidang kedokteran. Semua perilaku kecurangan data atau data sampah akan dihapus oleh lapisan Validator jaringan.
4.4. Transparansi yang Sangat Transparan (On-chain Transparency)
Setiap siklus hidup AI mulai dari pengajuan model, memuat data, melakukan voting hingga pembayaran biaya inferensi semuanya dicatat on-chain. Ini menciptakan sistem pengurangan kepercayaan (Trust Minimization), di mana perusahaan besar bisa menggunakan AI tanpa takut data bocor atau terseret masalah hukum.
5. Tokenomics Analisis Mendalam: Peran dan Penggerak Nilai Token $OPEN
Token adalah nadi ekonomi inti, yang menjalankan dan menjaga desentralisasi seluruh jaringan OpenLedger.
📊 Parameter Dasar (Key Metrics)
Ticker: OPEN
Total supply (Total Supply): 1.000.000.000 OPEN (1 Miliar token)
Jaringan: Layer 2 kompatibel EVM (dengan Bridge untuk terhubung ke Ethereum L1)
🪙 Alokasi Token (Token Allocation)
Persentase alokasi OpenLedger menunjukkan jelas prioritas untuk komunitas dan keberlanjutan jangka panjang:
Rincian Persentase Peran Utama Community (Komunitas) 51,71% Imbalan untuk Data Contributors, Validator, dan berbagai kampanye Incentives. Investors (Investor) 18,29% Dibayarkan kepada dana rekanan dari putaran Seed/Private. Team (Tim) 15,00% Penggerak pengembangan inti untuk core team (umumnya disertai jadwal penguncian jangka panjang). Ecosystem (Ekosistem) 10,00% Pendanaan pengembangan dApp, mitra strategis yang diintegrasikan ke dalam jaringan. Liquidity (Likuiditas) 5,00% Memastikan likuiditas yang lancar di bursa DEX/CEX.
Alokasi Token:
🟩 Komunitas: 51,71%
🟧 Investor: 18,29%
🟦 Tim: 15%
🟨 Ekosistem: 10%
🟪 Likuiditas: 5%
⚙️ Utilitas Praktis & Penggerak Permintaan (Utility & Demand Drivers)
Pertumbuhan nilai token berkaitan dengan tingkat pemakaian jaringan melalui mekanisme "Token Sink" (penyerap dan menjaga token) yang kuat:
Biaya Gas Jaringan (Native Gas Token): Berbeda dari kebanyakan Layer 2 yang memakai ETH, OpenLedger menggunakan sembilan token untuk membayar transaksi. Ketika jutaan AI Agent melakukan transaksi atau pembaruan data secara terus-menerus, tingkat konsumsi gas akan sangat besar.
Staking untuk menjalankan AI Agent (AI Agent Staking): Agar AI Agent bisa beroperasi dan menyediakan layanan di jaringan, mereka wajib melakukan stake sejumlah besar $OPEN. Jika Agent berjalan buruk atau melakukan kecurangan, token tersebut akan dipotong (Slashing). Ini menciptakan kekuatan permintaan yang mengunci token dalam jumlah besar agar tidak beredar.
Imbalan Attribution dan Tata Kelola: Token digunakan untuk membayar imbalan otomatis kepada para kontributor data berkualitas dan Validator yang memverifikasi sistem. Selain itu, kepemilikan token memungkinkan pengguna memberi suara untuk menentukan model mana yang akan didanai.
6. Mengapa Narrative AI x Web3 Sedang Berada di Titik Ledakan?
Ledakan AI bukan lagi tren sesaat; ini adalah revolusi industri baru. Namun, AI tradisional menghadapi "tembok arus kas" ketika biaya hak cipta data semakin hari semakin mahal.
Model Ownership Economy (Ekonomi Kepemilikan) dari Web3 adalah kunci serbaguna. Ini mengubah data dari sesuatu yang dirampas menjadi aset yang bisa menghasilkan uang (Data Monetization). Puncak berikutnya dari AI bukanlah model-model umum (General AI), melainkan AI Agent yang sangat terspesialisasi untuk ceruk-ceruk kecil (Kesehatan, keuangan, hukum...). Infrastruktur data terbuka seperti OpenLedger adalah satu-satunya tempat yang menyediakan cukup "makanan bersih" untuk memelihara AI Agent tersebut.
7. Perbandingan OpenLedger dengan Proyek AI Lain
Untuk memahami posisi OpenLedger, lihat tabel pengelompokan arah-arah di ruang Crypto x AI saat ini:
Proyek unggulan Kategori Fokus Inti Posisi dibandingkan OpenLedger io.net, Aethir, Akash Fokus Compute: menghimpun dan membagi kekuatan perangkat keras, GPU mentah. Memberi "otot", sedangkan OpenLedger menyediakan "otak dan pengetahuan" (Data). Bittensor (TAO) Fokus Inference/Model: menciptakan jaringan persaingan antar model kecerdasan buatan. Berfokus pada output model, sementara OpenLedger berfokus pada pengolahan dari hulu tepat pada lapisan input (Data Layer). OpenLedger ($OPEN) Fokus Data & Attribution: mengoptimalkan pipeline data, menelusuri kontribusi, dan kepemilikan data. Mengisi celah terbesar saat ini di AI: transparansi sumber pasokan data bersih.
8. Poin Investasi Pribadi (Investment Thesis)
Potensi: Dalam jangka panjang, ketika negara-negara memperketat aturan perlindungan data dan hak cipta (seperti EU AI Act), perusahaan AI besar tidak bisa lagi semaunya meng-scrape data ilegal. OpenLedger bergerak lebih dulu dengan membangun sejak awal sebuah "pasar data" yang berhak cipta, dengan verifikasi on-chain yang jelas. Ini adalah visi yang mengantisipasi arus dana dari para big fund.
Ekspektasi yang realistis: Proyek ini sedang dalam tahap penyempurnaan infrastruktur. Jangan berharap Open bisa tumbuh x100 hanya dalam beberapa hari seperti model memecoin. Ini adalah investasi berbasis Value Investing pada lapisan infrastruktur dasar; nilai token akan bergerak seiring dengan jumlah Datanet dan AI Agent yang dijalankan di jaringan.
9. Risiko & Tantangan (Risks & Challenges)
Sebuah analisis yang objektif tidak lengkap tanpa bagian risiko untuk menghindari FOMO yang buta:
Tantangan adopsi: Memindahkan kebiasaan dari pengembang AI tradisional (yang sudah terbiasa memakai Web2 seperti Hugging Face, AWS) ke Layer 2 Web3 membutuhkan waktu edukasi pasar yang sangat besar.
Kualitas data kontribusi (Data Quality): Meski ada lapisan Validator untuk validasi, jaringan terdesentralisasi tetap harus menghadapi risiko spam dengan data sampah atau data palsu untuk "menggerus" bagian dari imbalan token.
Tekanan inflasi token: Dengan 51,71% token dialokasikan untuk komunitas dan incentives, jika laju pengembangan aplikasi nyata tidak mengejar kecepatan unlock/distribusi token insentif, Open akan menghadapi tekanan jual besar dari para peserta jaringan.
10. Kesimpulan
OpenLedger membuktikan bahwa ia bukan proyek "berlabel AI" untuk menaikkan harga token. Dengan menangani langsung masalah paling mendesak AI modern, yaitu Hak Kepemilikan dan Pembuktian Kontribusi Data, proyek ini sedang membangun parit ekonomi yang kokoh di segmen Lapisan Data (Data Layer).
Pasar AI yang terdesentralisasi masih berada di bab-bab awal. Lakukan riset yang benar-benar teliti (DYOR) dan pantau dengan saksama tonggak mainnet berikutnya dari proyek ini.
👉 Ikuti sekarang @OpenLedger untuk update program kontribusi data yang menghasilkan imbalan sedini mungkin!