


Mengubah perintah tertulis menjadi narasi visual yang meyakinkan telah diidentifikasi sebagai tantangan penting dalam bidang pembuatan teks-ke-video, di mana banyak model bermunculan. Tugas ini, yang berbeda dari pembuatan film tradisional, memerlukan serangkaian kemampuan yang berbeda, serupa dengan penyutradaraan, dan menguasai Video Object Generation (VOG) bisa menjadi tantangan yang cukup besar. Selain itu, observasi yang tajam merupakan suatu bentuk seni tersendiri.
Untuk mengatasi hal ini, VideoDirectorGPT menghadirkan pendekatan inovatif untuk membuat video multi-adegan yang tepat dan konsisten, sehingga menyederhanakan prosesnya. Pada intinya, VideoDirectorGPT menggunakan metodologi dua tahap yang menggabungkan kehebatan Model Bahasa Besar (LLM) dengan seni penjadwalan video.
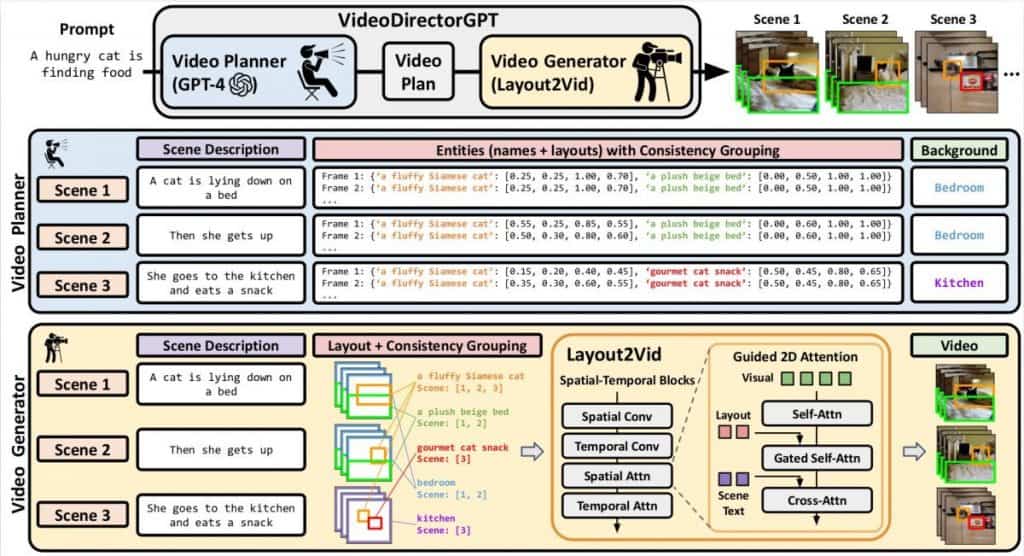
Penjadwalan Terpandu LLM. Pada tahap pertama, VideoDirectorGPT menggunakan LLM sebagai penjadwal video. LLM bertindak sebagai master penceritaan, yang menyusun narasi menyeluruh untuk video multi-adegan. Narasi ini terdiri dari deskripsi teks tingkat adegan, daftar detail objek dan latar belakang di setiap adegan, tata letak objek frame-by-frame yang presisi dengan kotak pembatas, dan pengelompokan koherensi cerdas untuk objek dan latar belakang.
Pembuatan Video Layout2VidSetelah LLM menyusun rencana video dengan cermat, saatnya untuk menerapkannya. Di sinilah Layout2Vid, modul pembuatan video, berperan. Mengembangkan cetak biru yang dibuat pada tahap awal, Layout2Vid menggunakan penyisipan gambar dan teks yang identik untuk menggambarkan objek dan latar belakang dalam rencana video. Namun, yang luar biasa — modul ini menyediakan kontrol spasial atas tata letak objek melalui mekanisme atensi 2D canggih yang terintegrasi ke dalam unit atensi spasial.
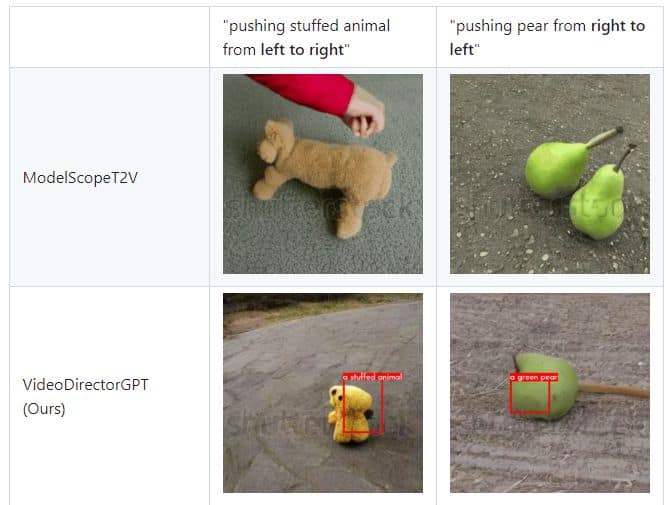 Model VideoDirectorGPT mampu menghasilkan rencana video yang menyeluruh dengan lokasi kotak pembatas objek yang akurat (overlay), orang yang konsisten di seluruh adegan, dan prompt teks asli yang diperluas dengan tepat untuk menunjukkan prosesnya. Kue jintan dan peach melba adalah satu-satunya makanan yang dihasilkan ModelScopeT2V, dan keduanya bervariasi dari satu adegan ke adegan lainnya.
Hasilnya adalah video yang diorkestrasi dengan mulus, yang mengikuti deskripsi teks awal, dan menerjemahkannya ke dalam rangkaian visual yang dinamis. Ini merupakan perpaduan antara konstruksi naratif berbasis AI dan rendering video yang cermat, memastikan konten yang dihasilkan selaras dengan visi kreator.
Pada bulan Agustus, Yandex memperkenalkan fitur baru bernama Masterpiece, yang memungkinkan pengguna membuat video pendek berdurasi hingga 4 detik dengan frame rate 24 frame per detik. Teknologi ini menggunakan metode difusi bertingkat untuk menyusun frame video berikutnya, menghasilkan gambar yang selaras dengan deskripsi pengguna. Masterpiece menawarkan aksesibilitas dan kesederhanaan, menjadikannya pilihan yang menarik bagi pemula dan pengguna dari semua tingkat keahlian. Implikasi teknologi yang lebih luas melampaui ekspresi kreatif dan dapat mendefinisikan ulang pembuatan dan konsumsi konten digital.
Selain itu, awal tahun ini, Runway merilis Gen-2, sebuah model teks-ke-video yang dapat menghasilkan video baru dari awal menggunakan perintah teks, sebuah peningkatan signifikan dibandingkan versi sebelumnya. Fitur ini menghemat waktu dan tenaga karena menghasilkan video yang tidak memerlukan keahlian penyuntingan tingkat lanjut. Selain itu, Gen-2 dapat mengonversi gambar yang diunggah menjadi klip video pendek dengan kualitas lebih tinggi dibandingkan pesaingnya. Teknologi ini diharapkan dapat meningkatkan pembuatan dan penyebaran konten di platform media sosial, yang berpotensi menguntungkan platform seperti Facebook dan TikTok.
Baca lebih banyak topik terkait:
50 Prompt AI Teks-ke-Video Terbaik: Animasi Gambar Mudah
10+ Generator AI Teks-ke-Video Terbaik: Kuat dan Gratis
Postingan VideoDirectorGPT: Sutradara Bertenaga AI yang Membentuk Ulang Produksi Teks-ke-Video muncul pertama kali di Metaverse Post.