
#benchmark
benchmark
16,156 penayangan
30 Berdiskusi
Populer
Terbaru

$GROK BARU SAJA MELAMPAUI CLAUDE DAN OPUS DARI SEGI BIAYA DAN KINERJA 🔥
Grok 4.5 baru saja meraih peningkatan 51,4% di AutomationBench-AA — unggul dari Claude dan Opus — dan melakukannya dengan biaya $0,34 per tugas dibandingkan mereka yang $1,35+. Ini adalah kesenjangan efisiensi yang sangat besar untuk agen AI.
Model ini sudah live di fondasi V9 milik SpaceXAI, dan benchmark memvalidasi apa yang tim tawarkan. Data independen seperti ini biasanya menarik perhatian pada token yang terkait dengan infrastruktur nyata. Volume bisa bergerak cepat jika para trader mulai memasukkan kisah adopsi ke dalam penetapan harga.
Apakah kamu memantau $GROK memanfaatkan katalis ini?
Bukan nasihat keuangan. Selalu kelola risiko kamu.
#GROK #AI #Benchmark #Agent
🔥
$GROK BARU SAJA MELAMPAUI CLAUDE DAN OPUS DARI SEGI BIAYA DAN KINERJA 🔥
Grok 4.5 baru saja meraih peningkatan 51,4% di AutomationBench-AA — unggul dari Claude dan Opus — dan melakukannya dengan biaya $0,34 per tugas dibandingkan mereka yang $1,35+. Ini adalah kesenjangan efisiensi yang sangat besar untuk agen AI.
Model ini sudah live di fondasi V9 milik SpaceXAI, dan benchmark memvalidasi apa yang tim tawarkan. Data independen seperti ini biasanya menarik perhatian pada token yang terkait dengan infrastruktur nyata. Volume bisa bergerak cepat jika para trader mulai memasukkan kisah adopsi ke dalam penetapan harga.
Apakah kamu memantau $GROK memanfaatkan katalis ini?
Bukan nasihat keuangan. Selalu kelola risiko kamu.
#GROK #AI #Benchmark #Agent
🔥
Grok 4.5 baru saja meraih peningkatan 51,4% di AutomationBench-AA — unggul dari Claude dan Opus — dan melakukannya dengan biaya $0,34 per tugas dibandingkan mereka yang $1,35+. Ini adalah kesenjangan efisiensi yang sangat besar untuk agen AI.
Model ini sudah live di fondasi V9 milik SpaceXAI, dan benchmark memvalidasi apa yang tim tawarkan. Data independen seperti ini biasanya menarik perhatian pada token yang terkait dengan infrastruktur nyata. Volume bisa bergerak cepat jika para trader mulai memasukkan kisah adopsi ke dalam penetapan harga.
Apakah kamu memantau $GROK memanfaatkan katalis ini?
Bukan nasihat keuangan. Selalu kelola risiko kamu.
#GROK #AI #Benchmark #Agent
🔥
39

·
--
📜 Reformasi SEC Bisa Membuka Pasar Tokenisasi: Benchmark 💡
Bank investasi Benchmark mengatakan proposal terbaru SEC bisa jadi regulasi crypto paling krusial di 2026 ⚖️
🔍 Proposalnya
▶️ Aturan yang dihapus SEC ingin mencabut Aturan 611 + 610(e) di bawah Reg NMS, yang diterbitkan 11 Juni 📄
▶️ Mengapa dicabut Membuang aturan perlindungan/perdagangan berusia 20 tahun untuk mengurangi biaya, meningkatkan persaingan, dan mendorong inovasi teknologi 💰
▶️ Garis waktu Komentar publik terbuka selama 60 hari. Pemungutan suara final bisa saja dilakukan awal 2027 🗓️
⛓️ Kesepakatan Besar untuk Perdagangan On-Chain
▶️ Masalah saat ini Aturan 611 menegakkan eksekusi NBBO. Aturan 610(e) membatasi kutipan terkunci/silang. Baik untuk order books, buruk untuk DeFi AMM 🤖
▶️ Dampak jika dihapus Mengurangi biaya kepatuhan untuk saham tokenisasi + infrastruktur on-chain. Membuka pintu untuk model AMM di pasar modal AS 🚪
▶️ Bukan solusi penuh Masih butuh kejelasan tentang pendaftaran bursa, kustodi/kliring, status hukum model DeFi ❓
🏢 Pemenang yang Harus Diperhatikan
▶️ Manfaat langsung Securitize – pemain infrastruktur sekuritas tokenisasi 🏗️
▶️ Potensi lain Coinbase + Galaxy Digital – perdagangan, pembuatan pasar, infrastruktur kustodi bisa berkembang 📈
🧪 Apa Selanjutnya
▶️ Pengecualian konversi Industri ingin jembatan kebijakan untuk membantu transisi yang mirip dengan satu 🔄
▶️ Gambaran besar Jika disetujui, bisa mempermudah integrasi aset tokenisasi + DeFi ke dalam TradFi
🎯 Garis Bawah
Mencabut aturan NMS 611/610(e) menghapus penghalang AMM. Benchmark: salah satu acara crypto terbesar di 2026. Masih butuh lebih banyak kejelasan regulasi 🧩
#SEC #Tokenization #CryptoRegulation #Benchmark
$BTC $XRP $BNB
{future}(BNBUSDT)
{future}(XRPUSDT)
{future}(BTCUSDT)
📜 Reformasi SEC Bisa Membuka Pasar Tokenisasi: Benchmark 💡
Bank investasi Benchmark mengatakan proposal terbaru SEC bisa jadi regulasi crypto paling krusial di 2026 ⚖️
🔍 Proposalnya
▶️ Aturan yang dihapus SEC ingin mencabut Aturan 611 + 610(e) di bawah Reg NMS, yang diterbitkan 11 Juni 📄
▶️ Mengapa dicabut Membuang aturan perlindungan/perdagangan berusia 20 tahun untuk mengurangi biaya, meningkatkan persaingan, dan mendorong inovasi teknologi 💰
▶️ Garis waktu Komentar publik terbuka selama 60 hari. Pemungutan suara final bisa saja dilakukan awal 2027 🗓️
⛓️ Kesepakatan Besar untuk Perdagangan On-Chain
▶️ Masalah saat ini Aturan 611 menegakkan eksekusi NBBO. Aturan 610(e) membatasi kutipan terkunci/silang. Baik untuk order books, buruk untuk DeFi AMM 🤖
▶️ Dampak jika dihapus Mengurangi biaya kepatuhan untuk saham tokenisasi + infrastruktur on-chain. Membuka pintu untuk model AMM di pasar modal AS 🚪
▶️ Bukan solusi penuh Masih butuh kejelasan tentang pendaftaran bursa, kustodi/kliring, status hukum model DeFi ❓
🏢 Pemenang yang Harus Diperhatikan
▶️ Manfaat langsung Securitize – pemain infrastruktur sekuritas tokenisasi 🏗️
▶️ Potensi lain Coinbase + Galaxy Digital – perdagangan, pembuatan pasar, infrastruktur kustodi bisa berkembang 📈
🧪 Apa Selanjutnya
▶️ Pengecualian konversi Industri ingin jembatan kebijakan untuk membantu transisi yang mirip dengan satu 🔄
▶️ Gambaran besar Jika disetujui, bisa mempermudah integrasi aset tokenisasi + DeFi ke dalam TradFi
🎯 Garis Bawah
Mencabut aturan NMS 611/610(e) menghapus penghalang AMM. Benchmark: salah satu acara crypto terbesar di 2026. Masih butuh lebih banyak kejelasan regulasi 🧩
#SEC #Tokenization #CryptoRegulation #Benchmark
$BTC $XRP $BNB
Bank investasi Benchmark mengatakan proposal terbaru SEC bisa jadi regulasi crypto paling krusial di 2026 ⚖️
🔍 Proposalnya
▶️ Aturan yang dihapus SEC ingin mencabut Aturan 611 + 610(e) di bawah Reg NMS, yang diterbitkan 11 Juni 📄
▶️ Mengapa dicabut Membuang aturan perlindungan/perdagangan berusia 20 tahun untuk mengurangi biaya, meningkatkan persaingan, dan mendorong inovasi teknologi 💰
▶️ Garis waktu Komentar publik terbuka selama 60 hari. Pemungutan suara final bisa saja dilakukan awal 2027 🗓️
⛓️ Kesepakatan Besar untuk Perdagangan On-Chain
▶️ Masalah saat ini Aturan 611 menegakkan eksekusi NBBO. Aturan 610(e) membatasi kutipan terkunci/silang. Baik untuk order books, buruk untuk DeFi AMM 🤖
▶️ Dampak jika dihapus Mengurangi biaya kepatuhan untuk saham tokenisasi + infrastruktur on-chain. Membuka pintu untuk model AMM di pasar modal AS 🚪
▶️ Bukan solusi penuh Masih butuh kejelasan tentang pendaftaran bursa, kustodi/kliring, status hukum model DeFi ❓
🏢 Pemenang yang Harus Diperhatikan
▶️ Manfaat langsung Securitize – pemain infrastruktur sekuritas tokenisasi 🏗️
▶️ Potensi lain Coinbase + Galaxy Digital – perdagangan, pembuatan pasar, infrastruktur kustodi bisa berkembang 📈
🧪 Apa Selanjutnya
▶️ Pengecualian konversi Industri ingin jembatan kebijakan untuk membantu transisi yang mirip dengan satu 🔄
▶️ Gambaran besar Jika disetujui, bisa mempermudah integrasi aset tokenisasi + DeFi ke dalam TradFi
🎯 Garis Bawah
Mencabut aturan NMS 611/610(e) menghapus penghalang AMM. Benchmark: salah satu acara crypto terbesar di 2026. Masih butuh lebih banyak kejelasan regulasi 🧩
#SEC #Tokenization #CryptoRegulation #Benchmark
$BTC $XRP $BNB
306
6
35
306
·
--
🚨 $AGIX ASISTEN BATTLE PENGUNGKAPAN UNGGULAN PASAR! 💥
📊 Tolok Ukur Asisten yang baru dirilis menguji agen AI untuk tugas dunia nyata—memesan hotel, belanja, membalas email—dan menilai mereka berdasarkan eksekusi. Muse memimpin dengan rata-rata 9,1 di tujuh dimensi, mengungguli Instinct dan Grok Bot. 🦈 Pengamat uang cerdas menunjukkan bahwa pemimpin yang jelas dalam AI operasional dapat berujung pada peningkatan permintaan untuk infrastruktur AI di on-chain, di mana $AGIX menjadi token utilitas utama. 📈 Keunggulan berkelanjutan dari Muse dapat memicu arus masuk ke proyek-proyek yang berfokus pada AI, mengisi pool likuiditas di sekitar $AGIX. 💬 Apakah Anda melihat $AGIX reli berdasarkan hierarki performa AI yang sedang muncul ini? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AGIX #AI #Benchmark #SmartMoney #Crypto
🔥 💎
🚨 $AGIX ASISTEN BATTLE PENGUNGKAPAN UNGGULAN PASAR! 💥
📊 Tolok Ukur Asisten yang baru dirilis menguji agen AI untuk tugas dunia nyata—memesan hotel, belanja, membalas email—dan menilai mereka berdasarkan eksekusi. Muse memimpin dengan rata-rata 9,1 di tujuh dimensi, mengungguli Instinct dan Grok Bot. 🦈 Pengamat uang cerdas menunjukkan bahwa pemimpin yang jelas dalam AI operasional dapat berujung pada peningkatan permintaan untuk infrastruktur AI di on-chain, di mana $AGIX menjadi token utilitas utama. 📈 Keunggulan berkelanjutan dari Muse dapat memicu arus masuk ke proyek-proyek yang berfokus pada AI, mengisi pool likuiditas di sekitar $AGIX. 💬 Apakah Anda melihat $AGIX reli berdasarkan hierarki performa AI yang sedang muncul ini? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AGIX #AI #Benchmark #SmartMoney #Crypto
🔥 💎
📊 Tolok Ukur Asisten yang baru dirilis menguji agen AI untuk tugas dunia nyata—memesan hotel, belanja, membalas email—dan menilai mereka berdasarkan eksekusi. Muse memimpin dengan rata-rata 9,1 di tujuh dimensi, mengungguli Instinct dan Grok Bot. 🦈 Pengamat uang cerdas menunjukkan bahwa pemimpin yang jelas dalam AI operasional dapat berujung pada peningkatan permintaan untuk infrastruktur AI di on-chain, di mana $AGIX menjadi token utilitas utama. 📈 Keunggulan berkelanjutan dari Muse dapat memicu arus masuk ke proyek-proyek yang berfokus pada AI, mengisi pool likuiditas di sekitar $AGIX. 💬 Apakah Anda melihat $AGIX reli berdasarkan hierarki performa AI yang sedang muncul ini? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AGIX #AI #Benchmark #SmartMoney #Crypto
🔥 💎
1
136

·
--
🚀 $AI MEMBUKA SWE-2: 5‑6% CODING EDGE DENGAN BIAYA 64% LEBIH RENDAH 💥
📊 SWE-2 dibangun langsung di atas Kimi K3 berparameter 2,8T milik Moonshot AI, dengan memanfaatkan reinforced learning untuk meningkatkan beberapa skor benchmark sebesar 5–6 poin persentase. Pada Cognition’s FrontierCode 1.1 Main, model ini mencapai 50,0 %, sedikit melampaui GPT‑5.6 Sol (47,5 %) dan Grok 4.6 (48,0 %). ⚡ Model ini memangkas jumlah turn interaksi sebesar 58 % dan menurunkan biaya rata-rata sebesar 81 %, memberikan pukulan harga seperempat dibanding skor 53,3 % GPT‑6 Astra.
🔍 Namun pada Terminal‑Bench 4 yang lebih menantang, SWE‑2 tertinggal di 27,3 % dibanding Astra 57,9 % dan Fable 5.1 55,8 %, menandakan masih ada ruang untuk peningkatan di frontier. 📈
💬 Penempatan (deployment) yang mana yang ingin Anda targetkan lebih dulu untuk memanfaatkan keunggulan efisiensi biaya SWE‑2? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #CodingModel #Efficiency #Benchmark #Tech
🔥 💎
🚀 $AI MEMBUKA SWE-2: 5‑6% CODING EDGE DENGAN BIAYA 64% LEBIH RENDAH 💥
📊 SWE-2 dibangun langsung di atas Kimi K3 berparameter 2,8T milik Moonshot AI, dengan memanfaatkan reinforced learning untuk meningkatkan beberapa skor benchmark sebesar 5–6 poin persentase. Pada Cognition’s FrontierCode 1.1 Main, model ini mencapai 50,0 %, sedikit melampaui GPT‑5.6 Sol (47,5 %) dan Grok 4.6 (48,0 %). ⚡ Model ini memangkas jumlah turn interaksi sebesar 58 % dan menurunkan biaya rata-rata sebesar 81 %, memberikan pukulan harga seperempat dibanding skor 53,3 % GPT‑6 Astra.
🔍 Namun pada Terminal‑Bench 4 yang lebih menantang, SWE‑2 tertinggal di 27,3 % dibanding Astra 57,9 % dan Fable 5.1 55,8 %, menandakan masih ada ruang untuk peningkatan di frontier. 📈
💬 Penempatan (deployment) yang mana yang ingin Anda targetkan lebih dulu untuk memanfaatkan keunggulan efisiensi biaya SWE‑2? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #CodingModel #Efficiency #Benchmark #Tech
🔥 💎
📊 SWE-2 dibangun langsung di atas Kimi K3 berparameter 2,8T milik Moonshot AI, dengan memanfaatkan reinforced learning untuk meningkatkan beberapa skor benchmark sebesar 5–6 poin persentase. Pada Cognition’s FrontierCode 1.1 Main, model ini mencapai 50,0 %, sedikit melampaui GPT‑5.6 Sol (47,5 %) dan Grok 4.6 (48,0 %). ⚡ Model ini memangkas jumlah turn interaksi sebesar 58 % dan menurunkan biaya rata-rata sebesar 81 %, memberikan pukulan harga seperempat dibanding skor 53,3 % GPT‑6 Astra.
🔍 Namun pada Terminal‑Bench 4 yang lebih menantang, SWE‑2 tertinggal di 27,3 % dibanding Astra 57,9 % dan Fable 5.1 55,8 %, menandakan masih ada ruang untuk peningkatan di frontier. 📈
💬 Penempatan (deployment) yang mana yang ingin Anda targetkan lebih dulu untuk memanfaatkan keunggulan efisiensi biaya SWE‑2? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #CodingModel #Efficiency #Benchmark #Tech
🔥 💎
25

·
--
$MINARA DMIND BENCHMARK DITERIMA OLEH KDD 2026 - SEBUAH PERTAMA UNTUK AI + ASET DIGITAL 🔥
Benchmark DMind dari tim Minara adalah evaluasi LLM lintas-disiplin pertama dalam aset digital yang berhasil lolos peer review di konferensi internasional teratas. Dengan 3.154 pertanyaan yang divalidasi oleh para ahli dan 389 tugas open-ended yang mencakup DeFi, tokenomics, serta keamanan smart contract, benchmark ini secara sistematis menguji 31 model mulai dari GPT hingga Claude dan Gemini.
Benchmark ini menempati peringkat #1 di Hugging Face Trending dengan lebih dari 13.000 unduhan. Penilaian ulang pada Juli 2026 mengungkap bahwa bahkan model flagship terbaru sekalipun masih meninggalkan kesenjangan kapabilitas yang dalam di ranah ini.
Apakah Anda sedang menyaksikan bagaimana AI sekarang dipaksa untuk benar-benar memahami aset digital?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#MINARA #DMIND #AI #Benchmark #DigitalAssets
🎯
$MINARA DMIND BENCHMARK DITERIMA OLEH KDD 2026 - SEBUAH PERTAMA UNTUK AI + ASET DIGITAL 🔥
Benchmark DMind dari tim Minara adalah evaluasi LLM lintas-disiplin pertama dalam aset digital yang berhasil lolos peer review di konferensi internasional teratas. Dengan 3.154 pertanyaan yang divalidasi oleh para ahli dan 389 tugas open-ended yang mencakup DeFi, tokenomics, serta keamanan smart contract, benchmark ini secara sistematis menguji 31 model mulai dari GPT hingga Claude dan Gemini.
Benchmark ini menempati peringkat #1 di Hugging Face Trending dengan lebih dari 13.000 unduhan. Penilaian ulang pada Juli 2026 mengungkap bahwa bahkan model flagship terbaru sekalipun masih meninggalkan kesenjangan kapabilitas yang dalam di ranah ini.
Apakah Anda sedang menyaksikan bagaimana AI sekarang dipaksa untuk benar-benar memahami aset digital?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#MINARA #DMIND #AI #Benchmark #DigitalAssets
🎯
Benchmark DMind dari tim Minara adalah evaluasi LLM lintas-disiplin pertama dalam aset digital yang berhasil lolos peer review di konferensi internasional teratas. Dengan 3.154 pertanyaan yang divalidasi oleh para ahli dan 389 tugas open-ended yang mencakup DeFi, tokenomics, serta keamanan smart contract, benchmark ini secara sistematis menguji 31 model mulai dari GPT hingga Claude dan Gemini.
Benchmark ini menempati peringkat #1 di Hugging Face Trending dengan lebih dari 13.000 unduhan. Penilaian ulang pada Juli 2026 mengungkap bahwa bahkan model flagship terbaru sekalipun masih meninggalkan kesenjangan kapabilitas yang dalam di ranah ini.
Apakah Anda sedang menyaksikan bagaimana AI sekarang dipaksa untuk benar-benar memahami aset digital?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#MINARA #DMIND #AI #Benchmark #DigitalAssets
🎯
7
·
--
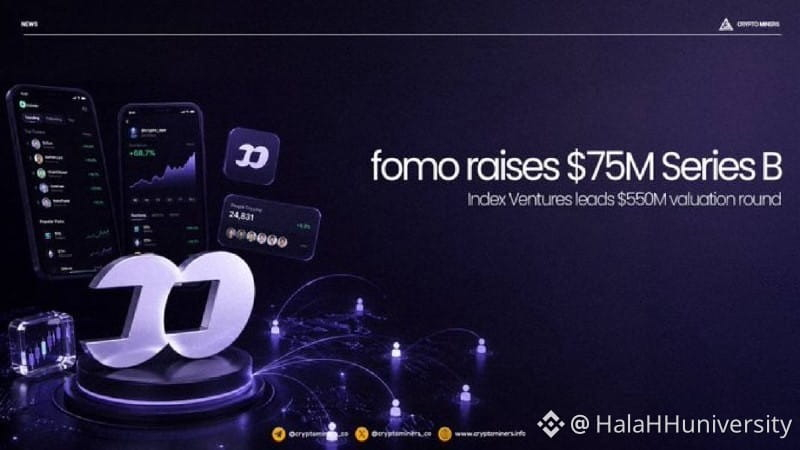
⚡ Platform FOMO menerima investasi sebesar 75 juta dolar dalam putaran pendanaan senilai 550 juta dolar
💰 Putaran pendanaan senilai 75 juta dolar dipimpin oleh #Index #Ventures , dengan partisipasi dari USV dan dukungan berkelanjutan dari #benchmark
📈 Pada tahun pertama operasinya, platform ini melampaui #FOMO 625 ribu pengguna, dengan volume perdagangan mencapai lebih dari 4 miliar dolar, serta memperkenalkan 68 ribu pembeli aset kripto untuk pertama kalinya melalui sistem pembayaran Apple
💎 Investasi ini memperkuat posisi platform FOMO sebagai pemimpin di pasar trading sosial, sekaligus membuka peluang baru untuk ekspansi dan pertumbuhan di pasar digital
⚡ Platform FOMO menerima investasi sebesar 75 juta dolar dalam putaran pendanaan senilai 550 juta dolar
💰 Putaran pendanaan senilai 75 juta dolar dipimpin oleh #Index #Ventures , dengan partisipasi dari USV dan dukungan berkelanjutan dari #benchmark
📈 Pada tahun pertama operasinya, platform ini melampaui #FOMO 625 ribu pengguna, dengan volume perdagangan mencapai lebih dari 4 miliar dolar, serta memperkenalkan 68 ribu pembeli aset kripto untuk pertama kalinya melalui sistem pembayaran Apple
💎 Investasi ini memperkuat posisi platform FOMO sebagai pemimpin di pasar trading sosial, sekaligus membuka peluang baru untuk ekspansi dan pertumbuhan di pasar digital
💰 Putaran pendanaan senilai 75 juta dolar dipimpin oleh #Index #Ventures , dengan partisipasi dari USV dan dukungan berkelanjutan dari #benchmark
📈 Pada tahun pertama operasinya, platform ini melampaui #FOMO 625 ribu pengguna, dengan volume perdagangan mencapai lebih dari 4 miliar dolar, serta memperkenalkan 68 ribu pembeli aset kripto untuk pertama kalinya melalui sistem pembayaran Apple
💎 Investasi ini memperkuat posisi platform FOMO sebagai pemimpin di pasar trading sosial, sekaligus membuka peluang baru untuk ekspansi dan pertumbuhan di pasar digital
20

·
--
$GROK VS $GPT : PERANG BIAYA Menggeser Lanskap AI 🔥
Entry: N/A 🔥
Target: N/A 🚀
Stop Loss: N/A ⚠️
Grok 4.5 membebankan biaya $2 per satu juta token input terhadap GPT‑5.6 Sol’s $5, dan menyelesaikan tugas coding dengan biaya $2,49 dibanding Fable 5 yang $11,80 — sebuah keunggulan biaya 4,7x yang penting untuk alur kerja volume tinggi. Namun, tingkat halusinasi naik dua kali lipat menjadi 54%, jadi akurasi tetap menjadi trade‑off.
Benchmark independen menunjukkan GPT‑5.6 Sol meraih 86 poin dibanding Grok 4.5 yang 82, didorong oleh skor coding agenik sebesar 91,9%. Kesenjangannya nyata, tetapi belum cukup untuk mengabaikan selisih harga bagi tim yang fokus pada anggaran. Metrik mana yang memengaruhi keputusan Anda — skor benchmark atau biaya per tugas?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#GROK #GPT #AI #Benchmark #CostComparison
🔥
$GROK VS $GPT : PERANG BIAYA Menggeser Lanskap AI 🔥
Entry: N/A 🔥
Target: N/A 🚀
Stop Loss: N/A ⚠️
Grok 4.5 membebankan biaya $2 per satu juta token input terhadap GPT‑5.6 Sol’s $5, dan menyelesaikan tugas coding dengan biaya $2,49 dibanding Fable 5 yang $11,80 — sebuah keunggulan biaya 4,7x yang penting untuk alur kerja volume tinggi. Namun, tingkat halusinasi naik dua kali lipat menjadi 54%, jadi akurasi tetap menjadi trade‑off.
Benchmark independen menunjukkan GPT‑5.6 Sol meraih 86 poin dibanding Grok 4.5 yang 82, didorong oleh skor coding agenik sebesar 91,9%. Kesenjangannya nyata, tetapi belum cukup untuk mengabaikan selisih harga bagi tim yang fokus pada anggaran. Metrik mana yang memengaruhi keputusan Anda — skor benchmark atau biaya per tugas?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#GROK #GPT #AI #Benchmark #CostComparison
🔥
Entry: N/A 🔥
Target: N/A 🚀
Stop Loss: N/A ⚠️
Grok 4.5 membebankan biaya $2 per satu juta token input terhadap GPT‑5.6 Sol’s $5, dan menyelesaikan tugas coding dengan biaya $2,49 dibanding Fable 5 yang $11,80 — sebuah keunggulan biaya 4,7x yang penting untuk alur kerja volume tinggi. Namun, tingkat halusinasi naik dua kali lipat menjadi 54%, jadi akurasi tetap menjadi trade‑off.
Benchmark independen menunjukkan GPT‑5.6 Sol meraih 86 poin dibanding Grok 4.5 yang 82, didorong oleh skor coding agenik sebesar 91,9%. Kesenjangannya nyata, tetapi belum cukup untuk mengabaikan selisih harga bagi tim yang fokus pada anggaran. Metrik mana yang memengaruhi keputusan Anda — skor benchmark atau biaya per tugas?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#GROK #GPT #AI #Benchmark #CostComparison
🔥
26
·
--
$GROK 4.5 MEMIMPIN BENCHMARK DENGAN BIAYA PER TUGAS TERENDAH 🔥
Grok 4.5 meraih 51,4% pada AutomationBench-AA, mengungguli Claude Fable 5 dengan 48,6% dan Claude Opus 4.8 dengan 48,5%. Model ini hanya menelan biaya $0,34 per tugas—sebagian kecil dari biaya Anthropic yang $1,35–$1,46—dan menggunakan kira-kira seperempat dari jumlah token output per tugas dibandingkan Opus 4.8.
Di bidang keuangan, domain paling sulit, Grok 4.5 memimpin dengan 71% penyelesaian tugas. Namun kepatuhan adalah trade-off: 0,63 pelanggaran guardrail per tugas, dibanding 0,55 untuk Opus 4.8. Kesenjangan ini penting bagi agen yang berada di dekat sistem keuangan yang berjalan secara langsung. Apakah Anda akan menukar efisiensi biaya dengan risiko kepatuhan yang lebih tinggi dalam produksi?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#GROK #AI #Benchmark #Grok45 #Enterprise
🔥
$GROK 4.5 MEMIMPIN BENCHMARK DENGAN BIAYA PER TUGAS TERENDAH 🔥
Grok 4.5 meraih 51,4% pada AutomationBench-AA, mengungguli Claude Fable 5 dengan 48,6% dan Claude Opus 4.8 dengan 48,5%. Model ini hanya menelan biaya $0,34 per tugas—sebagian kecil dari biaya Anthropic yang $1,35–$1,46—dan menggunakan kira-kira seperempat dari jumlah token output per tugas dibandingkan Opus 4.8.
Di bidang keuangan, domain paling sulit, Grok 4.5 memimpin dengan 71% penyelesaian tugas. Namun kepatuhan adalah trade-off: 0,63 pelanggaran guardrail per tugas, dibanding 0,55 untuk Opus 4.8. Kesenjangan ini penting bagi agen yang berada di dekat sistem keuangan yang berjalan secara langsung. Apakah Anda akan menukar efisiensi biaya dengan risiko kepatuhan yang lebih tinggi dalam produksi?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#GROK #AI #Benchmark #Grok45 #Enterprise
🔥
Grok 4.5 meraih 51,4% pada AutomationBench-AA, mengungguli Claude Fable 5 dengan 48,6% dan Claude Opus 4.8 dengan 48,5%. Model ini hanya menelan biaya $0,34 per tugas—sebagian kecil dari biaya Anthropic yang $1,35–$1,46—dan menggunakan kira-kira seperempat dari jumlah token output per tugas dibandingkan Opus 4.8.
Di bidang keuangan, domain paling sulit, Grok 4.5 memimpin dengan 71% penyelesaian tugas. Namun kepatuhan adalah trade-off: 0,63 pelanggaran guardrail per tugas, dibanding 0,55 untuk Opus 4.8. Kesenjangan ini penting bagi agen yang berada di dekat sistem keuangan yang berjalan secara langsung. Apakah Anda akan menukar efisiensi biaya dengan risiko kepatuhan yang lebih tinggi dalam produksi?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#GROK #AI #Benchmark #Grok45 #Enterprise
🔥
31

$AI DMIND BENCHMARK DISETUJUI OLEH KDD 2026 – SEBUAH PERTAMA 🚀
3.154 pertanyaan yang ditinjau oleh ahli, 389 tugas terbuka, mencakup DeFi, Tokenomics, dan keamanan smart contract. Benchmark ini baru saja melewati peer review untuk KDD 2026 — evaluasi lintas-disiplin pertama di aset digital + AI.
Dataset ini masuk ke Tren HuggingFace pada #1 dan sudah memiliki lebih dari 13 ribu unduhan. Bahkan model andalan terbaru pun masih menunjukkan celah yang mendalam dalam penalaran bertahap untuk skenario kripto dunia nyata.
Artinya keunggulannya masih awal, dan hambatan untuk pemahaman yang benar masih tinggi. Apakah Anda siap menghadapi pergeseran saat AI mulai benar-benar memahami alur kerja aset digital?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#AI #DigitalAssets #Benchmark #KDD2026 #CryptoAI
🔥
$AI DMIND BENCHMARK DISETUJUI OLEH KDD 2026 – SEBUAH PERTAMA 🚀
3.154 pertanyaan yang ditinjau oleh ahli, 389 tugas terbuka, mencakup DeFi, Tokenomics, dan keamanan smart contract. Benchmark ini baru saja melewati peer review untuk KDD 2026 — evaluasi lintas-disiplin pertama di aset digital + AI.
Dataset ini masuk ke Tren HuggingFace pada #1 dan sudah memiliki lebih dari 13 ribu unduhan. Bahkan model andalan terbaru pun masih menunjukkan celah yang mendalam dalam penalaran bertahap untuk skenario kripto dunia nyata.
Artinya keunggulannya masih awal, dan hambatan untuk pemahaman yang benar masih tinggi. Apakah Anda siap menghadapi pergeseran saat AI mulai benar-benar memahami alur kerja aset digital?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#AI #DigitalAssets #Benchmark #KDD2026 #CryptoAI
🔥
3.154 pertanyaan yang ditinjau oleh ahli, 389 tugas terbuka, mencakup DeFi, Tokenomics, dan keamanan smart contract. Benchmark ini baru saja melewati peer review untuk KDD 2026 — evaluasi lintas-disiplin pertama di aset digital + AI.
Dataset ini masuk ke Tren HuggingFace pada #1 dan sudah memiliki lebih dari 13 ribu unduhan. Bahkan model andalan terbaru pun masih menunjukkan celah yang mendalam dalam penalaran bertahap untuk skenario kripto dunia nyata.
Artinya keunggulannya masih awal, dan hambatan untuk pemahaman yang benar masih tinggi. Apakah Anda siap menghadapi pergeseran saat AI mulai benar-benar memahami alur kerja aset digital?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#AI #DigitalAssets #Benchmark #KDD2026 #CryptoAI
🔥
95
Masuk untuk menjelajahi konten lainnya
Bergabunglah dengan pengguna kripto global di Binance Square
⚡️ Dapatkan informasi terbaru dan berguna tentang kripto.
💬 Dipercayai oleh bursa kripto terbesar di dunia.
👍 Temukan wawasan nyata dari kreator terverifikasi.
Email/Nomor Ponsel
Topik Sedang Tren
1
#FedRateWatch
480,197 penayangan
2,466 Berdiskusi
2
#BitcoinSlidesTo$76000
15,154 penayangan
105 Berdiskusi
3
#BitcoinReboundsTo$79K
59,468 penayangan
396 Berdiskusi
4
#StrategyMarketCapPassesFord
28,140 penayangan
575 Berdiskusi
5
#ClarityActOddsHalveOnPolymarket
38,254 penayangan
463 Berdiskusi
6
#US30YTreasuryYieldTops5.40%
25,440 penayangan
329 Berdiskusi
7
#BessentEndorsesFinalClarityActDraft
48,664 penayangan
694 Berdiskusi
8
#ZamaOpens16ConfidentialMorphoVaults
16,462 penayangan
329 Berdiskusi
9
#USDCOnChainVolumeTops$100Trillion
2,505 penayangan
48 Berdiskusi
10
#BitcoinSpotETFsNetInflow$160M
3,588 penayangan
102 Berdiskusi