

Dans la continuité des deux articles précédents sur les questions nécessitant une attention particulière dans le trading programmatique :
Produits secs de base - détails et réflexions sur le trading automatisé en temps réel des systèmes de trading quantitatifs (1. Problèmes et difficultés)
Système de trading quantitatif - Détails et réflexions sur l'offre ferme automatisée (2. Objectif de l'offre ferme)
Ici, nous continuerons à parler de certaines compétences de gestion détaillées dans la conception de code.
base de données
Comme mentionné dans les deux articles précédents, l’enregistrement du statut d’une combinaison de stratégies plus complexe est très important et nécessite l’utilisation d’une base de données.
En fait, la plupart des entreprises de programmation peuvent être classées dans la catégorie CRUD, c'est-à-dire que le processus principal consiste simplement à ajouter, supprimer, modifier et vérifier la base de données. Les codes commerciaux ne font pas exception. Le comportement commercial sur le marché secondaire à moyenne et basse fréquence n'est en fait pas très différent de celui où les gens achètent et vendent un certain trésor. L'objectif du trading automatisé réside dans la gestion du statut stratégique.
Si vous n'êtes pas déjà familier avec les bases de données relationnelles telles que SQL, il est recommandé d'apprendre directement à utiliser les bases de données NoSQL en mémoire telles que Redis. Ses avantages sont qu'il est facile à démarrer, qu'il offre d'excellentes performances et qu'il est intrinsèquement monothread. Il n'est pas nécessaire d'envisager des opérations de bas niveau telles que le verrouillage des données lors de la lecture et de l'écriture. Cependant, l'inconvénient est qu'il n'y a pas de clé primaire et que des fonctions telles que l'incrémentation automatique du numéro ne peuvent pas être réalisées. Si nécessaire, vous devez écrire du code pour l'implémenter vous-même. Cependant, je n’ai jamais utilisé cette fonction dans le trading automatisé depuis aussi longtemps.
Un autre problème sans importance est que pour les bases de données en mémoire, si la quantité de données à stocker est relativement importante, la mémoire du serveur doit être plus grande. Cependant, pour le trading quantitatif général, 4 Go ou même 2 Go de mémoire suffisent. pas nécessaire. Enregistrez autant de données.
Redis est vraiment puissant dans le monde réel. Si votre stratégie a des exigences de haute fréquence, elle peut également implémenter le modèle d'abonnement aux messages pub/sub, éliminant ainsi le besoin d'ajouter divers modules MQ supplémentaires. Si vous utilisez une base de données relationnelle comme MySQL, comme mentionné précédemment, tant que vous ne l'avez pas utilisée en pratique auparavant, vous devrez investir du temps et de l'énergie dans l'apprentissage de SQL, un langage de programmation relativement dégoûtant et difficile. Notez que tout le monde est là pour faire du trading quantitatif, pas pour apprendre à écrire du code. Essayez d'utiliser une solution plus simple.
De plus, si vous souhaitez créer un centre de marché, compte tenu des performances, vous utiliserez également la base de données Redis et coopérerez avec la file d'attente de messages pour plus de commodité. La solution est simple et adaptée à la plupart des scénarios. Un serveur (ou plusieurs serveurs) peut être utilisé.
conception de codes
Fondamentalement, lors de l’écriture de code, la structure de données de base est la plus importante. La conception de la structure des données n'est pas assez raisonnable et le code sera écrit de manière maladroite, car cela entraînera inévitablement le couplage des différents modules, ce qui rendra les modifications très gênantes. Mais pour le concevoir correctement, vous avez besoin d’une certaine expérience commerciale, c’est-à-dire d’une expérience commerciale. Tout cela concerne la façon d’écrire du code, il n’y a pas grand chose à dire. Les stratégies de chacun sont différentes et ne peuvent pas être traitées de la même manière. Toutefois, certains principes sont probablement les mêmes.
Par exemple, une fois qu'un ordre est soumis, il n'y a aucune garantie de succès, même s'il s'agit d'un ordre au marché, car il peut être rejeté par la bourse. Par exemple, l'échange est trop occupé ou une perte temporaire de paquets de données réseau se produit. Ensuite, il est préférable de concevoir des états intermédiaires similaires à la validation en 2 phases. S'il échoue, continuez à essayer (bien sûr pas trop fréquemment, sinon il sera banni s'il dépasse la limite. Il existe un décorateur de nouvelle tentative spécial pour ce faire). , ou ajoutez plus de méthode A pour corriger l'état d'erreur.
Dans des circonstances normales, même si la bourse est en baisse, elle se redressera en peu de temps. Si vous ne récupérez pas, une partie sera complètement indisponible, soit l'échange, soit votre propre serveur de codes. Cela doit être surveillé et alerté. Il est impossible que le code automatisé couvre tout. S'il ne peut pas être traité automatiquement, une alarme sera émise. Si le traitement manuel n'est pas traité à temps, tant que nous ne continuons pas à ouvrir des positions pour augmenter l'exposition, le problème ne sera pas trop grave, car il existe des ordres stop-loss algorithmiques pour couvrir le fond.
Voici une logique d’ouverture de stratégie que j’ai définie moi-même :
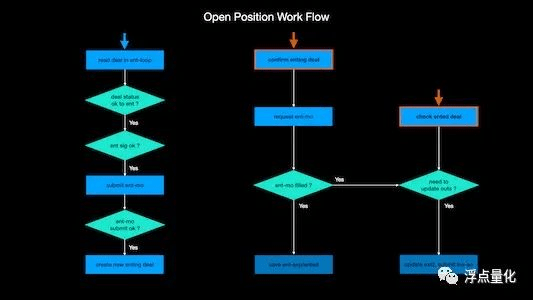
Fondamentalement, en dessinant un organigramme similaire, le code sera beaucoup plus organisé et le nombre de bugs potentiels sera réduit. Par conséquent, avant d’écrire du code, il est préférable de dessiner un organigramme ou de le trier lors de l’écriture, afin que la logique soit claire et que vous ayez une idée.
La logique de clôture d'une position est beaucoup plus compliquée que cela, car il existe davantage de conditions pour clôturer une position, telles que le stop-profit, le stop-loss et les signaux de sortie de diverses stratégies, qui déclencheront la clôture de la position. Bref, l'importance de la sortie est supérieure à celle de l'entrée, et l'offre réelle est aussi un peu plus gênante.
Parce que la logique stratégique de chacun est définitivement différente, je n’entrerai pas dans les détails ici. L’essentiel est de redresser votre logique stratégique et d’éviter que diverses erreurs possibles ne se produisent.
Cependant, ceux-ci semblent compliqués, et ce ne sont qu’un tas de if else (Python n’a même pas d’instruction switch). Si les conditions sont remplies, passez à l’étape suivante. Sinon, quittez.
contrôle du temps
Lors de transactions, le timing est sans aucun doute très important. Ici, je partagerai certaines de mes compétences en matière de contrôle du temps.
En programmation générale, si certaines tâches doivent être exécutées régulièrement, des packages de tâches cron tels que apscheduler sont généralement utilisés. Par exemple, planifiez une tâche planifiée pour détecter si le prix de la ligne K doit ouvrir ou fermer une position dès que l'heure arrive.
Ce type de package ouvre en fait un nouveau thread immédiatement à l'heure définie (peut être précis au deuxième niveau), puis exécute la tâche spécifiée. Le problème est que si le temps d'exécution de cette tâche est trop long, alors la tâche suivante. va recommencer. Il y aura des problèmes. Bien qu'ils puissent être résolus, ils sont plus gênants.
J'utilise généralement de telles tâches planifiées lorsque j'ai besoin de sortir régulièrement des informations de journal et d'effectuer une autocorrection et un autotest du programme, qui sont des fonctions basse fréquence qui peuvent être exécutées rapidement. Ces fonctions lisent uniquement les données de la base de données, et il n'y a aucune opération d'écriture ou de mise à jour, donc cela ne fait pas de mal de laisser apscheduler ouvrir un autre thread pour le traitement.
Cependant, la logique qui nécessite une interrogation constante et fréquente des prix du marché ou du statut de la politique locale n'est pas adaptée à un tel package de timing et doit être contrôlée par une boucle while.
Par exemple, si la stratégie utilise des signaux dans la barre de la ligne K, cela signifie que le signal peut apparaître à tout moment et que vous devez constamment vérifier le prix sous-jacent ou le volume des transactions pour déterminer si les opérations correspondantes doivent être effectuées. Si vous avez besoin d'un contrôle horaire plus précis à ce moment-là, par exemple, n'exécutez la logique de série d'ouverture d'une position que 10 secondes avant la fin de l'heure de la ligne k. Alors, comment pouvez-vous simplement juger si ce sont les 10 dernières secondes ?
J'ai pris le reste de 3600 en utilisant l'horodatage.
(Si vous n'êtes pas familier avec l'horodatage de l'ordinateur, c'est-à-dire l'horodatage, il commence à partir de l'heure moyenne de Greenwich 1970.1.1. Par exemple, il s'agit de la 1691240298ème seconde. Il n'y a aucun problème avec la précision de l'ordinateur à l'heure. niveau microseconde.)
Après avoir pris le reste de 3600, si le reste est supérieur à 3590 secondes, ce sont les dix dernières secondes. L'erreur peut descendre jusqu'au niveau de la milliseconde. Comme mentionné précédemment, il est préférable que les principales opérations de transaction soient exécutées séquentiellement dans un seul thread. De cette façon, le temps d'exécution peut être grossièrement contrôlé, ou la période peut être floue, ce qui ne posera aucun problème.
Ce type de contrôle nécessite que le réglage de l'heure de votre propre serveur ne s'écarte pas beaucoup de l'heure standard. Cependant, ce type de contrôle ne sera pas très précis, il ne pourra atteindre que le deuxième niveau. Cependant, Python ne peut pas contrôler le temps de manière très précise et ces fonctions de veille provoqueront des erreurs d'environ quelques microsecondes.
Réduire la fréquence d’accès aux API
Si vous avez adopté un centre de marché indépendant basé sur Websocket pour partager des informations publiques sur le marché telles que les lignes K entre différentes stratégies ou même différents codes de trading, il n'y a aucune inquiétude quant aux limites de fréquence des API à cet égard.
Mais nous devons également obtenir des informations sur les comptes en temps opportun, c'est-à-dire trois types d'informations : les fonds, les positions et les ordres. Bien que les informations du compte puissent également utiliser Websocket et attendre que le serveur Exchange les transmette activement, il est plus simple d'utiliser directement l'API restante pour trois raisons.
Premièrement, afin de réduire la charge sur les informations de compte transmises par Websocket, l'échange nécessite que l'échange se reconnecte ou mette à jour la ListenKey de temps en temps (Binance dure 60 minutes). Cette situation est évidemment plus difficile à maintenir. Bien que cela ne pose pas trop de problèmes, si vous hébergez des API et échangez plusieurs comptes en même temps, vous devez activer un programme distinct pour garantir l'exactitude des informations en temps réel, et la logique devient beaucoup plus compliquée.
Deuxièmement, certaines bourses ne disposent pas de Websocket pour les mises à jour des informations de compte. Dans ce cas, la logique de trading n'est pas universelle et il est plus difficile de changer de vrais codes de trading entre différentes bourses. Bien entendu, la plupart des gens ne négocieront pas sur plusieurs bourses et ne se retrouveront pas dans une telle situation.
Troisièmement, si le lien Websocket est rompu ou rencontre des problèmes tels que la mise à jour ou l'expiration de ListenKey mentionnés précédemment, si le programme ne le découvre pas à temps et qu'il se produit une transaction à ce moment-là, alors si vous comptez uniquement sur Websocket, cela entraînera une comparaison. Gros problème, car les informations de mise à jour du compte manquées ne seront plus repoussées. Pour éviter la possibilité de tels problèmes potentiels, vous devez également vous fier à l'API restante pour obtenir certaines informations de compte. Donc au final, nous devons nous appuyer sur rest api, n'est-ce pas inutile ?
En résumé, pour les transactions moyennes et basses fréquences, il est préférable d'utiliser directement rest api pour obtenir les informations du compte. Pour les sources de données importantes, il est préférable de suivre SSOT (Single Source Of Truth), sinon cela pourrait entraîner une confusion. Ce concept peut être recherché par vous-même et est très utile dans la programmation qui repose sur le traitement des données.
Ensuite, si vous utilisez uniquement l'API REST pour obtenir des informations sur le compte, vous pouvez conserver un tableau temporaire d'informations sur le compte dans la mémoire du code local, en particulier les fonds disponibles. Cela peut réduire les visites fréquentes à l'échange. La clé est d'être rapide et. vous pouvez envoyer toutes les commandes en même temps. Semblable au fait de passer des commandes par lots, puis de traiter lentement la logique derrière la mise à jour, plus la commande est passée rapidement, plus le glissement sera naturellement faible.
De plus, pour déterminer si l'ordre stop-loss algorithmique a été exécuté, vous pouvez utiliser les prix hauts et bas récents au lieu d'obtenir directement le statut de l'ordre en attente, car pour déterminer si l'ordre a été exécuté, vous devez interroger en continu, ce qui est relativement fréquent et entraînera de nombreux accès invalides à l'API. La mise à jour des prix K-line de websocket est très opportune et n'occupe pas la limite de fréquence de l'API.
De la même manière, certains ordres de sortie peuvent également être ainsi. Si votre signal de sortie repose sur le prix dans une barre, il peut être préférable d'utiliser les prix hauts et bas récents. Parce que parfois le prix se déclenche puis revient immédiatement, si votre fréquence de vérification n'est pas trop élevée, vous risquez de le manquer. Pour garantir la cohérence de votre stratégie de trading, vérifiez les hauts et les bas afin de ne pas manquer les prix. Cette approche présente l’avantage supplémentaire que le prix de transaction réel peut être plus favorable que le prix de déclenchement réel.
Je ne sais pas si les deux points ci-dessus sont faciles à comprendre. Cela peut nécessiter une réelle expérience.
J'aimerais partager une partie de mon expérience dans le développement de vrai code, en espérant que cela sera utile à tout le monde.