


2024.03.14
Présentation du projet
Lancé en juin dernier, Grass construit un réseau de web scraping décentralisé axé sur la transformation des données Web publiques en ensembles de données d'IA. Le réseau appartient et est exploité par les utilisateurs et constitue le moyen le plus simple pour quiconque d’interagir avec l’IA. Tout le monde peut créer rapidement son propre nœud Grass. Pour plus de détails, vous pouvez consulter le tutoriel publié par Goose auparavant. Vous pouvez également y jouer sur votre téléphone mobile !
À l'heure actuelle, le prix des Whales a atteint 4,6U/1 000 points sur et hors du marché. Dans des conditions de réseau de 75 %, un seul appareil IP peut extraire environ 50 000 points en un mois, soit 240U. Il y a longtemps, Goose vous a demandé d'exploiter le mien, mais beaucoup de gens étaient trop paresseux pour le faire. Maintenant, je vous dis que vous pouvez exploiter 240u avec votre ordinateur ou votre téléphone portable pendant un mois, à condition de raccrocher quelques unités supplémentaires. chez des parents et amis pendant le Nouvel An chinois, il y aura plusieurs 240u. Avez-vous un petit regret ? Si vous le regrettez, venez vite faire vos devoirs ! !
Grass prévoit actuellement de lancer le premier cumul de données de couche 2 sur SOL. Goose l'a spécialement divisé en une version trop longue à lire et une version d'article officielle que les amis peuvent lire et comprendre.
Trop long à regarder
Avant que Grass ne propose ce plan, il n'avait que le concept DEPIN plus IA, mais il envisage désormais de construire sa propre chaîne publique d'IA. Cela signifie que Grass s'est étendu à un autre modèle commercial complètement différent du précédent. Il a ajouté des fonctions de registre de données et des fonctions de processeur ZK à son activité simple précédente consistant à aider les entreprises d'IA à nettoyer les données. Une fois la couche 2 construite, son concept deviendra SOL+DEPIN+AI+le premier concept de cumul de données. Les quatre concepts sont superposés. Je ne dirai pas à quel point c'est précieux.
Tutoriel version PC :
https://weibo.com/ttarticle/p/show?id=2309404997006383775962
Tutoriel version mobile :
https://weibo.com/ttarticle/p/show?id=2309404998038614573232
positif
Grass : le premier cumul de données de couche 2 de l'histoire
Au cours des dernières semaines, nous avons publié du contenu pour expliquer le rôle de Grass dans la stack IA. Vous savez désormais que ce protocole remplit de nombreuses fonctions pour aider les constructeurs à accéder aux données du réseau pour entraîner leurs modèles. Il s’agit de la première étape critique du processus d’IA et du point de départ de tout développement.
Dans le cas de Grass, un ensemble de nœuds sont hébergés sur des appareils résidents, récupérant et traitant les données brutes du réseau. Il nettoie et transforme les données en ensembles de données structurés pour la formation en IA. Mieux encore, il capture les données du réseau d'une manière qui implique et récompense près d'un million de personnes dans le monde pour leur participation. Cela crée à lui seul une catégorie dans la fourniture de données d’IA, et c’est pourquoi certaines des plus grandes sociétés d’IA au monde choisissent de travailler avec nous. C'est la couche de données de l'IA.
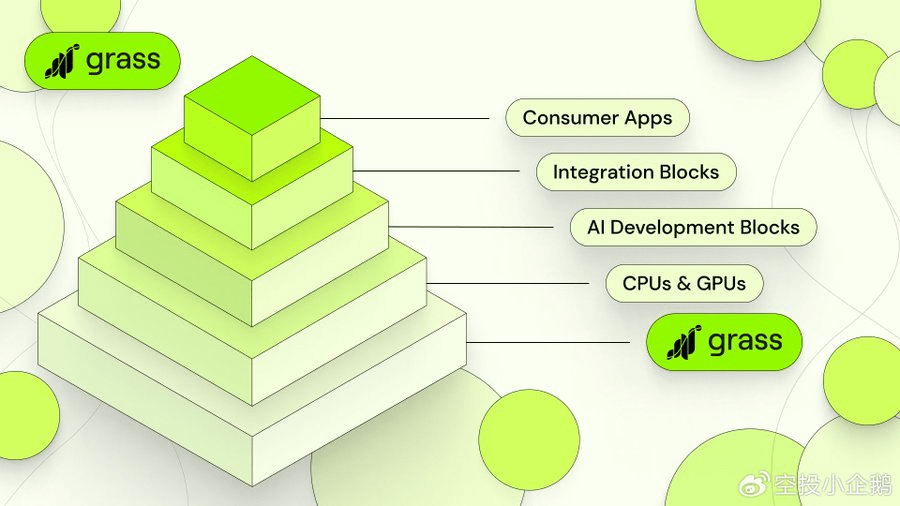
En attendant, nous avons passé les dernières semaines à réfléchir à l’état actuel de l’intelligence artificielle. Nous nous sommes demandé quels étaient les problèmes les plus urgents et que pouvons-nous faire pour les résoudre en tant que partie importante de l’infrastructure de l’IA.
Nous concluons que le plus gros problème auquel est confrontée l’IA aujourd’hui est le manque de transparence des données. Il suffit de regarder l'actualité et vous comprendrez. Demandez-vous pourquoi un modèle d’IA comparerait-il Elon Musk à Hitler ? Ou effacer des groupes ethniques entiers de l’histoire du monde ? Des données erronées ont-elles été utilisées pendant la formation ? Ou pire, utiliser de bonnes données qui donnent sélectivement de mauvaises réponses ?
La réponse est que nous ne le savons pas. Et nous ne le savons pas parce qu’il n’y a aucun moyen de le savoir. Nous ne savons pas sur quelles données ces modèles ont été formés car il n'existe aucun mécanisme pour le prouver. Les utilisateurs n’ont aucun moyen de vérifier l’origine des données, tout comme les constructeurs n’ont aucun moyen de les vérifier eux-mêmes.
C'est le problème que Grass prévoit de résoudre, et nous construisons actuellement un cumul de données de couche 2 pour résoudre ce problème. Comment, pourriez-vous demander ?
S'il vous plaît, permettez-nous de vous expliquer.
Couche Deux Comment créer des sources de données
Le monde a besoin d’un moyen de prouver la provenance des données d’entraînement de l’IA, et c’est ce que Grass construit actuellement. Bientôt, chaque fois que des données seront récupérées par un nœud Grass, des métadonnées seront enregistrées pour authentifier le site Web à partir duquel les données ont été récupérées. Ces métadonnées sont ensuite intégrées de manière permanente dans chaque ensemble de données, permettant aux constructeurs d'être totalement certains de leur provenance. Ils peuvent ensuite partager ce pedigree avec les utilisateurs, qui peuvent être assurés que le modèle d'IA avec lequel ils interagissent n'a pas été délibérément entraîné pour donner des réponses trompeuses.
Il s'agissait d'un effort important qui a nécessité des extensions majeures de notre protocole en vue d'étendre les opérations de scraping à des dizaines de millions de requêtes réseau par minute. Chaque demande nécessitera une validation, ce qui représentera un débit supérieur à celui que n'importe quel L1 peut fournir. C'est pourquoi nous avons annoncé notre intention de créer une solution de couche 2 pour gérer une mise à niveau majeure de nos capacités. Le L2 sera un rollup souverain, équipé d'un processeur ZK afin que les métadonnées puissent être regroupées pour validation et utilisées pour fournir une lignée persistante pour chaque ensemble de données que nous produisons. Cela est nécessaire pour permettre à la couche fondamentale de tout développement de l’IA de passer à l’étape suivante.
Les avantages de cette solution sont nombreux : cela protégera contre la pollution des données, renforcera l’IA open source et assurera la transparence des modèles avec lesquels nous interagissons quotidiennement.
Ensuite, nous décrivons la conception de base du système.
L'architecture de l'herbe
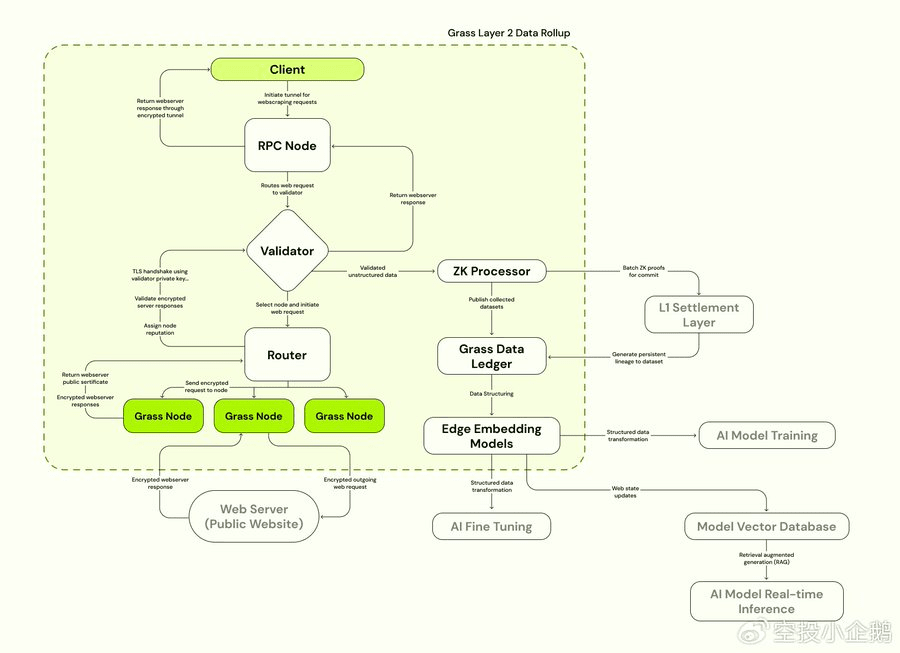
Le moyen le plus simple de comprendre ces mises à niveau est de consulter un graphique du cumul de données Grass. A gauche, entre le client et le serveur web, vous voyez le réseau de Grass, tel qu'il est traditionnellement défini. Le client fait une requête réseau, passe par le validateur et est finalement acheminé via le nœud Grass. Le serveur du site Web demandé par le client répondra à la demande du réseau, permettant à ses données d'être explorées et renvoyées sur la ligne. Les données seront ensuite nettoyées, traitées et préparées pour la formation de la prochaine génération de modèles d'IA.
Dans le diagramme L2, vous verrez deux ajouts majeurs à droite qui seront ajoutés avec le lancement de Grass's Sovereign Layer 2 : le Grass Data Ledger et le processeur ZK.
Ces deux éléments ont leurs propres fonctions, nous allons donc les expliquer une par une.
Grand livre de données sur l'herbe
Le registre des données est le lieu de stockage final de toutes les données sur Grass. Il s'agit d'un registre permanent de chaque ensemble de données analysé sur Grass, désormais doté de métadonnées intégrées pour enregistrer sa lignée depuis le moment de son origine. La preuve des métadonnées pour chaque ensemble de données sera stockée sur la couche de règlement de Solana, et les données de règlement elles-mêmes seront accessibles via le grand livre. Il est important que Grass dispose d'un endroit pour stocker les données qu'il récupère, même si nous y reviendrons sous peu.
Processeur ZK
Comme nous l'avons décrit ci-dessus, le but du processeur ZK est d'aider à documenter l'origine des ensembles de données récupérés sur le réseau Grass. Imaginez ce processus.
Lorsqu'un nœud du réseau - autrement dit un utilisateur utilisant l'extension Grass - envoie une requête réseau à un site Web donné, il renvoie une réponse cryptée contenant toutes les données demandées par le nœud. À toutes fins utiles, c'est le moment où notre ensemble de données est né et le moment d'origine qui doit être enregistré.
Et c’est exactement le moment que nous capturons lorsque nous enregistrons les métadonnées. Il contient de nombreux champs : la clé de session, l'URL du site Web exploré, l'adresse IP du site Web cible, l'horodatage de la transaction et bien sûr les données elles-mêmes. Ce sont toutes les informations nécessaires pour savoir sans l’ombre d’un doute qu’un ensemble de données particulier provient du site Web qu’il prétend être, et donc qu’un modèle d’IA particulier a été correctement – et fidèlement – entraîné.
Le rôle du processeur ZK est que ces données doivent être réglées en chaîne, mais nous ne voulons pas que toutes ces données soient visibles pour les validateurs Solana. De plus, le nombre de requêtes réseau effectuées sur Grass à l'avenir dépassera inévitablement les capacités de débit de n'importe quel L1, même un L1 aussi puissant que Solana. Grass va bientôt évoluer au point d'effectuer des dizaines de millions de requêtes réseau par minute, les métadonnées de chaque requête devant être réglées en chaîne. Il nous serait impossible de soumettre ces transactions à L1 sans que le processeur ZK fasse les preuves et les regroupe au préalable. Par conséquent, la L2 est le seul moyen possible d’atteindre les objectifs que nous nous sommes fixés.
Maintenant, pourquoi est-ce si grave ?
Avantages de la couche 2
registre de données
L’importance du registre de données est qu’il élève l’évolution de Grass vers un autre modèle commercial – et fondamentalement différent. Alors que le protocole continuera à surveiller les acheteurs qui envoient leurs propres requêtes réseau et récupèrent leurs propres données sur le Web, une part croissante de son activité concernera des données déjà stockées dans le grand livre. Grâce à cette capacité, Grass peut désormais récupérer stratégiquement des données pour la formation LLM et les héberger dans un référentiel de données en constante expansion.
Ce référentiel est la couche de données d'une pile d'IA modulaire, à partir de laquelle les constructeurs peuvent choisir des éléments de base pour former des modèles infiniment différents. Il s’agit essentiellement d’un modèle miniature d’Internet, fournissant des données de formation déjà structurées et prêtes à être ingérées par l’IA.
Processeur ZK
Nous avons expliqué en détail pourquoi les processeurs ZK sont importants. En nous permettant de créer des preuves de métadonnées qui documentent la provenance d'un ensemble de données Grass, il fournit un mécanisme permettant aux constructeurs et aux utilisateurs de vérifier qu'un modèle d'IA a bien été formé correctement. C’est en soi un gros problème.
Cependant, il y a une chose que nous n’avons pas mentionnée auparavant.
En plus d'enregistrer le site Web d'où provient l'ensemble de données, les métadonnées indiquent également les nœuds via lesquels l'ensemble de données a voyagé sur le réseau. Remarquablement, cela signifie que chaque fois qu'un nœud explore le réseau, il peut obtenir un crédit pour son travail sans révéler aucune information d'identification sur lui-même.
Maintenant, pourquoi est-ce important ?
Ceci est important car une fois que vous pouvez prouver quels nœuds ont fait quel travail, vous pouvez commencer à les récompenser proportionnellement. Certains nœuds ont plus de valeur que d’autres. Certains nœuds explorent plus de données que leurs pairs. Et ce sont exactement les nœuds que nous devons encourager pour poursuivre l’expansion rapide du réseau à laquelle nous avons assisté au cours des derniers mois. Nous pensons que ce mécanisme augmentera considérablement les récompenses pour les régions les plus nécessiteuses du monde, encourageant à terme les habitants de ces régions à s'inscrire et augmentant de manière exponentielle la capacité du réseau.
Inutile de dire que plus le réseau est grand, plus nos capacités d'exploration sont grandes et plus le référentiel de données réseau que nous stockons est grand. Une boucle de rétroaction positive se produira inévitablement, et plus de données signifieront que nous aurons davantage de données disponibles pour les laboratoires d'IA qui ont besoin de données de formation, ce qui incitera à une croissance continue du réseau.
en conclusion
Dans l’ensemble, la plupart des problèmes en suspens dans l’IA aujourd’hui proviennent d’un manque de visibilité sur la manière dont les modèles sont formés, ce qui, selon nous, peut être résolu en dotant l’IA open source de systèmes permettant de vérifier la provenance des données. Notre solution consiste à créer le tout premier cumul de données de couche 2, qui permettra d'introduire des mécanismes d'enregistrement des métadonnées de toutes les sources d'ensembles de données.
Les preuves ZK de ces données seront stockées sur la couche de règlement L1, tandis que les métadonnées elles-mêmes seront finalement liées à leurs ensembles de données sous-jacents, car les ensembles de données eux-mêmes sont stockés dans notre propre registre de données. Grass fournit une couche de données pour les piles d'IA modulaires, et ces développements apporteront une plus grande transparence et des récompenses aux fournisseurs de nœuds proportionnelles à la quantité de travail qu'ils effectuent.
Cette mise à jour devrait aider à communiquer certains de nos projets à venir et à clarifier la réflexion qui motive nos décisions. Nous sommes ravis de jouer un rôle pour rendre l’IA plus transparente et enthousiasmés par les nombreux cas d’utilisation futurs possibles de nos produits. Ces mises à niveau ouvriront de vastes opportunités aux développeurs, donc si vous ou votre équipe souhaitez construire sur Grass, veuillez nous contacter sur Discord. Merci pour votre soutien et restez à l'écoute.
Participez à la révolution de l’IA.