#sxt $SXT @SpaceandTime
La plupart des gens haussent encore les épaules quand on parle de Space and Time, comme s’il s’agissait d’un indexeur de plus déguisé en projet ZK. Moi aussi, au début.
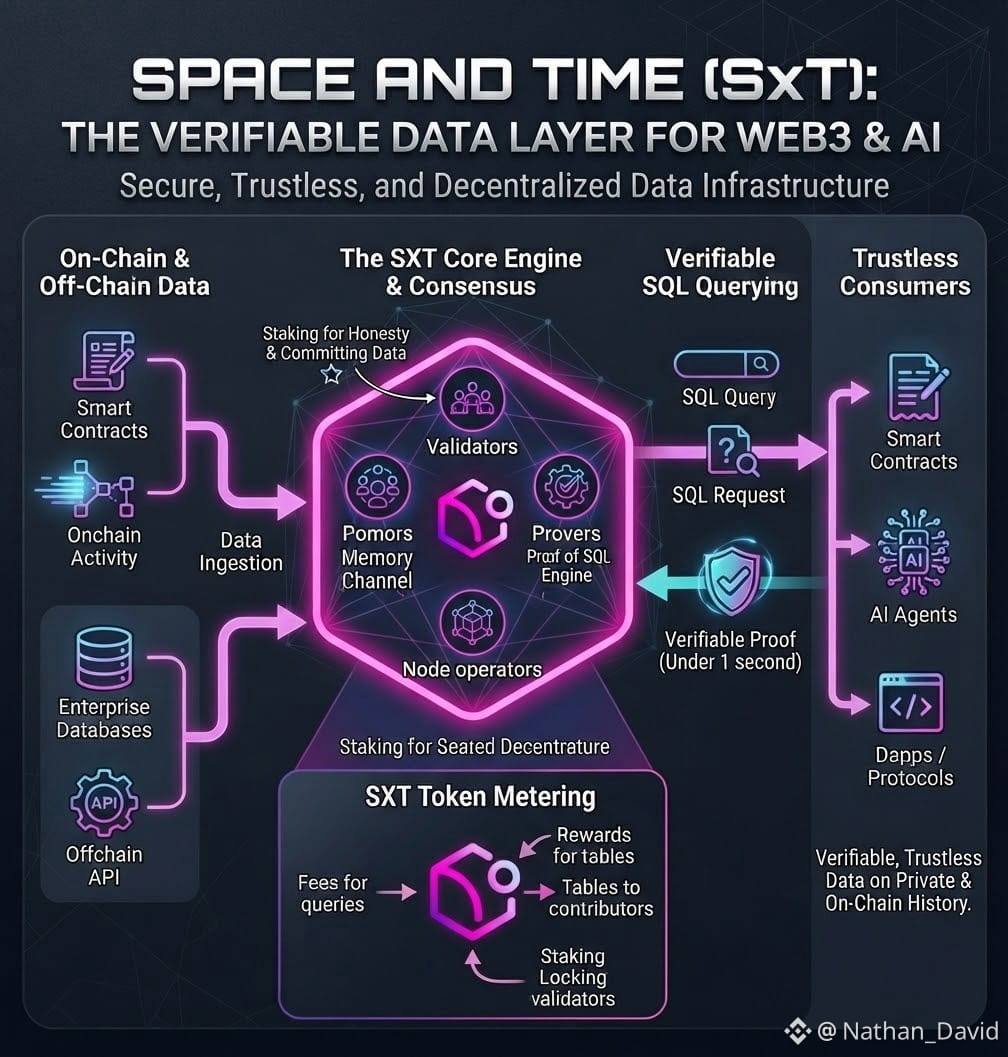
Ce qui compte vraiment est plus discret. La preuve SQL transforme essentiellement le réseau en une mémoire partagée à laquelle les contrats et les agents peuvent faire confiance, sans avoir à la surveiller constamment. Plus besoin de reconstruire sans cesse des oracles fragiles ni de payer un intermédiaire chaque fois qu’on a besoin de données historiques ou inter-chaînes. Lancez une requête SQL classique et obtenez une preuve en moins d’une seconde.
Les validateurs sécurisent les données, les prouveurs font le gros du travail, et $SXT reste au milieu, veillant à ce que tout le monde soit honnête et rémunéré.
Pour l’instant, le marché est encore occupé à courir après le prochain L2 ou le prochain récit purement axé sur l’IA, alors tout ça peut sembler lent. Mais dès que les agents commenceront à déplacer des montants importants et que les entreprises devront prouver des calculs sur des données privées sans divulguer toute leur base de données, cette couche de requêtes vérifiables cessera d’être facultative.
Toutes les dapps n’ont pas besoin de devenir des entreprises spécialisées dans les données. Elles ont simplement besoin d’un endroit fiable sur lequel s’appuyer.
J’ai vu assez de « projets axés sur les données » mourir discrètement parce que les incitations ne correspondaient jamais à une utilisation réelle.
Celui-ci me semble toujours différent. Le problème ne fera que prendre de l’ampleur à mesure que les activités on-chain se complexifieront. Rien de tape-à-l’œil. Juste le genre d’infrastructure qui finit par compter.
La plupart des gens haussent encore les épaules quand on parle de Space and Time, comme s’il s’agissait d’un indexeur de plus déguisé en projet ZK. Moi aussi, au début.
Ce qui compte vraiment est plus discret. La preuve SQL transforme essentiellement le réseau en une mémoire partagée à laquelle les contrats et les agents peuvent faire confiance, sans avoir à la surveiller constamment. Plus besoin de reconstruire sans cesse des oracles fragiles ni de payer un intermédiaire chaque fois qu’on a besoin de données historiques ou inter-chaînes. Lancez une requête SQL classique et obtenez une preuve en moins d’une seconde.
Les validateurs sécurisent les données, les prouveurs font le gros du travail, et $SXT reste au milieu, veillant à ce que tout le monde soit honnête et rémunéré.
Pour l’instant, le marché est encore occupé à courir après le prochain L2 ou le prochain récit purement axé sur l’IA, alors tout ça peut sembler lent. Mais dès que les agents commenceront à déplacer des montants importants et que les entreprises devront prouver des calculs sur des données privées sans divulguer toute leur base de données, cette couche de requêtes vérifiables cessera d’être facultative.
Toutes les dapps n’ont pas besoin de devenir des entreprises spécialisées dans les données. Elles ont simplement besoin d’un endroit fiable sur lequel s’appuyer.
J’ai vu assez de « projets axés sur les données » mourir discrètement parce que les incitations ne correspondaient jamais à une utilisation réelle.
Celui-ci me semble toujours différent. Le problème ne fera que prendre de l’ampleur à mesure que les activités on-chain se complexifieront. Rien de tape-à-l’œil. Juste le genre d’infrastructure qui finit par compter.