40 ans de saisie au clavier pour communiquer avec les ordinateurs, c’est bientôt fini. La prochaine décennie : les ordinateurs apprennent à écouter.
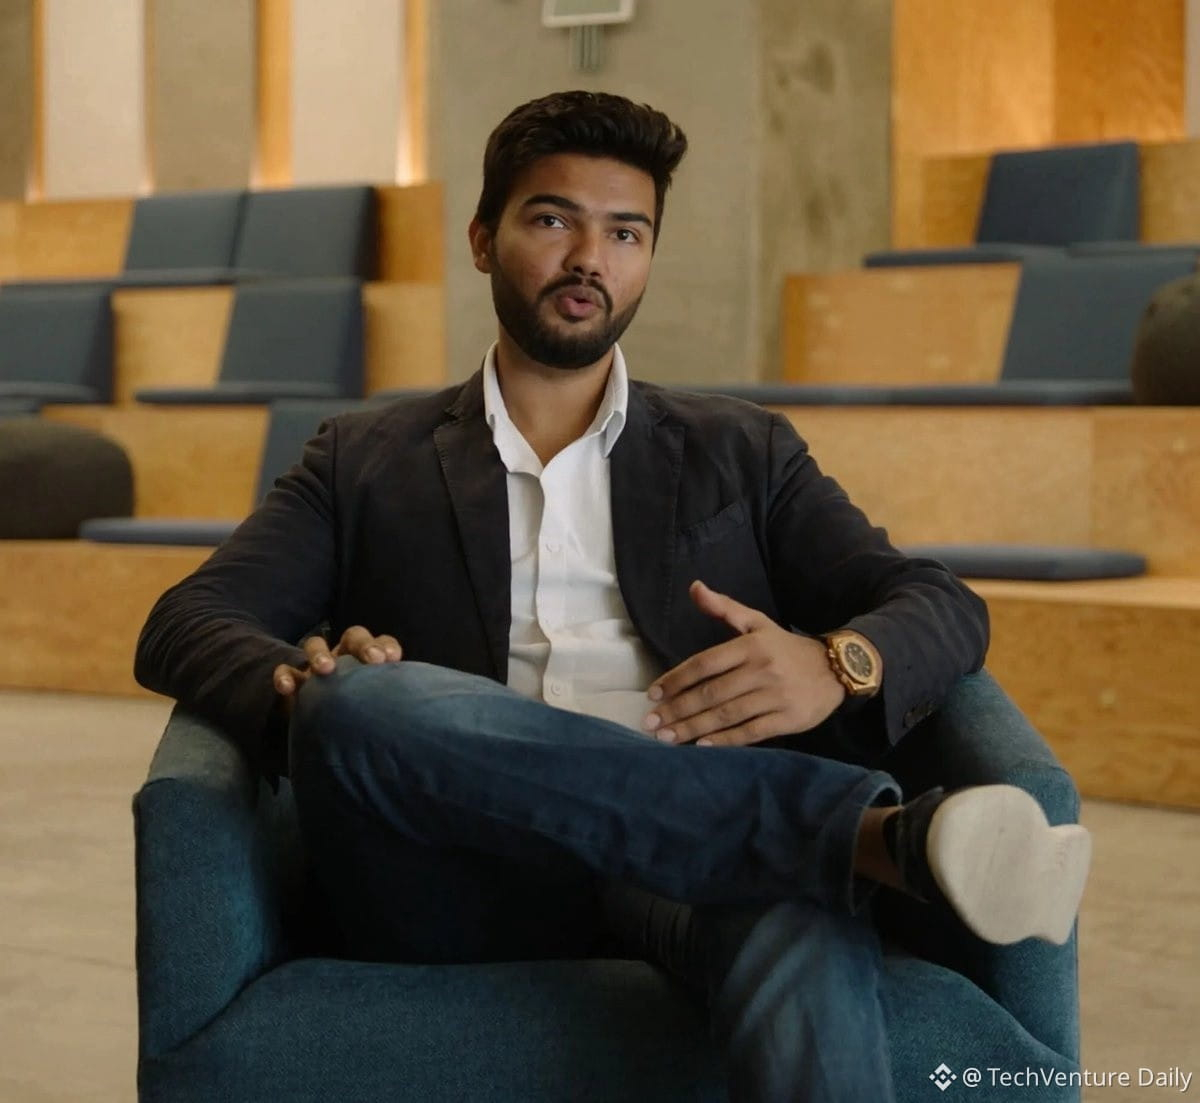
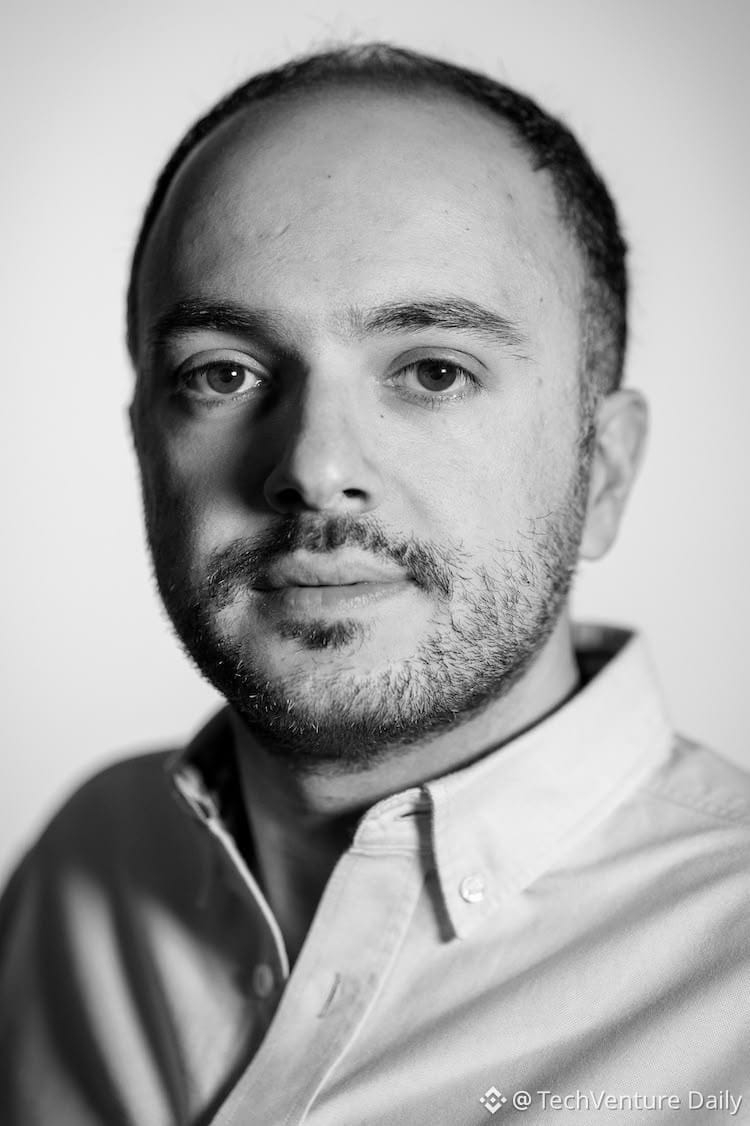
WisprFlow vient d’embaucher Ariya Rastrow au poste de directeur scientifique (ancien responsable de la technologie vocale d’Amazon Alexa, où il a fait passer l’équipe de 0 à 400 personnes). Il a lancé leur laboratoire de recherche il y a 4 mois.
Ils ont lancé le modèle vocal Canto 1 il y a 2 mois. Résultats en conditions réelles :
• Les utilisateurs sur ordinateur corrigent 13 % moins de dictées
• Les dictées sont 54 % plus rapides
• Le nombre de mots saisis chaque jour augmente de 7 %
• N° 1 cette semaine au classement des outils de dictée de voicearena_ai
La percée ne tient pas à la précision, mais à la confiance. Quand on cesse de modifier ce que le modèle transcrit, la saisie au clavier devient le goulot d’étranglement.
Les entreprises qui développent leurs propres modèles vocaux aujourd’hui contrôleront la couche d’interface vocale. WisprFlow prend de l’avance, alors que la plupart des développeurs s’appuient encore sur des API tierces.
WisprFlow vient d’embaucher Ariya Rastrow au poste de directeur scientifique (ancien responsable de la technologie vocale d’Amazon Alexa, où il a fait passer l’équipe de 0 à 400 personnes). Il a lancé leur laboratoire de recherche il y a 4 mois.
Ils ont lancé le modèle vocal Canto 1 il y a 2 mois. Résultats en conditions réelles :
• Les utilisateurs sur ordinateur corrigent 13 % moins de dictées
• Les dictées sont 54 % plus rapides
• Le nombre de mots saisis chaque jour augmente de 7 %
• N° 1 cette semaine au classement des outils de dictée de voicearena_ai
La percée ne tient pas à la précision, mais à la confiance. Quand on cesse de modifier ce que le modèle transcrit, la saisie au clavier devient le goulot d’étranglement.
Les entreprises qui développent leurs propres modèles vocaux aujourd’hui contrôleront la couche d’interface vocale. WisprFlow prend de l’avance, alors que la plupart des développeurs s’appuient encore sur des API tierces.